Deepgram 如何用 AWS Trainium 优化大规模语音 AI 推理
How Deepgram optimized voice AI at scale with AWS Trainium
Deepgram 与 AWS 合作,将其 Nova-3 语音转文字模型移植到 AWS Trainium2,用于联络中心分析、医疗转录等离线批量工作负载。团队基于 TorchNeuron 与 NKI 内核调优,最终在单台 EC2 trn2.3xlarge 实例上运行 8 个模型副本,批量转录场景下每美元处理的音频量提升 11–70%。
随着语音成为 AI 的一等模态,Deepgram 的模型覆盖了语音转文本、文本转语音和语音智能体。如今,它们每年为超过 200,000 名开发者和 1,400 家组织处理千万亿级别的音频 token。客户通过 Deepgram API 使用这些模型,或在自己的环境中运行它们,包括在 Amazon SageMaker AI 上。
对 Deepgram 而言,服务效率决定了在给定基础设施预算下系统能处理多少音频。大批量的批处理工作负载会给预算带来巨大压力,因此每个加速器小时的使用效率越高,Deepgram 就能在相同规模的集群上服务更多音频。这使得推理效率成为一个自然而然的目标,Deepgram 转向 AWS AI 芯片来提升效率。他们与 AWS 合作,将其 Nova-3 语音转文本模型移植到 AWS Trainium2 上,用于呼叫中心分析和医疗转录等离线批处理工作负载。
这项合作始于 Deepgram 以标准 PyTorch 代码交付 Nova-3。在接下来的几个月里,Deepgram 和 AWS 前线部署工程(FDE)团队将 Nova-3 以 PyTorch 重建的方式移植到 AWS Trainium2,并针对新硬件进行了调优。最终配置在单个 Amazon Elastic Compute Cloud(Amazon EC2)trn2.3xlarge 实例上运行八个模型副本。在 Deepgram 面向吞吐量的离线批处理工作负载上,该配置每美元处理的音频量比 Deepgram 之前使用的计算方案多出 11%–70%。我们在评估时使用当时的实例定价进行了测量。这些收益帮助 Deepgram 高效扩展、持续推出更好的模型,并以更低的价格交付给客户。这些收益也可以惠及在 Amazon SageMaker AI 上自有虚拟私有云(VPC)中自行托管 Deepgram 模型的客户。在那里,Deepgram 和 AWS 持续改进部署的易用性、可靠性和可观测性。
在这篇文章中,我们将带您了解 Trainium 上的完整推理优化工作:将 Nova-3 移植到 AWS Neuron 软件栈、随后的内核级调优、让 Deepgram 自有模型服务器调用 Trainium 的数据并行 Rust 运行时,以及我们在批量转录上测得的吞吐量和成本结果。
使用原生 PyTorch 将 Nova-3 优化到 Trainium2
从标准 PyTorch 代码出发,我们使用了 TorchNeuron,即 Neuron 编译器的原生 PyTorch 集成,它同时支持即时执行和 torch.compile。我们先在 Trainium2 上以即时模式运行 Nova-3,检查哪些算子回退到了 CPU,然后使用 torch.compile 进行编译。编译后的路径在 Trainium2 上运行所有模型算子,未检测到任何 CPU 回退。
我们使用 torch.compile 将编码器和解码器编译为独立的静态形状图。整个过程在两个层面检查数值精度:与 CPU 对比的层级别输出一致性,以及端到端的词错误率(WER),后者必须保持在 Deepgram 的参考值和目标范围内。
以这个可用的基线为起点,我们启动了优化工作,用公开的 NKI 库(NKILib)中的融合内核替换了若干层。NKILib 是一组用 Neuron Kernel Interface(NKI)编写的预构建参考内核。这些内核涵盖诸如融合 QKV 投影、融合前馈网络(FFN)层以及深度可分离一维卷积等算子。
我们针对吞吐量(进而针对成本效率)进行了优化,目标场景是 Deepgram 的离线推理工作负载。吞吐量以相对于基线配置的增益而非每秒处理的绝对音频时长来报告,我们对 1–128 的批量大小进行了遍历,以找到吞吐量最大的批量大小。
使用 Neuron Explorer 和 NAD 进行内核级调优
启用内核只是优化飞轮的第一步:启用一个 NKI 内核(自定义内核或来自 NKILib 的内核),对工作负载进行性能分析,然后根据分析洞察调整现有内核或用新内核替换它。这一循环不断重复,直到达到性能目标。在每一步中,Neuron 技术栈的不同部分都会加速工作:NKILib 提供开箱即用的替换内核,Neuron Explorer 是分析 Neuron 工作负载的首选工具,而 Neuron Agentic Development (NAD) 工具包则通过其性能分析和内核编写技能加速分析工作与内核调优。
在我们的案例中,NKILib 内核解决了大部分问题,而性能分析则指出了手写内核能做得更好的地方。每次,NAD 的性能分析技能都能让我们从 Neuron Explorer 的分析结果找到根本原因,而 NAD 的内核编写技能则帮助我们产出替换内核。
| 层 | 我们发现的问题及所做的更改 | 增益 |
| FFN | 参考内核的分块调度在处理每个 token 分块时都会从片外内存重新加载整套投影权重,因此随着 token 数量增长,内存带宽限制了吞吐量。我们手工调优的内核对每个权重分块只加载一次,在多个 token 分块间复用,并将权重读取与片上计算流水线化。 | 在批量大小为 96 时,相比参考内核延迟降低 2.0 倍 |
| Depthwise conv1d | NKILib 的实验性内核将该操作构建为隐式通用矩阵乘法(GEMM),导致 Tensor Engine 利用率偏低。我们将其重写为在 Vector Engine 上运行的广播乘加循环,达到引擎的满利用率,足以弥补 Vector Engine 较低的峰值吞吐量。 | 在批量大小为 96 时,相比参考内核提速 1.5 倍 |
| Conv2d | 模型的 conv2d 层遇到了编译瓶颈:批量大小超过 32 时,这些层导致模型无法编译为单一图。由于 NKILib 没有 conv2d 内核,我们用 NKI 从零开始编写了一个。该内核按照前述飞轮流程经历了多次基于性能分析结果的迭代,从而解锁了大于 32 的批量大小。 | 在批量大小 ≤32 时,卷积模块上最高提升 50 倍 |
Rust 实现的数据并行运行时
每个 Trainium2 设备具有八个物理 NeuronCore,默认以四个逻辑 NeuronCore(LNC2)的形式呈现。由于每个 Nova-3 模型实例可以轻松放入单个物理核心,我们将每个逻辑核心对应的物理核心数减少为一个(LNC1)。这一配置让我们能在每个 Trainium2 设备上托管八个模型副本(DP8)。输入被并发处理,同时最大化每台设备的吞吐量。数据并行运行时由一个工作窃取队列驱动,每个副本对应一个线程。
Deepgram 的生产服务栈是用 Rust 编写的,因此将 Nova-3 移植到 Trainium2 不仅仅是编译模型:服务路径中还必须在不依赖 Python 或 PyTorch 的情况下运行。为此,我们构建了一个轻量级运行时,由 Rust 通过共享的工作窃取队列来协调模型副本。一个 C 层通过 Neuron Runtime API 直接加载并执行提前编译的 Neuron 可执行文件格式(NEFF)(libnrt)。该运行时与 Deepgram 的服务架构直接集成,并在每个测试批次大小下都精确复现了参考 token 序列。
我们将其与多线程(MT)和多进程(MP)Python 数据并行运行时进行了基准对比。与 MP 基线相比,Rust 运行时完全消除了 Python 解释器的开销。与 MT 基线相比,它还进一步缓解了全局解释器锁(GIL)导致的串行化,使得并发工作线程的调度调用不再在单个进程内争用。这些收益之所以重要,是因为 Nova-3 对每个音频块执行一系列小的解码器调用,使得主机侧调度在低批次大小下成为瓶颈。因此吞吐量提升在那里最大,即使在吞吐量最大化的批次大小下也仍然可观。在该批次大小下,Rust 运行时相比多进程 Python 基线带来了 7.5% 的吞吐量提升。
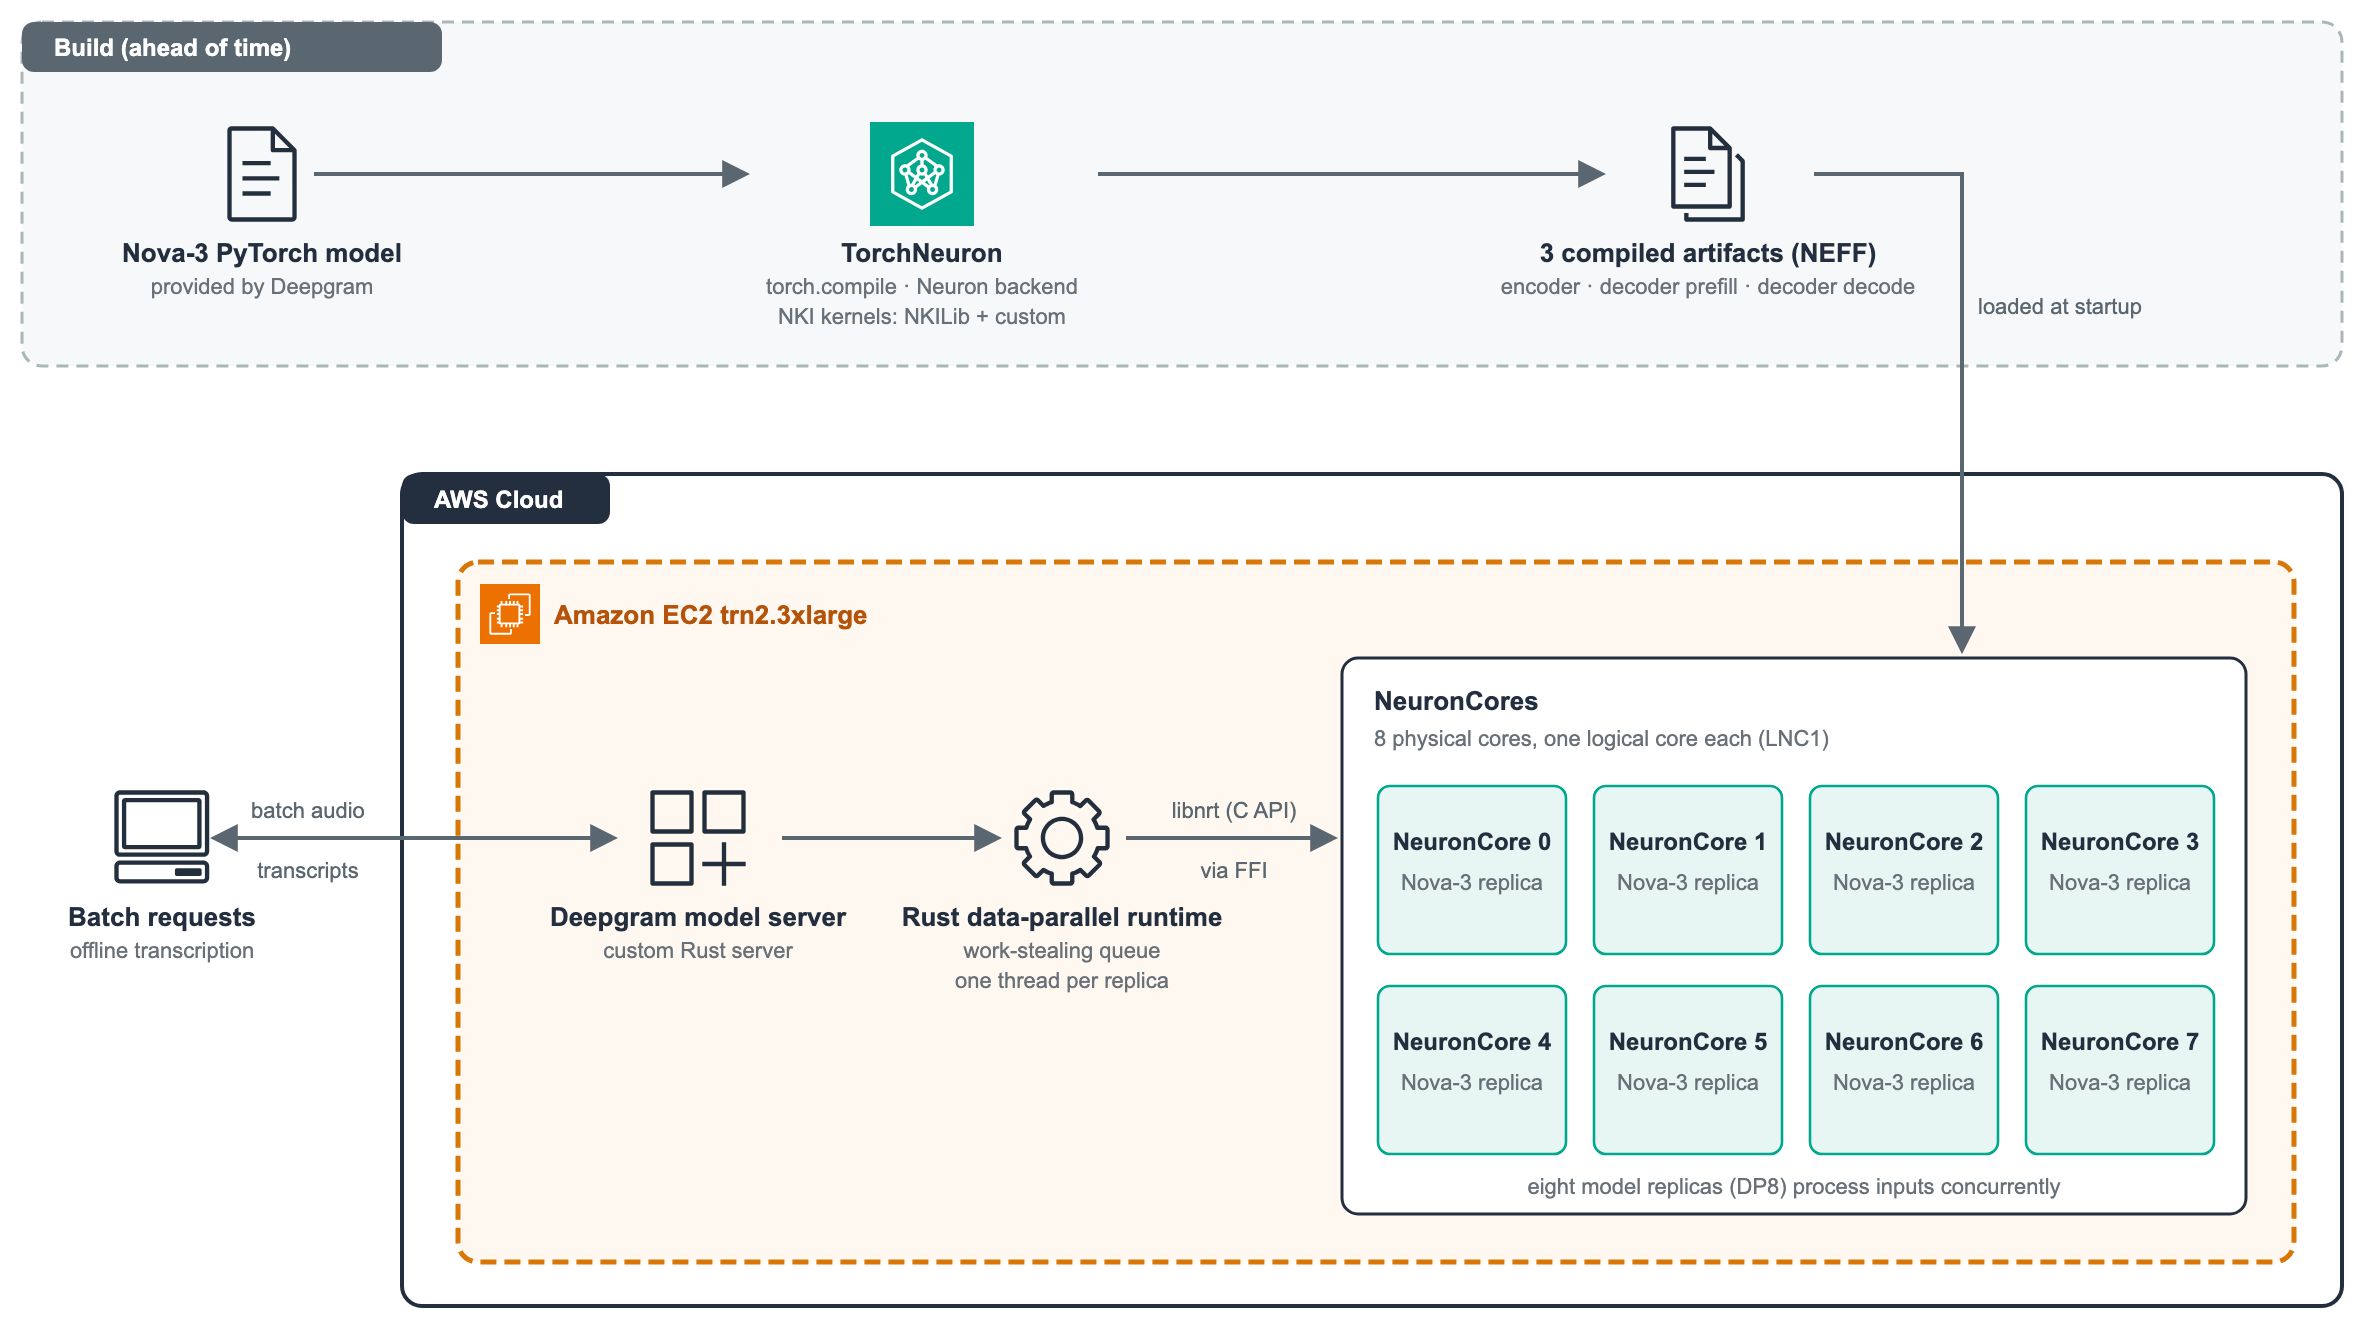
图 1:运行在 AWS Trainium2 上的 Deepgram Nova-3,提前编译并由 Rust 提供服务
成本节省影响
我们以每美元处理的音频量来衡量性价比。在 Deepgram 的离线、面向吞吐量的批量工作负载上,单设备 Trainium2 配置(trn2.3xlarge)每美元处理的音频量比 Deepgram 原先使用的计算选项多 11–70%。
结论
在这篇文章中,我们演示了 Deepgram 和 AWS FDE 如何使用 TorchNeuron 将 Nova-3 语音转文本 PyTorch 模型移植到 Trainium 硬件上,TorchNeuron 为 AWS Trainium 提供了原生 PyTorch 框架集成。我们通过直接用 NKILib 中的预构建内核替换层来提升性能。随后我们使用 Neuron Explorer 评估性能,并利用 Neuron Agentic Development(NAD)分析技能查询分析数据、加速性能排查。基于这些洞察,我们使用 NAD 内核编写技能对内核源码进行了适配。最后,我们为 AWS Trainium 构建了轻量级的 Rust 数据并行运行时,从 Rust 调用 Neuron Runtime API。我们的方案在离线、面向吞吐量的场景中展现了成本节省,验证了 AWS Trainium 是 Deepgram 推理工作负载可行且高效的选择。
要在自己的模型上尝试这种方法,请从 AWS Neuron 文档开始,其中涵盖了编译器、运行时和支持的框架。Neuron Kernel Interface(NKI)指南介绍了如何编写本文所述的内核,NKI 示例代码库则包含我们起步时参考的内核。Neuron 开发者工具文档涵盖了我们在此使用的分析和智能体工具,包括 Neuron Explorer 和 Neuron Agentic Development。有关实例规格和定价,请参阅 Amazon EC2 Trn2 Instances。如需规划类似的移植工作,请联系 AWS Forward Deployed Engineering。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com