Bayer Crop Science 如何基于 Amazon Bedrock AgentCore 与 AWS Unified Operations 构建智能体决策引擎
How Bayer Crop Science built an agentic decision engine on Amazon Bedrock AgentCore with AWS Unified Operations
Bayer Crop Science 在其机器学习工作流平台 Connected Decision Engine(CDE)之上构建了 Agentic Decision Engine(ADE),一个由监督智能体路由专家智能体的自然语言多智能体系统。
植物育种决策依赖于横跨基因组学、田间试验、图像、环境条件和模型输出的数据。拜耳作物科学(Bayer Crop Science)针对这些数据,在不同作物、地区和团队中运行数百种机器学习(ML)模型配置,且每次运行都需要可重复并受治理。为满足这一要求,拜耳构建了互联决策引擎(Connected Decision Engine,CDE),一个用于部署、编排、监控和复用 ML 工作流的系统。CDE 为育种专家、分析师、研究人员、数据科学家和数据工程师提供了一种一致的运行分析的方式,同时保留执行历史和运维控制。
随着采用规模的扩大,瓶颈从运行工作流转移到了理解工作流。解释一个结果意味着要从 API、文档、元数据存储、仪表盘和日志中拼凑上下文。想知道工作流为何失败、模型做了什么或结果来自哪里的用户,仍然需要知道该检查哪个系统。为弥合这一差距,拜耳构建了智能体决策引擎(Agentic Decision Engine,ADE),一个基于 CDE 的多智能体自然语言界面。一个监督智能体将每个问题路由给专门的智能体,专门智能体从相关系统检索上下文,用户无需浏览运维技术栈即可获得答案。在第一阶段,ADE 无需工程师介入即可解决约 80% 的用户问题。
ADE 运行在 Amazon Bedrock AgentCore 上,这是一项 AWS 服务,可以使用任何框架或模型大规模构建、连接和优化智能体。AgentCore 让团队专注于智能体行为,而无需构建和运维自己的智能体托管、会话隔离和工具访问层。三项 AgentCore 能力促成了这一选择:隔离每个用户会话的托管运行时,通过 AgentCore Gateway(Amazon Bedrock AgentCore 的一项功能)实现的由 AWS Identity and Access Management(IAM)限定范围的工具访问,它将身份验证和授权置于智能体代码之外;以及框架无关的设计,使团队能够使用自己的 LangGraph 编排和自选模型。
为准备上线并在之后运维 ADE,拜耳与 AWS Unified Operations 开展了合作。该合作提供了一名指定的技术客户经理(TAM)和一名生成式 AI 领域专家工程师(DSE),他们从设计到生产一直作为 ADE 团队的延伸开展工作。TAM 作为拜耳的战略顾问,对拜耳的运营模式和业务重点已有深入理解。DSE 则带来了 AWS 上的生成式 AI 领域专业知识。团队每周举行三次技术站会,进行评审并做出设计决策。DSE 建立了对 ADE 工作负载以及拜耳团队工作方式的深入了解,因此技术指导既反映了 AWS 服务的行为,也结合了拜耳的具体情境。本文记录了这一历程:ADE 架构、构建过程中做出的五项设计决策、为生产就绪所做的准备工作,以及上线后的运维方式。
架构概览
ADE 分为四层:用户体验、智能体编排、专家智能体,以及这些智能体调用的工具和数据源(图 1)。用户通过 React Web 前端访问 ADE,请求在到达智能体之前会经过一个用于 Microsoft Entra ID 的身份代理。GitHub Actions 构建智能体容器镜像,将其推送到 Amazon Elastic Container Registry(Amazon ECR),并部署到 Amazon Bedrock AgentCore 的一项功能 AgentCore runtime 上。
Amazon Bedrock AgentCore runtime 托管这些智能体,由于该 runtime 与框架无关,团队可以直接在其上运行自己基于 LangGraph 的编排。团队选择 LangGraph 是因为其显式的基于图的控制流以及针对多步骤工作流的检查点机制。LangGraph 负责编排工作流,由一个 Supervisor Agent 作为入口点,对每个请求进行分类、选择专家智能体,并在问题跨越多个领域时合并结果。数据平面按职责分离。Amazon DynamoDB 存储 LangGraph 检查点状态。Amazon Aurora PostgreSQL 存储会话记录、用户反馈和分析数据。Amazon ElastiCache 以生存时间(TTL)缓存智能体响应。Amazon Simple Storage Service(Amazon S3) 中的领域内容由 Amazon Titan Text Embeddings V2 进行嵌入,并在 Amazon OpenSearch Serverless 中建立索引,用于检索增强生成(RAG)。Amazon CloudWatch 采集运行时和应用遥测数据。AgentCore Gateway 将后端 API 以模型上下文协议(MCP)工具的形式暴露给智能体,并把身份验证和授权留在智能体代码之外。
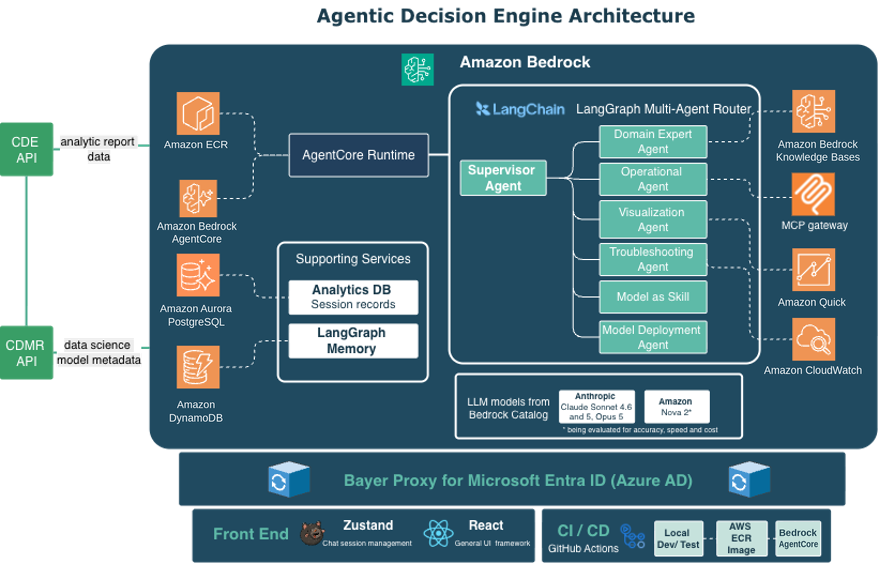
图 1:基于 Amazon Bedrock AgentCore 的 Agentic Decision Engine 架构
ADE 在生产环境中运行 22 个专家智能体,每个智能体专注于一个领域,并拥有各自的工具和数据源。例如,Domain Expert Agent 通过 RAG 回答概念性问题。Operational Agent 从 CDE 获取实时工作流状态和结果。Troubleshooting Agent 分析运行遥测数据。Visualization Agent 生成图表或返回现有仪表板。一个客户专属的 Models as Skill 模式将模型代码和文档转换为存储在中央注册表中的技能定义,使智能体能够基于模型的实际实现而非通用模型知识来回答模型相关的问题。
当育种专家询问“为什么我的表型分析工作流昨天失败了?”,Supervisor 会对意图进行分类并将请求路由给 Troubleshooting Agent。该智能体在 CloudWatch 中读取工作流的遥测数据,并通过 AgentCore Gateway 从 CDE API 获取其状态,确定故障点,然后通过 Supervisor 返回诊断结果(图 2)。育种专家无需直接搜索日志。借助 Troubleshooting Agent,曾经需要超过一小时的手动日志排查和等待工程师支持的诊断工作,现在只需不到 10 分钟。
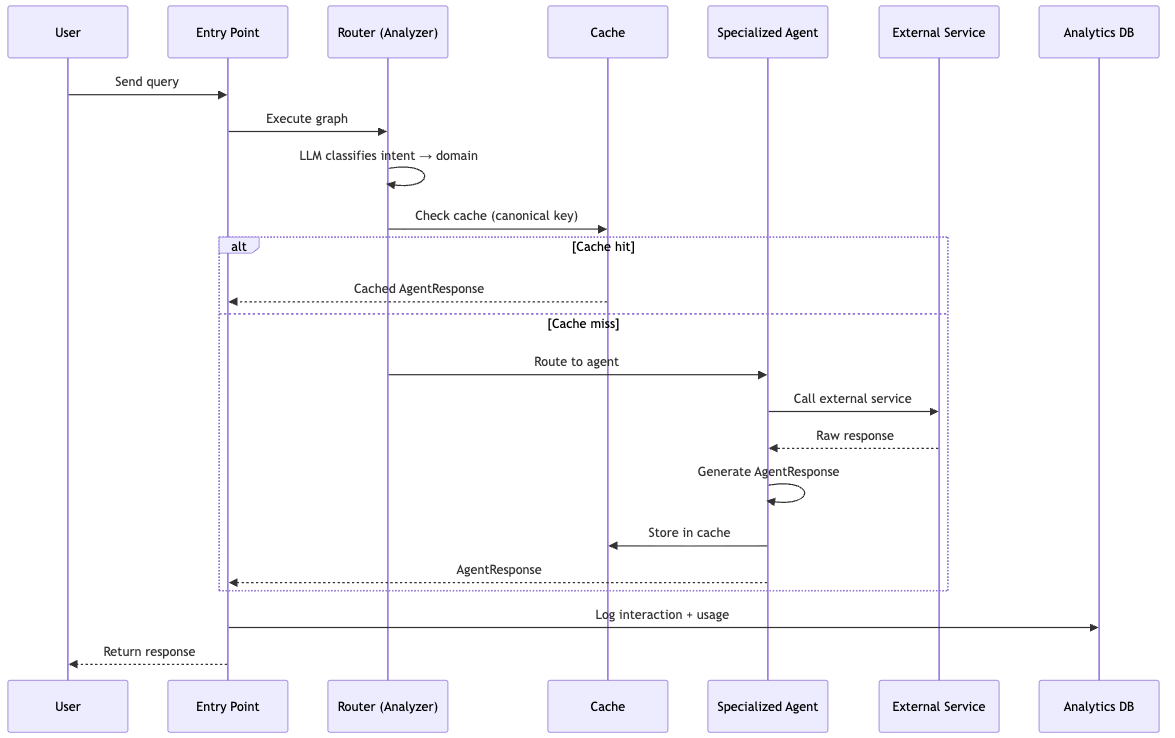
图 2:ADE 请求流程:意图分类、缓存查找、专家智能体路由和响应
走向生产之路上的五个设计决策
Unified Operations TAM 和 DSE 以工作团队成员的身份参与了以下决策,而不是事后才介入的升级处理点。这让 Bayer 在确定采用之前能够根据 AWS 服务行为检验每个设计,同时保持对架构的所有权和最终决定权。
1. 将编排状态外置,而不是把运行时视为无状态
AgentCore 运行时提供隔离会话,可在会话生命周期内的多次调用间保留执行上下文。但该上下文并不是多步骤工作流的持久化存储。ADE 将 LangGraph 检查点写入 DynamoDB,使图在扩容事件、重启或会话边界之后能够恢复执行,而无需依赖某个执行环境持续可用。
原则:将运行时会话用于活跃执行,并把恢复或重建工作流所需的状态持久化到一个持久化服务中。
Bayer 在用户身份方面统一使用 Microsoft Entra ID,而 ADE 的服务之间则使用 AWS 原生机制进行相互授权。团队没有强行在所有信任边界使用同一种令牌,而是为每个边界配备了各自的机制。
Entra ID 仍然是用户身份的来源。AWS Identity and Access Management(IAM)负责服务间调用的授权。AgentCore Gateway 的出站授权处理对下游 CDE 服务的访问。一个 AWS Lambda 请求拦截器函数执行自定义校验,并传递下游工具所需的授权属性。团队与 DSE 逐跳梳理了令牌契约。
原则:智能体系统中的身份故障往往集中在用户身份、智能体身份和工具身份之间的转换处。在每一跳都明确签发者、受众、声明、作用域和凭证有效期,而不是把在某个边界有效的令牌直接复用到下一个边界。
3. 把模型选择当作接口契约
在构建过程中,团队评估了启用了推理模式的较新模型版本。对于该版本,ADE 所依赖的工具调用与结构化输出的组合与其智能体的实现方式不兼容。DSE 确认了这一限制,团队因此在发布时保留了当前模型。
原则:对于使用工具的智能体,模型选择受限于完整的接口:工具调用、结构化输出、流式行为、推理功能、延迟、配额可用性以及模型特有的请求语义。较新的模型并不一定能直接替换。
4. 在工具面控制你之前,先控制它
CDE 管理着 500 多个模型配置。为每个 API 单独部署一个 MCP 服务器会带来部署、认证和版本管理的开销。ADE 改为将 OpenAPI 规范注册到 AgentCore Gateway,由它把 REST 操作暴露为 MCP 工具。新增或修改 API 变成了模式和网关配置的改动,而无需部署新服务器。
工具的模式和描述也会消耗输入令牌,并与用户请求和检索到的上下文争夺空间。ADE 按专业智能体划分工具范围,而不是让每个智能体都获得完整目录。对于较大的目录,AgentCore Gateway 支持语义化工具搜索,使智能体无需在每一轮都加载整个目录就能找到相关工具。
原则:按智能体限定工具目录范围。每一个工具定义都会增加令牌消耗,并扩大模型的决策空间。
5. 将复杂能力从工具提升为智能体
可视化最初是作为被其他智能体调用的工具。随着它不断成长,它需要自己的数据检索、图表选择逻辑、重试、错误处理,以及决定是生成图表还是返回现有仪表板。团队将其升级为一个专门的可视化智能体。该智能体在 AgentCore Code Interpreter(Amazon Bedrock AgentCore 的一项功能,提供沙盒化代码执行环境)中使用 matplotlib 和 Plotly 按需生成图表,并通过 Amazon S3 与之交换数据。当预构建的仪表板是更好的答案时,该智能体会返回现有的 Amazon Quick 或 Power BI 资产。
原则:工具执行的是有边界的操作。当某项能力开始拥有状态、重试、规划、策略或展示决策时,就应将其建模为智能体。
为 ADE 上线做准备
随着构建工作接近发布,重点从设计转向了可运维性:检测智能体故障、归因推理成本以及强化部署。
可观测性:衡量任务失败,而不仅仅是异常
监督者架构会将一个用户请求转化为一系列模型调用、工具调用和智能体交接。即使每个 HTTP 请求都成功了,最终答案也可能是错的。ADE 直接遇到了这个问题:应用程序的异常处理器捕获了智能体错误并返回的响应,监控却将其计为成功。在用 DSE 复现该问题后,团队在失败路径中添加了自定义 CloudWatch 指标,并针对智能体特定条件设置了告警:工具调用错误、限流、模型超时以及结构化输出验证失败。追踪和调用日志会跟踪每个请求在监督者和各专门智能体之间的流转。
原则:要区分传输成功与任务成功。智能体可观测性应当展示任务是否完成、哪个智能体或工具改变了结果,以及响应是否使用了预期的数据源。
成本归因:将计费归因与请求级遥测相结合
一个 ADE 请求可能调用多个模型和工具,因此账户级的 Amazon Bedrock 支出无法解释单位经济效益。团队借助 DSE 设计了归因方案,使用了回答不同问题的三种机制。Amazon Bedrock 应用程序推理配置文件将计费的模型使用归因到某个应用程序或工作负载。请求元数据和模型调用日志将 token 使用量与特定的智能体、功能或请求关联起来。IAM 主体归因则增加了身份维度。三者结合,团队得以估算每次交互的成本、识别昂贵的智能体,并确定是提示词、检索到的上下文还是工具定义在驱动 token 消耗。实践中,依赖 MCP 工具和多次工具调用的可视化智能体和运维智能体消耗的 token 最多。
同样的遥测数据在上线准备期间发现了一个工作负载,它有大量重复的输入前缀,却没有任何提示词缓存活动。对于支持的模型,将稳定的指令和工具定义放在可缓存的提示词前缀中,可以减少重复的输入处理,从而降低延迟和 token 成本。对 ADE 而言,缓存稳定的提示词前缀使输入 token 成本降低了 20–30%。
安全与上线准备就绪
IAM 角色按各智能体的职责进行权限划分。故障排除智能体(Troubleshooting Agent)可以读取诊断所需的运维数据,但不能修改工作流。领域专家智能体(Domain Expert Agent)可以查询其检索索引,但不能调用无关的 CDE API。在目前的生产环境中,ADE 的智能体响应受到最小权限原则、按智能体划分的只读工具访问权限、智能体响应的结构化输出校验的约束,并且其回答基于检索到的 CDE 数据和遥测信息,而非开放式生成。Bayer 还计划评估 Amazon Bedrock Guardrails,作为这些控制措施的额外一层,与 CDE 多轮对话工作流中已有的自定义安全检查形成互补。
上线前,Unified Operations 与 ADE 团队一起进行了关键工作负载审查(Critical Workload Review)和生成式 AI 视角(Generative AI Lens)的 Well-Architected 评审。由于 DSE 已经熟悉该工作负载,两项评审都聚焦于 ADE 特有的故障模式、容量风险和部署缺口,而非泛泛的最佳实践。发现的问题包括:监督智能体与专家智能体之间缺乏故障可见性、容器镜像标签可变、镜像可追溯性有限,以及缺少漏洞扫描。团队随后采取了更强化的告警、不可变的版本化镜像、Amazon ECR 的推送时扫描,以及针对未使用镜像的生命周期策略等措施。
DSE 还与团队一起审查了扩展和配额需求。负载测试既验证了应用程序,也验证了其服务配额,并暴露出一种返回空响应的网络故障模式,团队在生产活动之前修复了该问题。到上线时,团队已通过 Unified Operations 跟踪解决了 35 个阻碍项。
发布、运营与后续步骤
Bayer 采用受限分组的方式发布 ADE,而不是一次性向整个组织开放。自发布以来,Bayer Crop Science 已有超过 100 名用户使用 ADE,包括育种人员、分析师、研究人员、数据科学家和工程师。除了其 22 个专家智能体之外,ADE 还提供约 20 个 API 工具,并可在扩展过程中托管第三方智能体。通过 AgentCore Gateway 而非为每个 API 部署专用服务器来开放这些 API,将每个 API 的集成开销降低了 99% 以上。在第一阶段,ADE 在没有工程师介入的情况下解决了约 80% 的用户问题。
CDE 仍然是受管控的分析执行层。ADE 在其之上增加了一层自然语言界面,因此用户无需了解每个底层系统的位置或接口,即可查询工作流状态、结果、模型行为和故障。
随后,合作从发布准备转向持续运营。DSE 持续与团队会面,因此问题分诊和运营评审可以从对 ADE 的既有了解出发,而无需重新熟悉。ADE 的关键 CloudWatch 告警(包括前文所述的智能体专属告警)已接入 AWS Incident Detection and Response。一旦告警触发,AWS Incident Management 工程师会在 5 分钟内介入,并从该工作负载的上下文出发,而非从零开始。在安全方面,AWS Security Incident Response 工程师在潜在或正在发生的安全事件期间为团队提供支持,因此 ADE 在运维和安全两类问题上都拥有 AWS 的监控和响应保障。
在智能体间通信已经就位的基础上,拜耳接下来将重点放在混合云智能体互操作性上。团队正在探索运行在不同环境中的智能体如何在没有人工配置的情况下相互发现并通信。
结论
拜耳并没有用 ADE 取代其分析平台,而是让 CDE 更易于查询和运维。大部分生产工作都在提示词之外:持久化状态、身份边界、工具作用域、任务级可观测性、成本归因以及上线准备。拜耳自主掌控了架构和其中的每一项决策。通过 AWS Unified Operations 与指定的 DSE 和 TAM 协作,团队在设计阶段就根据 AWS 服务行为检验了这些决策,并将同样的上下文延续到生产环境中。
要了解更多信息,请探索 Amazon Bedrock AgentCore、Amazon Bedrock 成本归因、AWS Well-Architected 生成式 AI 指南以及 AWS Unified Operations。
作者谨向 Sijie Shi、Jorge Gomes、Naveen Reddy、Iago Fonseca、Mateus Silva 和 Sushimitha Jarugula 致谢,感谢他们为 ADE 的设计、开发和发布做出的贡献。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com