用 EDB Postgres AI 与 Amazon Bedrock AgentCore 构建面向 Agentic AI 的语义层
Build a semantic layer for agentic AI with EDB Postgres AI and Amazon Bedrock AgentCore
AWS 机器学习博客演示如何用 EDB Postgres AI 与 Amazon Bedrock AgentCore 为 Agentic AI 构建语义层:AIDB 扩展把语义知识库(SemKB)嵌入运营 Postgres 数据库,通过 COMMENT 语句、外键连接图和 GRANT、行级安全治理,并经内置 MCP 端点注册到 AgentCore Gateway。
在这篇文章中,我们将展示如何使用 EDB Postgres AI 为智能体 AI 构建语义层。我们在 Amazon Bedrock AgentCore 上运行一个 Strands Agents 智能体,该智能体查询语义层来回答客户 360(C360)问题。本系列的早期文章使用 Stardog 的知识图谱、Denodo 的数据虚拟化平台、AtScale 的维度模型和 Strategy Mosaic 的关联模型构建了相同的 C360 模式。
EDB Postgres AI 通过 AIDB 扩展将语义层放入运营型 Postgres 数据库内部。业务含义以标准 Postgres COMMENT 语句的形式与数据存放在一起,联接图来自 Postgres 外键,而治理则通过 AIDB 自带的 模型上下文协议(MCP)端点使用 Postgres GRANT 和行级安全性。
阅读完本文后,你将了解:
- 如何在 Postgres 模式之上构建 AIDB 语义知识库(SemKB),
COMMENT ON语句和aidb.create_semantic_alias如何作为编写界面,以及外键如何被爬取为联接路径。 - 如何通过内置的 EDB MCP 端点向外部智能体开放 AIDB 工具目录,该端点由 应用负载均衡器(ALB)作为前端,并作为 MCP 目标注册到 AgentCore Gateway(Amazon Bedrock AgentCore 的一项功能)上。
- Postgres 角色、列级
GRANT语句和行级安全性如何为不同的调用者产生不同的结果。提示词、工具目录和智能体代码保持不变。 - AIDB 如何为每次 SQL 执行捕获 OpenTelemetry 追踪,并将其作为
aidb_otel模式中的行存储,可用普通 SQL 进行查询。
智能体需要的三个层
从实时数据回答业务问题的智能体需要三个层:一个负责规划并编写查询的模型层,一个告诉智能体数据含义的含义层,以及一个托管智能体并控制身份与访问的运行时层。本系列的 Stardog 文章介绍了这一框架。本文中的模型层是 Amazon Bedrock 上的 Anthropic Claude,与之前的文章相同(模型可用性因 AWS 区域而异)。运行时层是 AgentCore 运行时,它是 Amazon Bedrock AgentCore 的一项功能。AgentCore Gateway 处理入站授权,而 AgentCore Identity(Amazon Bedrock AgentCore 的一项功能)保存工具目标的出站凭证,与之前的文章相同。EDB Postgres AI 在数据库本身内部托管智能体和工具,并通过其 MCP 端点充当外部智能体的连接点。
含义层是本文与其他文章不同的地方。在这里,它是一个位于运营型 Postgres 数据库内部的 SemKB。模式与业务定义被一起编入索引。由 Postgres GRANT、行级安全性和列级授权来实施访问控制,而不是依靠建议性的系统提示词。接下来的章节将介绍 AIDB 如何构建这个层、AgentCore 如何将其开放出来,以及两个 Postgres 角色询问同一个问题时如何得到不同的答案。
示例用例:EDB Postgres AI 上的 C360
数据集是 Stardog C360 Knowledge Kit,被加载到一个专用 c360 模式下的单个 EDB Postgres AI 实例中。数据模型包含四张表和一个派生视图。
| 对象 | 关键列 |
customers |
cid, first_name, last_name, full_name, email, ssn, phone, picture, location(外键指向 locations.id) |
locations |
id, city, state, zip |
products |
id、name、brand、dept、price |
purchases |
id、cid(外键,关联 customers.cid)、pid(外键,关联 products.id)、date、quantity、price |
big_spender(视图) |
cid、full_name、state、large_orders、largest_order |
物理模式就是一个普通的 Postgres 连接图:customers 表中的一名客户住在某个 location,下了 purchases,每笔购买都引用一件商品。而语义层面的工作则建立在三个从列名上看不出来的业务概念之上。
州信息不在客户行上。它保存在 locations 中,通过 customers.location 外键关联,该列上的注释会告诉 SemKB 到哪里去找它。
purchases.price 记录的是订单总额。如果智能体把它当作单价并乘以 quantity,那么计算出的头号客户消费额将是 502,529 美元,而不是 27,991.66 美元。
大客户(Big spender)是业务方自己定义的术语。它以视图的形式通过一条 COMMENT ON VIEW 语句捕获,其定义保存在一处,供每个智能体、仪表板和查询读取。
我们让智能体端到端运行的问题如下:
- 按总消费额排名,我们的前 10 大客户是谁?他们各在哪个州?
- 每个州各有多少大客户?
- 你能列出 10 名客户以及他们各自所在的州吗?
- 哪些 10 种商品售出的件数最多?
- 你能列出 5 名客户及其社会保障号吗?(用于治理重测。)
参考架构
下图展示了从分析师经 Amazon Bedrock AgentCore 到 EDB Postgres AI 内部语义层的请求路径。分析师通过 Amazon Cognito 进行身份验证,并携带签发的 JSON Web Token (JWT) 作为 Bearer 令牌调用 AgentCore Gateway。Gateway 将请求路由到 AgentCore 运行时,后者使用 Amazon Bedrock 上的 Claude 进行规划。智能体通过 Gateway 调用 MCP 工具,Gateway 再将请求转发到 EDB Postgres AI 虚拟私有云(VPC)中的一个 Application Load Balancer,进而到达 AIDB 内部的 edb-endpoints MCP 服务器。AIDB 提供 SemKB、语义别名和只读 PostgreSQL 表。AgentCore 的追踪信息发送到 Amazon CloudWatch,AIDB 则将 OpenTelemetry 追踪记录捕获为 Postgres 内部 aidb_otel 模式中的行。
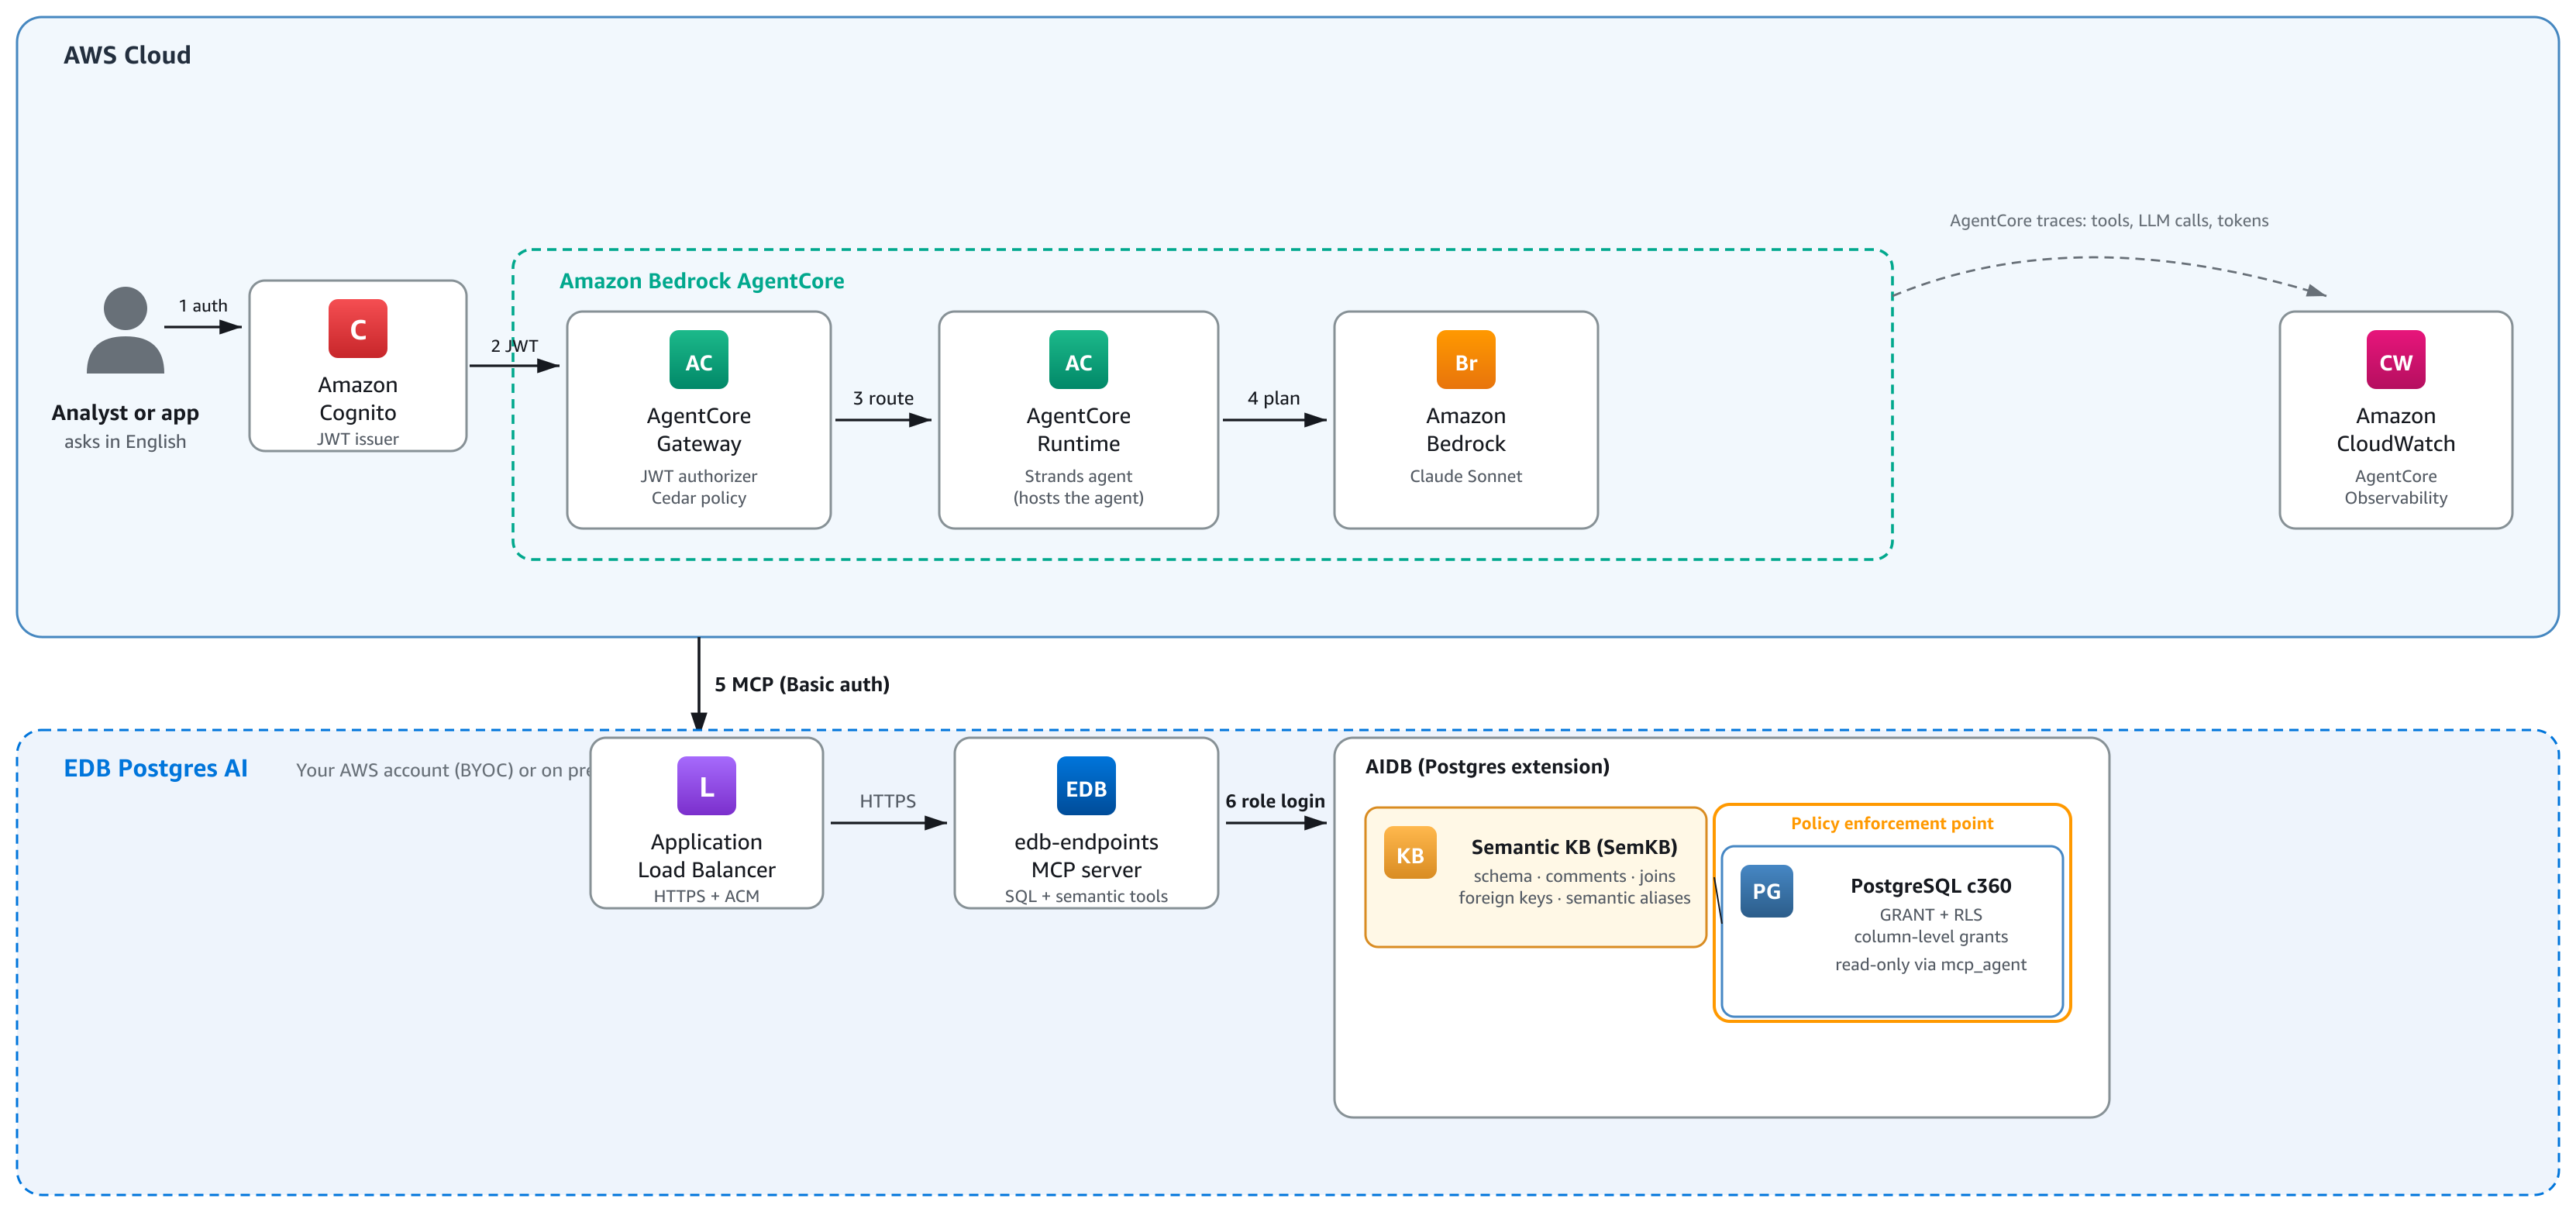
图 1:EDB Postgres AI 与 Amazon Bedrock AgentCore 的参考架构
两条流程跨越 AgentCore 与 EDB Postgres AI 之间的边界。
入站: 客户端携带由 Amazon Cognito 用户池签发的持有者令牌调用 AgentCore Gateway。Gateway 的 入站 JWT 授权器根据 Cognito 发现 URL 验证该令牌。随后 Gateway 依据令牌的声明评估其 Cedar 策略,决定代表该用户的这个智能体可以调用哪些工具。接着它将调用路由到 AgentCore 运行时。智能体调用 Amazon Bedrock 上的 Claude 进行规划和答案组装。
出站到语义层: 智能体的工具调用是一个 MCP 请求。AgentCore Gateway 直接支持 MCP 服务器目标。AIDB 的 edb-endpoints HTTP 服务器支持带 HTTP Basic 身份验证的可流式 HTTP MCP,这使得 Gateway 无需任何转换层即可将其视为 MCP 服务器目标。一个配有 HTTPS 监听器和 AWS Certificate Manager (ACM) 证书的 Application Load Balancer 位于 Amazon Elastic Compute Cloud (Amazon EC2) 实例上的 edb-endpoints 之前。ALB 的 URL 被注册为 Gateway 目标。AgentCore Identity 凭证提供程序保存着 Postgres 角色凭证,并在每次出站请求中将其作为 Basic 身份验证注入。智能体代码接触不到 Postgres 凭证。
可观测性: AgentCore 会为工具调用、大语言模型(LLM)调用以及 token 使用量生成跟踪数据,并发送到 CloudWatch Transaction Search。AIDB 会将 SQL 执行的 OpenTelemetry 跟踪数据捕获为 Postgres 中 aidb_otel 模式里的行,在数据库被配置为写入这些数据后,即可用普通 SQL 查询(参见 在源数据库上启用遥测)。
此架构无需 AWS Lambda。AIDB 本身已支持 MCP,因此 Gateway 通过 ALB 直接与它作为 MCP 服务器目标通信。本系列中 Denodo 的文章在其 MCP 服务器前端也采用了相同的 ALB 模式,此处的架构除供应商外没有任何变化。
构建语义层
以下步骤假设 EDB Postgres AI 实例上已安装并启用 AIDB,并且 Stardog C360 套件的四个 CSV 已加载到专用的 c360 模式中,同时具备前文所示的主键和外键。由于该层与数据位于同一数据库中,因此无需部署第二个系统,也无需同步目录。语义层用 SQL 定义,与写入数据行的应用程序位于同一数据库内。
AIDB 的语义知识库对 Postgres 模式而非数据进行索引。它将每个表、视图和列的定义(连同 COMMENT ON 文本)嵌入到向量存储中,智能体可以用自然语言进行搜索。有三项编写工作可帮助智能体按含义找到正确的表和列:编写 COMMENT ON 语句、将业务术语定义为带有各自注释的视图,以及将常见问题注册为语义别名。注释是三项编写工作中最简单的,也是对用户和智能体的文本到 SQL 准确率提升最大的。
COMMENT ON COLUMN c360.purchases.price IS
  'Total amount the customer paid for the entire order, in US dollars. Not the unit price.';
COMMENT ON COLUMN c360.purchases.cid IS
  'Customer who placed the order. Joins to customers.cid.';
COMMENT ON COLUMN c360.customers.location IS
  'Home address of the customer. Joins to locations.id. State is in locations.state.';
COMMENT ON COLUMN c360.customers.ssn IS
  'US Social Security number. Sensitive, column-level grant required.';

CREATE VIEW c360.big_spender AS
  SELECT c.cid, c.full_name, l.state,
         count(*)      AS large_orders,
         max(pu.price) AS largest_order
    FROM c360.purchases pu
    JOIN c360.customers c ON c.cid = pu.cid
    JOIN c360.locations l ON l.id  = c.location
   WHERE pu.price > 250
   GROUP BY c.cid, c.full_name, l.state;

COMMENT ON VIEW c360.big_spender IS
  'Big spenders. A big spender is a customer with at least one order over 250 US dollars. '
  'Use this view for any question about big spenders.';
该视图将业务定义集中在一处,因此任何智能体或仪表板都无需重新定义 big spender。你前期在注释上投入的时间,会在智能体后续运行的每次查询中得到回报。
创建语义知识库
在 c360 模式之上创建 SemKB。该调用会注册名称、嵌入模型、目标模式以及自动处理模式。
SELECT aidb.create_semantic_kb(
    name            => 'c360_kb',
    model           => 'bge-small-en-v1.5-f16',
    schemas         => ARRAY['c360'],
    auto_processing => 'Live'
);
嵌入模型是随 AIDB Amazon 系统映像(AMI)一同提供的本地 llama.cpp 模型(llamacpp_embeddings)。SemKB 为每个知识库使用一个嵌入模型,因此所有条目都位于同一向量空间中。AIDB AMI 自带一个名为 semkb 的默认 SemKB,作用于 public,因此创建 c360_kb 后实例上会有两个 SemKB。当存在多个 SemKB 时,每次 aidb.semantic_kb_search 调用都必须显式传入 kb_name。要将本地模型替换为远程嵌入模型,例如 Amazon Bedrock 上的 Amazon Titan Text Embeddings,请通过 aidb.create_model 注册远程模型,并将其名称作为 SemKB 的 model 参数传入。auto_processing 参数接受 Disabled、Live 或 Background。Live 通过 Postgres 事件触发器响应模式变更。Background 由工作进程异步处理这些变更。Disabled 则等待显式的 aidb.refresh_semantic_kb()。SemKB 还会同时抓取外键并转换为关系。purchases.cid 外键会变成一条连接路径,智能体可以按含义而非按列名来发现它。
将常见问题捕获为语义别名
语义别名是一个命名的、带参数的只读 SELECT,并带有自然语言描述,SemKB 会将其与模式元数据一同索引。智能体按含义找到它,传入参数进行调用,并返回一个受治理的答案。
SELECT aidb.create_semantic_alias(
    name        => 'big_spenders_by_state',
    description => 'Count big spenders grouped by state, ordered from most to fewest.',
    query_text  => $$SELECT state, count(*) AS big_spenders
                     FROM c360.big_spender
                     GROUP BY state
                     ORDER BY big_spenders DESC, state$$,
    params      => '[]'
);
别名(Alias)是 AIDB 可复用的 text-to-SQL 构建模块。它们在 SemKB 索引中与表和视图并列,并以工具的形式呈现给智能体。完整的 text-to-SQL 操作指南请参见 EDB 文档。
治理访问权限
在这一架构中,治理完全通过 Postgres 原语来实现。AIDB MCP 端点本身没有权限系统:“Postgres 授权决定每个智能体能运行什么”(MCP 端点参考)。每个 MCP 请求都通过独立的连接使用 Postgres 用户名和密码进行身份验证,因此每次工具调用中的 current_user 就是该智能体的角色,在 pg_stat_activity 中与其他连接一样可见。
下图展示了身份如何从最终用户经 AgentCore 流转到执行 SQL 的 Postgres 角色,以及由此产生的追踪记录如何被捕获用于审计。整个链路分四个阶段运行:Gateway 的入站信任、AgentCore Identity 的出站凭证、通过 GRANT 和行级安全在 Postgres 中实施强制控制,以及通过 aidb_otel 模式中的 OpenTelemetry 追踪进行审计。
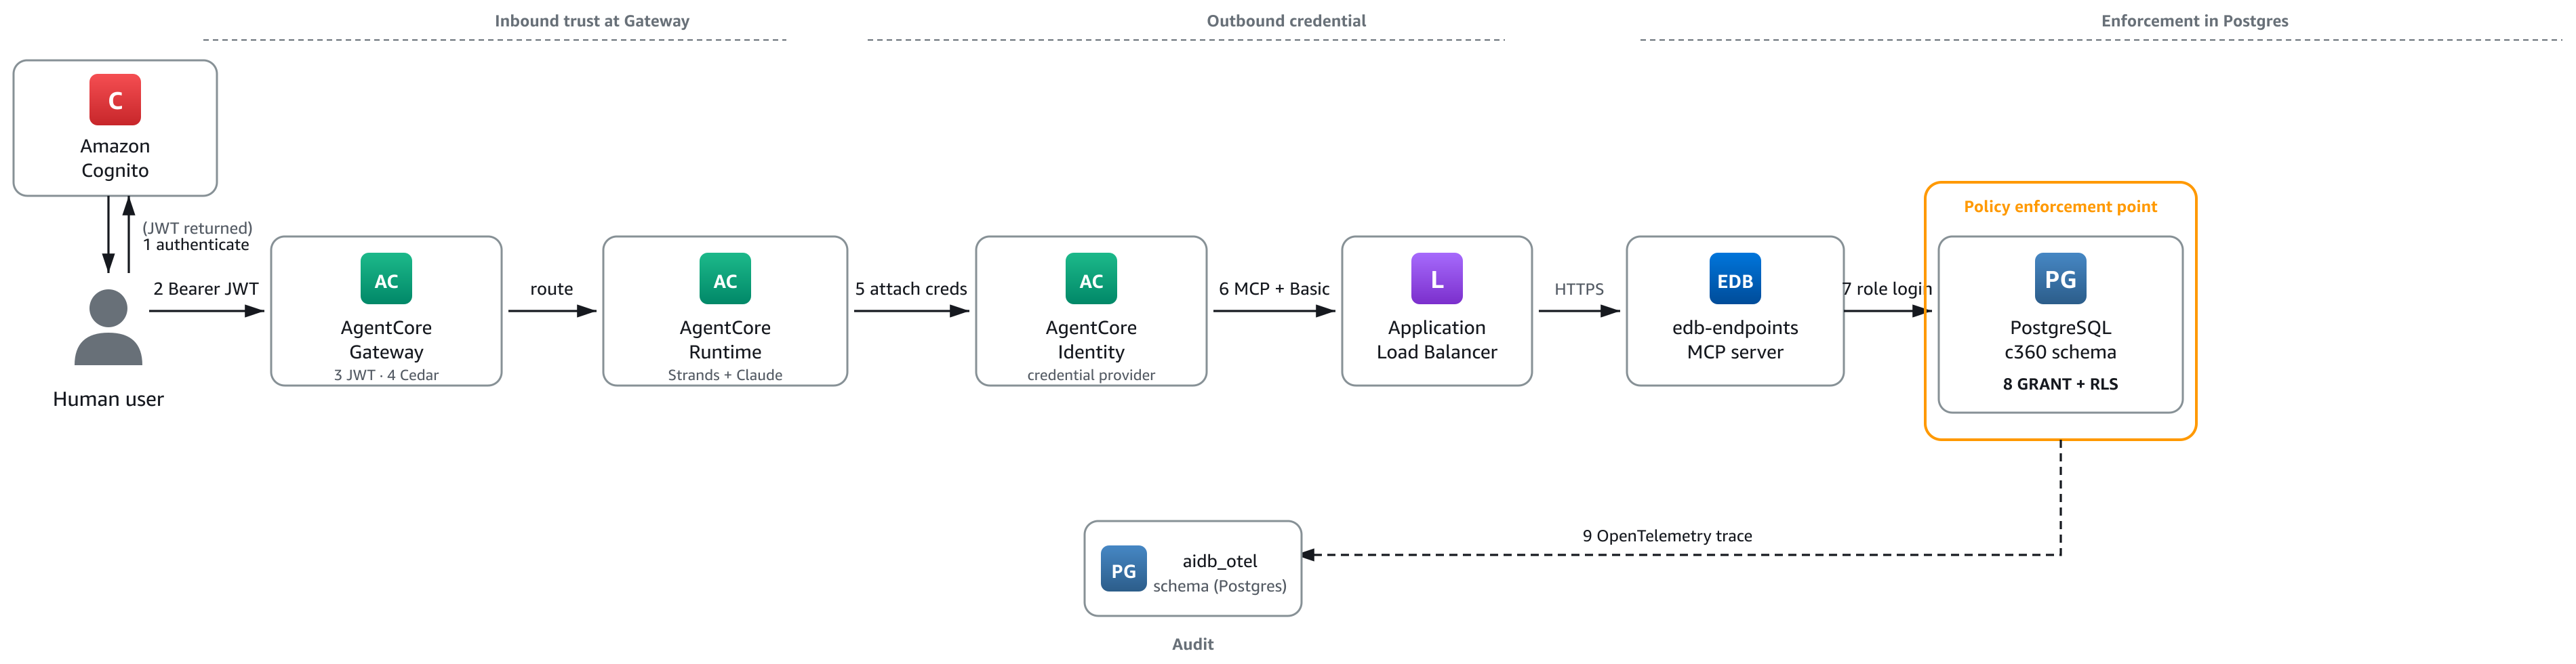
图 2:从最终用户到执行 SQL 的 Postgres 角色的身份传播链
Gateway 的入站信任: 1. 最终用户通过 Amazon Cognito 进行身份验证并获得 JWT 持有者令牌。2. 客户端在 Authorization 头中携带该令牌调用 AgentCore Gateway。3. Gateway 的 JWT 授权器针对 Cognito 用户池的发现 URL 验证该令牌。4. Gateway 根据令牌的声明评估其 Cedar 策略,以决定该智能体可以调用哪些工具。
发往 AIDB 的出站凭证: 5. Gateway 从 AgentCore Identity 凭证提供者解析 MCP 目标的出站凭证。对于 AIDB,这是一个用作 HTTP Basic 认证的 Postgres 用户名和密码。6. Gateway 将 MCP streamable-HTTP 请求转发给 ALB,后者再将其转发给 edb-endpoints。
Postgres 中的强制控制: 7. edb-endpoints 使用 Basic 认证头中的用户名和密码建立 Postgres 连接。Postgres 按照 pg_hba.conf 对登录角色进行身份验证,工具调用内的 current_user 就是该角色。8. c360 表上的列级 GRANT 语句和行级安全策略决定了工具调用能返回哪些行和列。被拒绝时,会在受限的表或列上以 Postgres 权限拒绝错误的形式呈现,MCP 端点将其原样转发。
审计。9. AIDB 将 SQL 执行的 OpenTelemetry 追踪捕获为 aidb_otel 模式中的行,可通过 SQL 立即查询。
两个 Postgres 角色,同一个问题,不同的结果
定义两个仅在列级 GRANT 上有所不同的智能体登录角色:mcp_agent_full 可以看到所有列,mcp_agent_restricted 可以看到除 customers.ssn 之外的所有列。
CREATE ROLE mcp_agent_full       LOGIN PASSWORD '...';
CREATE ROLE mcp_agent_restricted LOGIN PASSWORD '...';

GRANT USAGE ON SCHEMA c360 TO mcp_agent_full, mcp_agent_restricted;

-- Both roles need aidb_users to list MCP tools
GRANT aidb_users TO mcp_agent_full, mcp_agent_restricted;

-- Full role sees every column
GRANT SELECT ON ALL TABLES IN SCHEMA c360 TO mcp_agent_full;

-- Restricted role sees every table and view, with customers.ssn withheld
GRANT SELECT ON c360.locations, c360.products, c360.purchases, c360.big_spender
  TO mcp_agent_restricted;
GRANT SELECT (cid, first_name, last_name, email, phone, picture, location, full_name)
  ON c360.customers TO mcp_agent_restricted;
两个登录角色都需要在 pg_hba.conf 中为本地 edb-endpoints 连接路径添加密码认证条目,如配置你的智能体角色中所述。用这两个角色运行相同的问题会产生不同的结果。以 mcp_agent_restricted 身份调用的智能体无法查询 ssn 列:一旦尝试,Postgres 就会返回 permission denied for column ssn,MCP 端点将该错误原样转发。智能体随后会回复说它无法读取 SSN。两个角色下,提示词、工具目录、SemKB 和智能体代码完全相同。唯一的区别是 AgentCore Identity 注入到出站 Basic 认证头中的凭证。
行级过滤遵循相同的模式。在目标表上启用行级安全(RLS),并附加基于角色的 USING 策略。AIDB MCP 端点看到的行与该角色在直接 psql 连接中看到的行相同。
关于 AIDB purposes 的说明。AIDB 还提供了 purposes,这是一种策略抽象,将数据库内智能体(用 aidb.create_agent 创建并用 aidb.agent_converse 调用的智能体)限制到一个命名的 Postgres 角色。Purposes 适用于数据库内智能体路径。本文使用的外部 AgentCore 路径则如前所述,直接通过 MCP 端点上的 Postgres 角色进行治理。要审计外部 MCP 智能体,请参见 EDB Agent Governance,它读取相同的 aidb_otel span,并将智能体会话和策略决策可视化。
负责任的 AI 注意事项。到目前为止展示的治理层面控制的是智能体在数据库层可以执行什么。可将其与模型侧的 Amazon Bedrock Guardrails 配合使用,以约束智能体被允许生成的内容:针对敏感话题的内容过滤器、拒绝话题列表以及 PII 脱敏。这两个层面相辅相成。Postgres GRANT 在数据层阻止智能体读取社保号(SSN)。Guardrails 则有助于防止 PII 模式通过模型响应中的其他路径泄露。对于基于客户数据回答业务问题的智能体,两者都是生产环境控制措施。
暴露该层并运行智能体
启用 AIDB MCP 端点需要设置两个 Postgres 参数并重启。在 postgresql.conf 中设置 edb.endpoints_mcp_enabled = on,将 aidb 添加到 shared_preload_libraries,然后重启(启用端点)。要从 EC2 实例外部访问该端点,请将 edb.endpoints_mcp_host 设置为非环回地址,例如 0.0.0.0。用 edb.endpoints_mcp_port 选择端口(默认为 8765)。用 edb.endpoints_mcp_tls_cert 和 edb.endpoints_mcp_tls_key 提供传输层安全(TLS)密钥对,端点在非环回绑定时要求使用它们(配置端点)。
带有 HTTPS 监听器和 ACM 证书的应用程序负载均衡器(ALB)将 edb-endpoints 暴露给 AgentCore Gateway。ALB 目标组通过 HTTPS 连接到 EC2 实例的 8765 端口,且不验证后端证书链,因此 edb-endpoints 上的自签名证书足以用于开发和测试。在生产环境中,请使用带有 AgentCore Gateway VPC 出口的内部 ALB,以保持 Gateway 与 ALB 之间的连接为私有。
创建一个带有 Cognito 授权方的 AgentCore Gateway,将 ALB URL 注册为 MCP 服务器目标,并将两个 Postgres 凭证存储在 AgentCore Identity 凭证提供程序中(凭证提供程序参考)。
该智能体是一个简短的 Python 脚本。它使用 Strands Agents 将指向最新 Claude Sonnet 的 BedrockModel 连接到 MCPClient。MCPClient 通过 streamable HTTP MCP 传输连接到 Gateway URL,并使用 Cognito 访问令牌作为 Bearer 头。系统提示词指示智能体先调用 semantic_kb_search 获取模式上下文并传入 kb_name => 'c360_kb',然后调用 execute_sql 执行生成的查询。AgentCore runtime starter toolkit with Strands 提供了一个在生产环境中托管此类智能体的完整示例。
我们建议为智能体的系统提示词开启 Amazon Bedrock 提示词缓存。每次调用都复用相同的指令和相同的工具列表,这正是提示词缓存的用途。
示例查询与验证
通过智能体提出的四个问题外加一次治理重跑,全部针对之前加载的 C360 数据。
查询 1:按总消费额列出我们的前 10 大客户,以及他们各所在的州?
如果没有 purchases.price 上的注释,一个只配置了 SQL 执行工具的智能体会把 price 当作单价并乘以 quantity。返回的第一行显示 Carolyn Inworth 的消费约为 $502,529,这是错误的。一条由 SemKB 索引的列注释,就是这个错误答案与正确答案之间的全部差别:
     full_name     |     state      |   spent
-------------------+----------------+----------
 Carolyn Inworth   | Wisconsin      | 27991.66
 Marlane Shadwick  | Florida        | 22677.05
 Isaac Popping     | Pennsylvania   | 20085.96
 Bria McKellar     | Texas          | 19588.80
 Mike Laydel       | Louisiana      | 18651.28
 Fayette Mor       | Arizona        | 17993.69
 Reynard Perigoe   | Florida        | 17019.55
 Humfrey Fores     | California     | 16811.16
 Patrice Jakeway   | California     | 16656.72
 Mord Pettus       | North Carolina | 16604.37
相同的模型、相同的提示词、相同的工具目录。语义知识库改变了答案。
查询 2:我们在每个州有多少大消费客户?
智能体通过 semantic_kb_search 找到 big_spender 视图,因为它的 COMMENT ON VIEW 与自然语言问题相匹配。业务定义只存放在一个地方:
        state         | big_spenders
----------------------+--------------
 Florida              |           46
 Texas                |           46
 California           |           42
 District of Columbia |           24
 New York             |           23
 ...
如果业务方后来将大消费客户重新定义为累计消费超过 $5,000 的客户,只需修改一条 CREATE OR REPLACE VIEW 语句。下次 SemKB 刷新时,每个智能体都会看到新定义。
查询 3:列出 10 位客户及各自所在的州
州信息在 locations 中,而不在 customers 中。连接路径编码在 customers.location 外键和列注释中,两者都被 SemKB 索引。智能体输出:
SELECT c.cid, c.full_name, l.state
  FROM c360.customers c
  JOIN c360.locations l ON l.id = c.location
 ORDER BY c.cid
 LIMIT 10;
cid | full_name | state
-----+-----------------------+----------------
1 | Jolynn Bithany | Texas
2 | Mord Pettus | North Carolina
3 | Lavinie Stannislawski | Florida
4 | Kimball Evenett | Alabama
5 | Linnie Meatcher | California
6 | Lorens Stoneley | Washington
7 | Juliane Gerhartz | California
8 | Jacob O'Lyhane | Utah
9 | Terrel Seller | Missouri
10 | Jannel Gawthrope | California查询 4:哪些 10 种产品的销量最高?
一个在 Postgres 内紧邻数据运行的普通聚合查询:
SELECT p.name, sum(pu.quantity) AS units
  FROM c360.purchases pu
  JOIN c360.products  p  ON p.id = pu.pid
 GROUP BY p.id, p.name
 ORDER BY units DESC, p.id
 LIMIT 10;
name | units
--------------------+-------
Markers | 160
Cleaning Wipes | 155
Playset (Girl's) | 146
Queen Sheet Set | 138
Mechanical Pencils | 137
Shot Glasses | 133
Parchment Paper | 127
American Cheese | 127
Pop Music | 127
Varnish | 125相同的提示词运行了两次。在 mcp_agent_full 之下,智能体返回五行客户数据,其中 ssn 值被填充。在 mcp_agent_restricted 之下,智能体的工具调用因 Postgres 错误 permission denied for column ssn 而失败,智能体以一条简短消息回应,说明此调用者无法访问 SSN。这一失败由列级 GRANT 强制执行,而不是由提示词或模型。AIDB 在 aidb_otel 中捕获 SQL 执行的 OpenTelemetry 追踪,因此审查者之后可以查询该追踪记录以确认治理决策。
扩展到多个数据源
对于超出运营数据库承载能力的分析型工作负载,EDB Postgres Analytics Accelerator (PGAA) 让 Postgres 通过 Iceberg REST 目录读取对象存储中的 Apache Iceberg、Delta Lake 和 Parquet 表。EDB Postgres AI analytics overview 涵盖了端到端的设置。PGAA 表在 Postgres 中以普通表的形式出现,因此同样的 SemKB 描述可以继续作用于分析副本,而且智能体的工具目录无需更改。
对于到外部关系数据源的联邦查询,Postgres foreign data wrappers(外部数据封装器)可以让外部表像本地表一样被访问。在这两种情况下,语义层都保持不变,因为业务定义、列注释和语义别名都存放在 Postgres 中。
部署
此架构有两种部署形态。
在 Amazon EC2 上自行管理。使用 AWS Marketplace 中的 EDB Postgres AI Agent Factory AMI。客户拥有 VPC、子网、版本节奏以及 EDB Postgres AI 软件升级的控制权。ALB 和 AgentCore Gateway 目标配置与前一架构保持不变。
在 Amazon EC2 上由 EDB 托管。EDB Managed Database 是一项由 EDB 专家代表客户处理数据库管理的服务。AgentCore 侧保持不变。
结论
可靠的分析智能体需要三样东西协同工作:一个能够规划并生成查询的基础模型、一个提供受治理的业务数据视图的语义层,以及一个托管智能体并管理身份的智能体运行时。Amazon Bedrock 提供模型,Amazon Bedrock AgentCore 提供运行时,EDB Postgres AI 提供一个存在于运营型 Postgres 数据库内部的语义层。业务含义、连接路径和治理都来自模式中已有的 Postgres 原语。AWS 侧与本系列其他部分相同:AgentCore Gateway、Runtime、Identity、Bedrock 和 CloudWatch。
数据、业务定义和访问规则都存放在同一个 Postgres 模式中,因此不需要单独维护一个需要保持同步的目录。审计也保存在同一个数据库中:aidb_otel 为每次工具调用保存一个 span,就放在它所查询的数据旁边。
从哪里开始
要将此架构应用到您自己的数据上,请按以下步骤操作:
- 选择一个智能体需要实时查询的 Postgres 数据库。范围越小越好。
- 为智能体的数据创建一个专用模式,并将
GRANT USAGE的作用域限定为某个服务角色。 - 在列和视图上编写使用业务语言的
COMMENT ON语句。通过COMMENT ON VIEW语句将业务术语捕获为视图。 - 使用
aidb.create_semantic_kb和auto_processing => 'Live'(在高写入量下可使用Background)在该模式上创建一个 SemKB。 - 将常见问题注册为语义别名。
- 启用 AIDB MCP 端点,用一个带有 HTTPS 和 ACM 证书的 ALB 作为其前端,并将该 ALB URL 注册为 AgentCore Gateway 的 MCP 服务器目标。
- 通过智能体运行三个真实问题,然后在一个权限被缩减的角色下重新运行其中一个问题,以确认执行控制面端到端有效。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com