用 CUR 2.0 和 AWS Budgets 按 IAM principal 追踪并限额 Amazon Bedrock 花费
Tokenomics at scale: Track and cap Amazon Bedrock spend per IAM principal with CUR 2.0 and AWS Budgets
本文展示如何仅用 AWS 原生功能实现按身份的 Amazon Bedrock 成本可见性与花费限额,无需自写代码。方案分三步:Bedrock 自动记录每次推理请求的 IAM principal 身份;通过成本分配标签在 Cost Explorer 或 CUR 2.0 导出中做报表;再对单个身份或标签创建 AWS Budget,超阈值时通过 budget action 施加 Deny IAM 策略。
生成式 AI 的支出很难归因。在组织扩大 AI 使用范围之前,CFO 和 CTO 通常想要三个问题的答案:我们每个人或每个团队的花费是多少,能否设置上限,以及实现这一目标需要多少工作量。
在我们之前的文章 Tokenomics at Scale: How Jamf Built Real-Time Spend Enforcement for Amazon Bedrock 中,我们介绍了一个基于 AWS IAM Identity Center、Amazon Athena、Amazon Bedrock 模型调用日志 和 AWS Lambda 构建的自定义强制执行循环。这种方法提供了近实时的控制,但需要你自己编写并运维代码。
本文展示了如何仅使用 AWS 原生功能来实现按身份的 Amazon Bedrock 成本可见性以及可执行的支出限额,对于常见场景无需编写任何应用程序代码。该方法依赖三项内容:IAM 委托人归因,Amazon Bedrock 会自动记录这一信息;用于报告的 AWS Cost and Usage Reports(CUR)2.0 或 AWS Cost Explorer;以及用于强制执行的 AWS Budgets 及预算操作。读完本文后,你将拥有按身份的成本报告,以及一个在超过阈值时自动限制 Amazon Bedrock 访问的自动防护机制。
解决方案概览
该解决方案包含三个部分:归因、报告和强制执行。
归因。Amazon Bedrock 会为每个推理请求捕获 AWS Identity and Access Management(IAM)委托人身份,即 IAM 用户 或 角色。这一过程自动完成,无需对 Amazon Bedrock 模型推理调用做任何更改。如果多个人共享一个角色,可以通过在角色代入时传递会话标签来添加按用户的详细信息。如果每个人或每个应用程序拥有自己的角色,角色上的委托人标签就足够了。
报告。将这些标签激活为成本分配标签,然后通过 Cost Explorer 查看仅控制台的视图,或在 CUR 2.0 数据导出中读取数据,以进行详细的逐行项目分析和 SQL 查询。
强制执行。创建一个范围限定为 Amazon Bedrock 并按某一身份或标签值过滤的 AWS Budget,然后附加一个 预算操作,在超过阈值时应用 Deny IAM 策略。
以下各节将更详细地介绍每个部分,并给出实施步骤。
先决条件
要部署此解决方案,你需要:
- 一个已启用 Amazon Bedrock 模型访问权限的 AWS 账户。
- 为 IAM 委托人 打标签、激活 成本分配标签、创建数据导出 以及创建预算和预算操作的权限。
- 通过 IAM 角色或 IAM 用户访问 Amazon Bedrock。
- 已配置适当凭证的 AWS Command Line Interface(AWS CLI)。
- 一个 CUR 2.0 数据导出和一个用于接收它的 Amazon Simple Storage Service(Amazon S3)存储桶。(可选,用于详细的逐行项目分析)。
- Amazon Athena。(可选,用于查询导出数据)。
AWS Billing 控制台的访问权限与大多数 IAM 权限是分开管理的。开始之前请确认你拥有该权限。
操作演练
在配置任何内容之前,先检查你已有的东西。Amazon Bedrock 会自动记录每次推理请求的调用者身份。打开 Cost Explorer,将服务筛选为 Amazon Bedrock,并按可用的身份或标签维度分组。如果每个应用或每个人已经使用不同的 IAM 角色,这可能就是你所需要的全部可见性。
要配置更多可见性:
- 第 1 步提供身份级别的可见性。
- 第 2 至 4 步增加标签维度和详细报告。
- 第 5 步增加强制执行。
第 1 步:确定身份如何映射到你的用户
如何打标签取决于你的 IAM 主体是如何组织的。
每人或每个应用一个角色。直接将主体标签附加到每个 IAM 角色或用户上。这些是静态的,适用于来自该主体的每个请求。使用 IAM 控制台或 AWS CLI:
aws iam tag-role \
  --role-name BedrockDeveloperRole-alice \
--tags Key=user,[email protected] Key=team,Value=platform Key=CostCenter,Value=CC-1001多人共用的角色,或一个网关。主体标签无法区分共享角色上的用户,因为每个会话都带有相同的标签。请改用在角色被代入时传递的会话标签。会话标签是动态的,可以每个会话各不相同。如果会话标签和主体标签具有相同的键,则该会话以会话标签为准。
角色的信任策略必须允许 sts:TagSession。会话标签可以通过三种方式传递:
sts:AssumeRole配合--tags,适用于按用户或租户代入角色的网关。AssumeRoleWithWebIdentity,标签位于 OpenID Connect (OIDC) ID 令牌的 https://aws.amazon.com/tags 声明中(这是一个声明名称,不是可浏览的网址)。AssumeRoleWithSAML,通过在身份提供商的安全断言标记语言 (SAML) 断言中映射PrincipalTag:*属性。
如果你的组织已经出于其他目的捕获了类似 saml:sub 的声明,这并不能自动使其在此处可用。你的身份提供商必须单独将该属性映射到 PrincipalTag:* 的 SAML 属性语句,并且角色的信任策略必须允许 sts:TagSession,它才能作为会话标签传递过来。这两个集成来自同一个 SAML 断言,但需要独立配置。常见的标签键包括 user、team、Department、CostCenter 和 Environment。每个 IAM 用户或角色最多可以应用 50 个主体标签或会话标签。
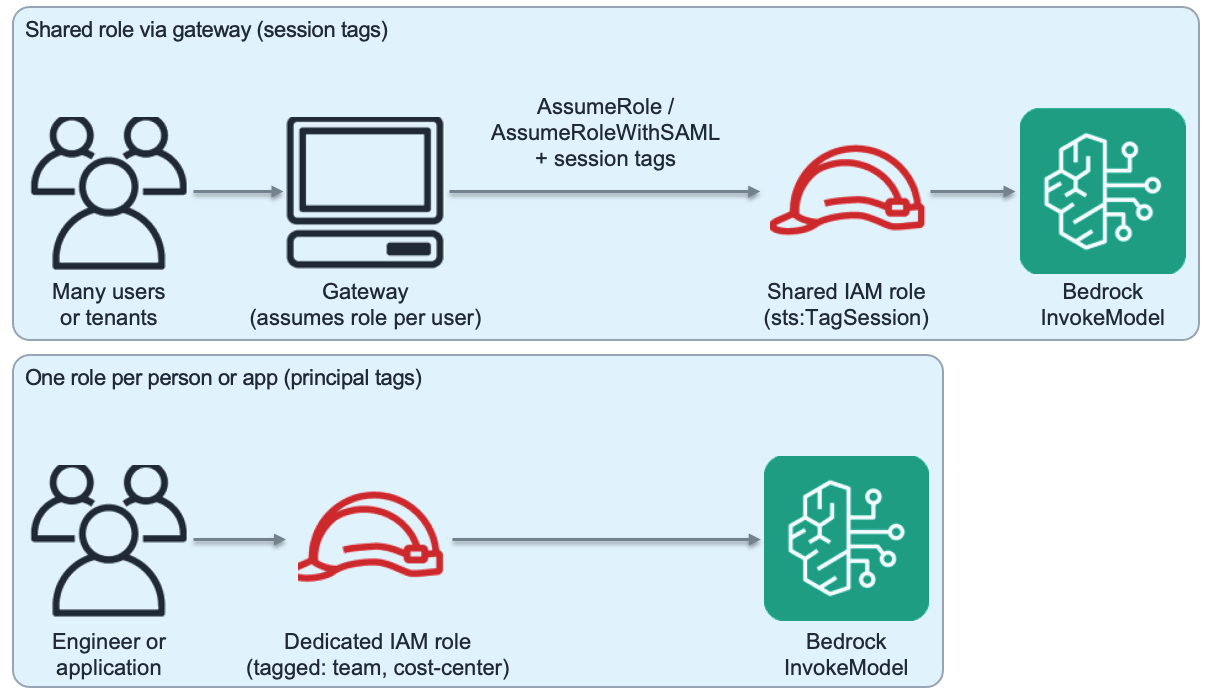
图 1:使用主体标签与会话标签进行归因的对比
第 2 步:激活成本分配标签
在激活之前,标签不会出现在账单数据中。
- 打开 AWS Billing and Cost Management 控制台。
- 选择 Cost allocation tags(成本分配标签)。
- 按类型 IAM principal 筛选。
- 选择你的标签键并选择 Activate(激活)。
在 AWS Organization 中,需要在 管理账户(付款账户)中激活 IAM 主体成本分配标签。成员账户无法独立激活它们。
需要预期的两点:
- 只有当主体至少发出过一次 Amazon Bedrock 调用后,标签键才会出现在此列表中,所以如果列表看起来是空的,请先进行一次测试调用。
- 新应用的标签键可能需要最多 24 小时才会出现在激活列表中,激活后再需要最多 24 小时才会开始填充账单数据。
默认情况下,激活不会追溯生效,所以要在需要数据之前激活标签。
第 3 步:创建包含调用者身份的 CUR 2.0 数据导出
如果 Cost Explorer 已能满足你的报告需求,请跳过此步骤。
- 在 Billing and Cost Management 控制台中,选择 Data Exports(数据导出)。
- 选择 Create(创建) 并创建 CUR 2.0(标准)导出。
- 在附加导出内容下,选择包含调用者身份(IAM 主体)分配数据。
- 在时间粒度下,选择“每小时”。
- 在报告数据集成下,选择Amazon Athena。这会将文件格式设置为 Parquet,并且重要的是,会在导出数据的同时向您的 S3 存储桶交付一个设置脚本。
- 选择目标 Amazon S3 存储桶。
- 运行交付的设置脚本(或它定义的 Glue 爬网程序/DDL)一次。这才是真正创建您将在第 4 步中查询的 Glue Data Catalog 表的操作。前面的控制台流程不会自动为您创建它。
如果您在启用身份归因之前已创建了 CUR 2.0 导出,它不会追溯包含身份数据。请选择调用者身份选项创建一个新的导出。在导出中,主体和会话标签显示为带有前缀 iamPrincipal/ 的列,资源标签显示为 resourceTags/。例如,标签键 team 显示为 iamPrincipal/team。AWS 在 aws-samples/sample-cur-iam-principal-bedrock-tracking 中为这种确切模式发布了一套现成的查询。
第 4 步:读取数据
下图比较了读取数据的两种方式:仅通过控制台经 Cost Explorer 的路径,以及使用 Amazon Athena 对 CUR 2.0 导出执行 SQL 的路径。
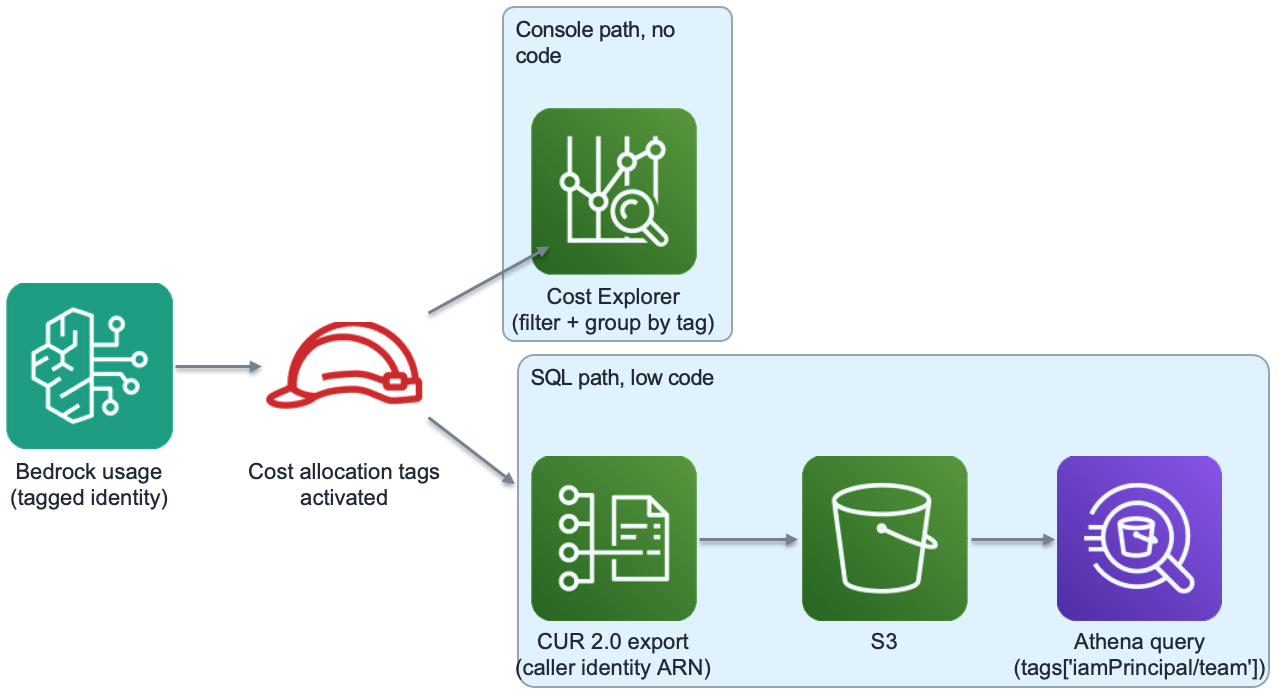
图 2:使用 Cost Explorer 报告与使用 CUR 2.0 和 Amazon Athena 报告的对比
控制台路径,无需自定义代码。将 Cost Explorer 筛选到 Amazon Bedrock 并按您的标签键分组,可以以图表和表格的形式显示每个团队或每个用户的支出。这涵盖了大多数经常性的报告需求,并且不需要编写查询。
SQL 路径,低代码。将 Amazon Athena 指向 CUR 2.0 导出,按 iamPrincipal/team 和使用类型对支出进行分组:
SELECT
    tags['iamPrincipal/team'] AS team,
    line_item_usage_type,
    SUM(line_item_unblended_cost) AS cost
FROM cur2_view
WHERE product_servicecode IN ('AmazonBedrock', 'AmazonBedrockService')
AND billing_period = '2026-09'
GROUP BY 1, 2
ORDER BY 3 DESC
需要注意的事项:
- 服务代码:Amazon Bedrock 的支出可能记录在多个
product_servicecode值下,例如AmazonBedrock和AmazonBedrockService。 - 表名:表名(
cur2_view)是第 3 步的设置脚本创建 Glue 表时命名的名称。如果不同,请检查脚本或您的 Glue 目录。无论表名如何,列名都与 CUR 2.0 Parquet 架构一致。 - 计费周期列。确认您的导出如何呈现周期。有些导出使用
billing_period(YYYY-MM)。另一些则按开始日期或年/月列进行分区。
两个值得在您编写的任何查询中留意的注意事项。
- 统计所有令牌类型:Amazon Bedrock 按四种令牌类型计费,每种类型费率不同:输入、输出、缓存读取和缓存写入。每种都是独立的明细项目,具有各自的使用类型和单价,因此只对输入和输出求和会导致统计不足。对于大量使用提示缓存的负载,差距最大。有关最新信息,请参阅 AWS 文档 Understanding Amazon Bedrock pricing in CUR。
- 将费率与明细项目匹配,而不是与模型匹配:CUR 中 Amazon Bedrock 的定价由三个因素决定:令牌类型、服务层级,以及请求是否通过跨区域推理路由。区域内和跨区域请求的定价不同,服务层级也会反映在使用类型中。使用类型带有一个后缀,表示跨区域路由和服务层级,因此如果您的负载混合了这些情况,应将费率与每个明细项目匹配,而不是对每个模型应用单一费率。有关示例,请参阅 CUR usage type examples。
第 5 步:使用 AWS Budgets 和预算操作添加强制执行
AWS Budgets 会执行附加操作,因此此工作流无需自定义代码。预算操作附加到特定的 IAM 用户、组或角色。只有当该用户已经拥有自己的角色时,这才能隔离该个人的访问权限。如果您的 Amazon Bedrock 流量通过一个由多人共享的角色运行,则附加到该角色的 Deny 操作会阻止该角色上的所有人,而不仅仅是超过阈值的那个人。下图解释了强制执行工作流。
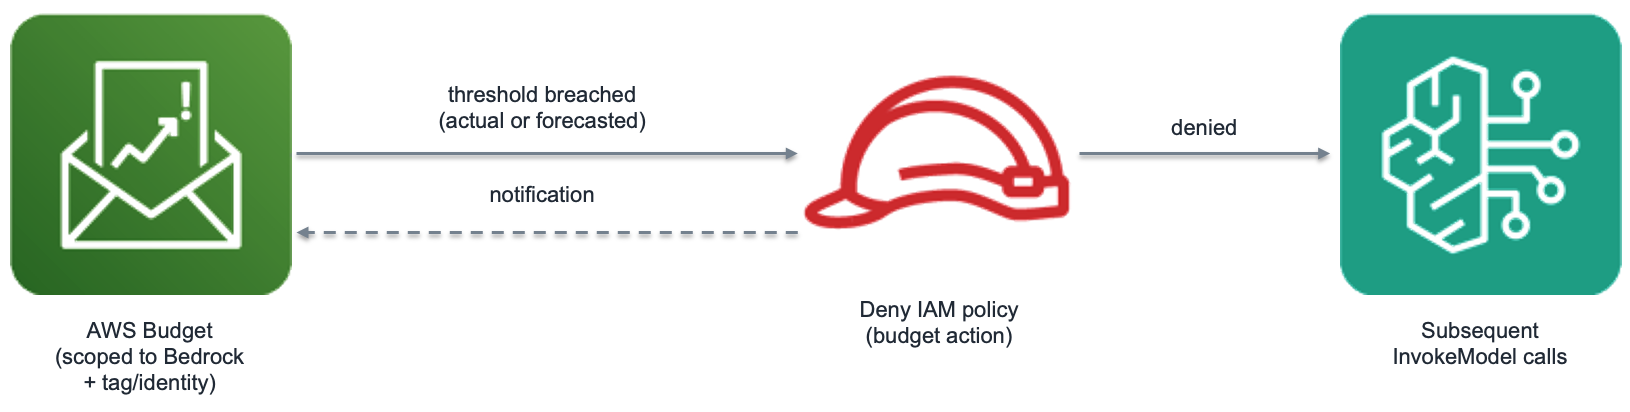
图 3:使用 AWS Budgets 和预算操作进行强制执行
当超过阈值时,AWS Budgets 可以运行操作。可用操作包括应用自定义 IAM 策略、应用服务控制策略(SCP)以及针对 Amazon Elastic Compute Cloud(Amazon EC2)或 Amazon Relational Database Service(Amazon RDS)实例。对于此用例,IAM 策略操作是相关的那一个。
首先,创建操作将要附加的 Deny 策略。此示例拒绝较高成本的模型,同时保留一个较低成本的模型可用,以便用户可以继续工作:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Deny",
      "Action": [
        "bedrock:InvokeModel",
        "bedrock:InvokeModelWithResponseStream"
      ],
      "Resource": [
        "arn:aws:bedrock:*::foundation-model/[HIGHER-COST-MODEL-ID]"
      ]
    }
  ]
}
将 [HIGHER-COST-MODEL-ID] 替换为您的环境中想要拒绝的模型 ID。
然后设置权限和预算本身。
这里有两个不同的角色,而 AWS 托管策略只涵盖其中之一:
您自己的用户或角色(配置预算的那个)需要 AWS 托管策略 AWSBudgetsActionsWithAWSResourceControlAccess。它授予预算权限,以及将预算操作角色交给 AWS Budgets 所需的带条件的 iam:PassRole。
AWS Budgets 为执行操作而代入的 IAM 角色在此用例中没有单一命名的托管策略可涵盖。创建它时需使用信任策略,允许主体 budgets.amazonaws.com 代入该角色(用 aws:SourceArn 和 aws:SourceAccount 条件限定范围),以及一个权限策略,授予 iam:AttachRolePolicy 和 iam:DetachRolePolicy(如果您还使用 SCP,则还有 organizations:AttachPolicy 和 organizations:DetachPolicy)。有关可授予的权限,请参阅 为 AWS Budgets 设置运行预算操作的角色。
- 创建前面描述的预算操作角色。
- 创建一个范围限定为 Amazon Bedrock 的成本预算,并筛选到您想要设限的身份或标签值。
- 在 Configure alerts 中,添加一个警报阈值。对于已实现的支出选择 Actual,或者选择 Forecasted 以在支出实际发生之前采取行动。
- 在 Attach actions 下,选择 Add Action,选择预算操作角色,然后选择 IAM 策略操作。选择 Deny 策略以及要附加它的 IAM 用户、组或角色。
- 对于自动强制执行,选择 Yes 以自动运行该操作。选择 No 以要求人工在 Alert details 页面上批准每个操作。
- 至少配置一个通知,以便受影响的用户被告知访问权限发生变化的原因。
您可以将多个操作附加到单个阈值,并将多个阈值附加到一个预算。这就是构建分层的方式:例如,在 80% 时拒绝高级模型,在 100% 时拒绝中档模型,而从不拒绝低成本模型。
只有管理账户才能应用 SCP,并且从管理账户您可以对另一个账户应用 SCP。
注意事项
AWS Budgets 不是近实时的:预算数据每天最多刷新三次,因此在操作运行之前,支出可能会超过阈值。
成本分配标签不具有追溯性:新应用的标签键最多需要 24 小时才会出现,而在您激活它之后,还需要最多另外 24 小时才会开始填充账单数据。
CUR 不包含每请求明细条目:无论是经典 CUR 还是 CUR 2.0,都是按使用类型、操作以及定价/资源属性,以一小时或一天为粒度聚合 Amazon Bedrock 成本。
IAM 主体字段需要 CUR 2.0:旧版 CUR 格式不包含这些字段。按 token 的成本明细在两种格式中均可用。
会话标签在 AssumeRole 时绑定,而非按请求绑定。使用该会话凭证发起的每一次调用中,其值都保持不变,并且只以聚合账单数据的形式呈现。会话标签不会写入模型调用日志。日志记录的是调用者的 identity.arn。要在请求级别区分共享同一会话的用户,请使用针对每个用户的 RoleSessionName,或在每次调用时在请求元数据中设置用户。
预算操作附加到 IAM 用户、组和角色。如果你的用户是联合身份且没有常驻的 IAM 身份,预算操作需要一个可指向的角色。这就是为什么当每个人或每个应用拥有自己的角色时,该模式效果最佳。如果你的用户共享一个角色,或是没有自己角色的联合身份用户,请参阅我们之前的文章了解按用户实施限制的方法。
共享的网关角色在默认情况下会使归因失效。使用大语言模型(LLM)网关时,捕获的身份是网关的执行角色。
新模型需要关注。使用类型是针对特定模型的。启用新模型时,请确认它按预期出现在你的查询和预算过滤器中,而不要想当然地认为它已被覆盖。
决策框架
| 需求 | 推荐路径 |
| 快速报告 | 按身份分组的 Cost Explorer |
| 按团队报告 | 启用了标签的 Cost Explorer(步骤 1、2 和 4) |
| 详细明细分析 | CUR 2.0 导出(步骤 1 至 4) |
| 强制执行 | 带预算操作的 AWS Budgets(步骤 1 和 5) |
清理
为避免持续产生费用,请删除你创建的所有资源。
结论
在本文中,你学习了如何仅使用 AWS 原生功能实现按身份的 Amazon Bedrock 成本可见性和可执行的支出限额,对于常见场景无需编写任何应用代码。随着生成式 AI 采用规模的扩大,能够胜出的组织将是那些能够自信回答代币经济学问题的组织:我们每个人或每个团队花费了多少,能否设定上限,以及实现这一目标需要多少工作量。
现在,轮到你开始探索了。我们随时为你提供帮助,如果你需要进一步的支持,请联系 AWS Support 和你的 AWS 客户团队。
作者简介
来源: AWS Machine Learning Blog · aws.amazon.com