在 Amazon SageMaker HyperPod 上微调 GPT-OSS-20B 的多语言推理能力
Fine-tuning GPT-OSS-20B for multilingual reasoning on Amazon SageMaker HyperPod
AWS 团队在 Amazon SageMaker HyperPod 上对 openai/gpt-oss-20b 做多语言推理微调,用 SFT 将 50 例评测中的目标语言链式思考正确率从 22% 提升到 100%,再叠加 GRPO 把答案语言正确率从 62% 提到 70%。
GPT-OSS-20B 是一个用英文进行思考的开放权重推理模型。如果让它用法语、德语、西班牙语或意大利语进行推理,它会确认收到指令,但随后仍然用英文生成思维链。在一项包含 50 个示例的多语言推理测试中,基础模型只有 22% 的情况下用正确的目标语言进行推理。这 22% 几乎全部来自英文示例(英语 100%,法语 0%,德语 10%,西班牙语 0%,意大利语 0%)。
对于为非英语用户部署推理模型的团队来说,这一差距至关重要。用法语提问的用户期望模型用法语进行推理和回答,而不是思考到一半切换成英文。弥合这一差距是一个微调问题。这也引出了每个团队在开始定制开放权重模型时都会面临的问题:有监督微调(SFT)、使用组相对策略优化(GRPO)的强化学习,还是两者都用?
在本文中,我们将介绍如何在 Amazon SageMaker HyperPod 上针对多语言推理对 GPT-OSS-20B 进行微调。我们会展示 SFT 何时已经足够,以及 GRPO 在其之上何时能带来可衡量的提升。为了更广泛地理解 GRPO 何时有用,我们还针对两个能力差距不同的任务,对 Qwen2.5-7B 进行了一项受控实验。简短的答案是:SFT 完成了大部分工作,GRPO 在有提升空间时进行精炼,而根据能力差距匹配相应的技术才是决定结果的关键。
解决方案概述
本节介绍多语言推理任务与数据集、SFT 和 GRPO 如何相互补充,以及我们在 Amazon SageMaker HyperPod 上使用的训练技术栈。
任务与数据集
数据集是 HuggingFaceH4/Multilingual-Thinking——一个思维链推理数据集,除英语外还被翻译成法语、西班牙语、德语和意大利语,大约包含 949 个训练示例和 50 个验证示例。模型会收到一条 reasoning language: 系统提示指令,必须用该目标语言进行推理和回答,从而覆盖其强大的英语先验。评估包含 50 个测试用例:横跨 5 种语言(EN/FR/DE/ES/IT)的 10 道数学/逻辑题。
有两个关键指标:
- 推理语言正确——思维链是否使用了所请求的语言?
- 回答语言正确——最终答案是否使用了所请求的语言?
SFT 与 GRPO 如何配合
理解这两种技术最清晰的方式是:SFT 教会模型一种它原本不具备的行为。GRPO 则优化模型已经偶尔能够产出的行为。GRPO 的工作方式是针对每个提示采样一组响应,并推动策略向高于平均水平的响应靠拢。如果期望的行为在基础分布中概率为零,GRPO 就几乎没有可以强化的东西。这一个想法几乎解释了本文中的所有实验结果。
训练技术栈
我们在 Amazon SageMaker HyperPod 上运行,并使用 Amazon Elastic Kubernetes Service(Amazon EKS)进行编排。针对 GPT-OSS-20B 的初始 SFT 和 GRPO 运行,我们使用了 PyTorch TRL 库。在 Qwen 对照实验中,我们改用 veRL 作为训练器,配合 Ray 和 KubeRay 进行分布式编排,并使用 vLLM 进行快速 rollout 生成。检查点和数据集存储在 Amazon FSx for Lustre 上,节点间网络使用弹性结构适配器(EFA)。所有微调均采用低秩自适应(LoRA),它参数高效,同时非常适合 SFT 和 GRPO。
下图展示了端到端的训练数据路径。用户提交的任务落在 Amazon SageMaker HyperPod 集群的 Amazon EKS 控制平面上。Amazon EKS 调度一个 Ray head pod 以及运行 veRL 训练器和 vLLM rollout 工作节点的 worker pod。两组 pod 都挂载 Amazon FSx for Lustre,用于存放基础模型、训练数据和检查点。节点间集合通信使用 EFA。Rollout 结果从 vLLM 流回 veRL 训练器,训练器再将检查点写回 Amazon FSx for Lustre。
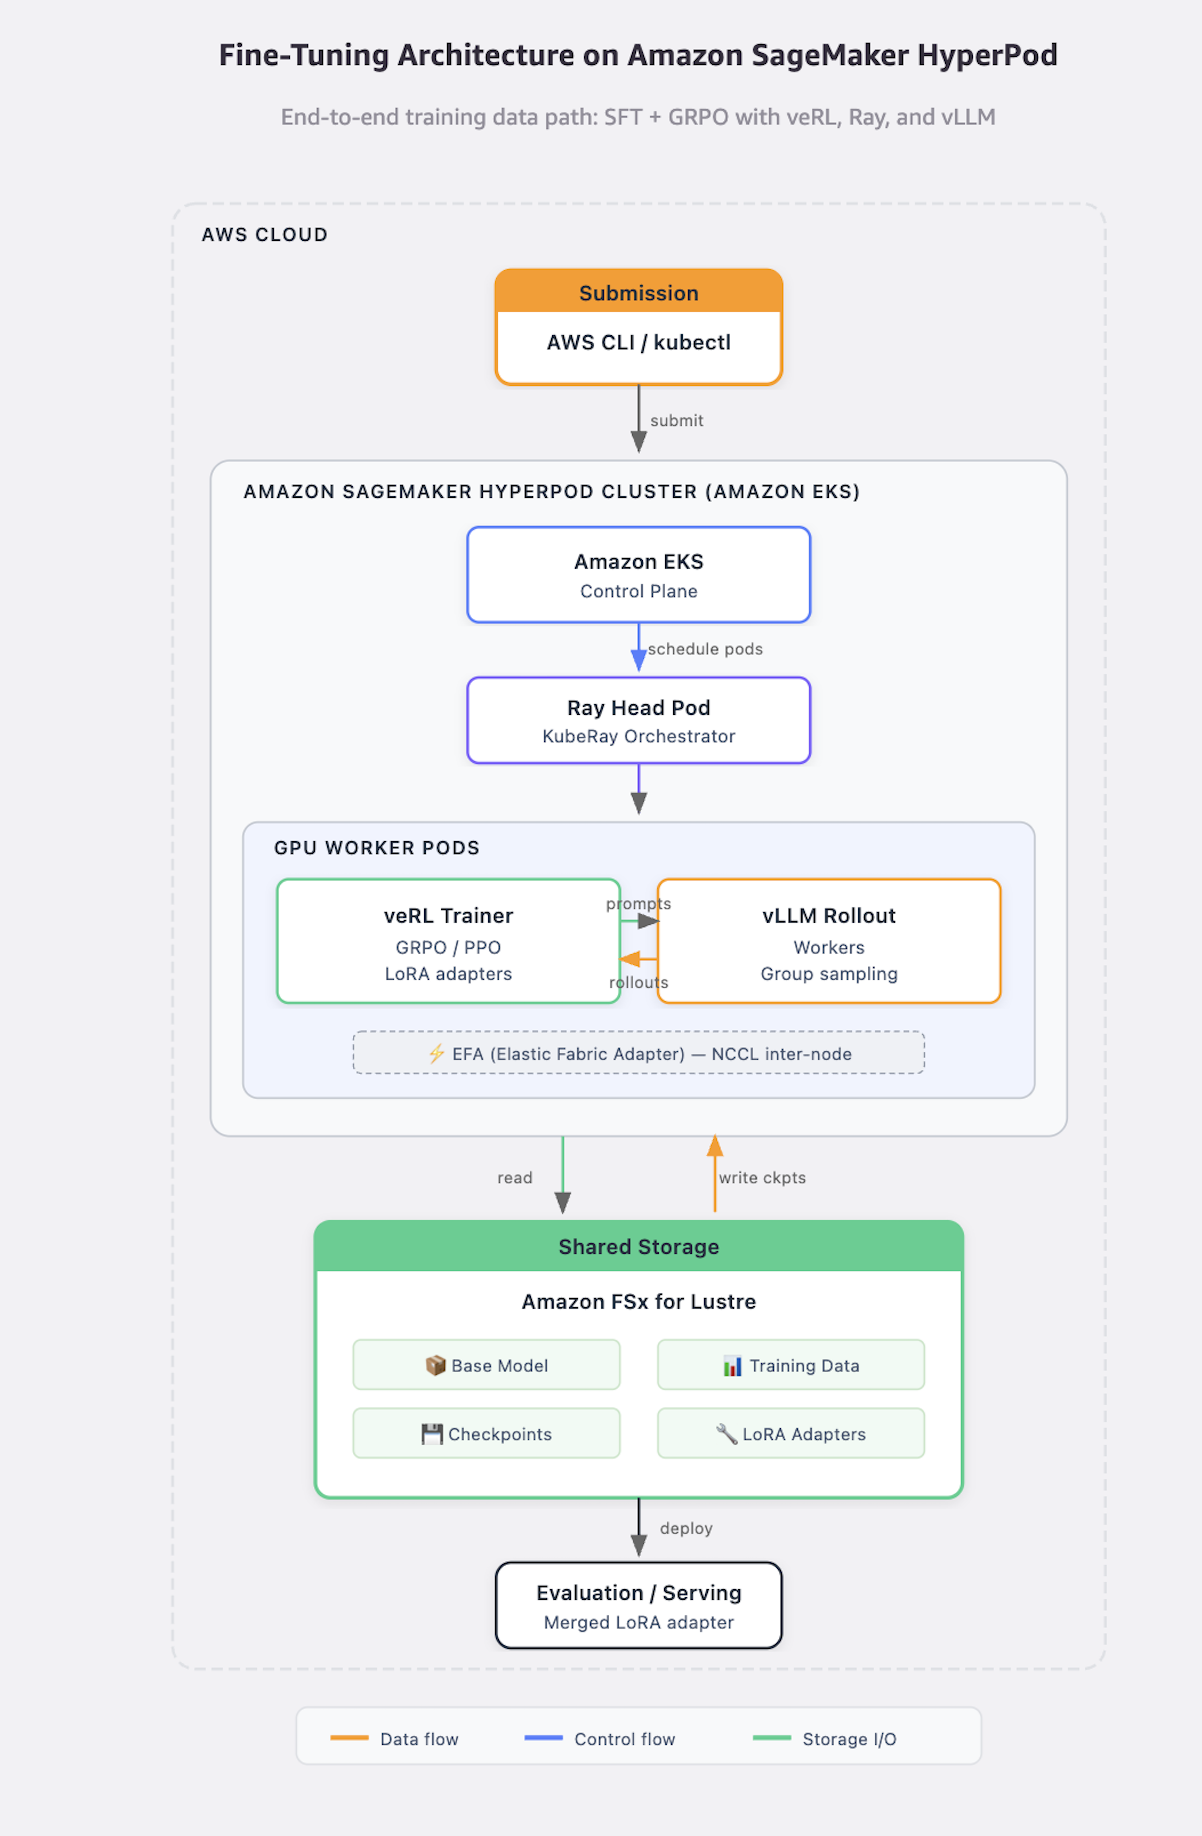
图 1:使用 veRL、Ray、KubeRay、vLLM 和 Amazon FSx for Lustre 在 Amazon SageMaker HyperPod 上对 Qwen 对照实验进行 SFT 和 GRPO 微调的端到端训练数据路径
下面更详细地描述每一跳。提交者从 Amazon SageMaker Studio 或 AWS 命令行界面(AWS CLI)启动运行。Amazon SageMaker HyperPod 上的 Amazon EKS 控制平面将 pod 放置到 GPU 节点上,并启动一个 Ray head 以及用于 veRL 训练器和 vLLM rollout 工作节点的 worker pod。Amazon FSx for Lustre 为基础模型、训练数据和检查点提供共享的高吞吐量存储。训练完成后,训练器将 LoRA 适配器写回 Amazon FSx for Lustre,以便进行下游评估或推理服务。
先决条件
要跟随本教程操作,你需要:
- 一个使用 Amazon EKS 编排的 Amazon SageMaker HyperPod 集群。GPT-OSS SFT 使用了 4× ml.g6e.12xlarge(16× L40S 48GB)。Qwen 对照实验使用了 2× g6e.48xlarge(16× L40S)。
- 一个挂载到集群上的 Amazon FSx for Lustre 文件系统,其中包含一个位于
/fsx、名为fsx-claim的PersistentVolumeClaim。 - 支持 EFA 的实例,以及可用于多节点 SFT 的、正常工作的 NVIDIA Collective Communications Library(NCCL)和
aws-ofi-nccl软件栈。 - 一个容器镜像仓库,例如 Amazon Elastic Container Registry(Amazon ECR),用于存放从参考仓库构建的训练镜像。
- 一个用于
openai/gpt-oss-20b和HuggingFaceH4/Multilingual-Thinking数据集的 HuggingFace 访问令牌。 - 你的工作站上可用的 AWS 命令行界面(AWS CLI)、
kubectl、docker和envsubst。
设置训练环境
下文引用的所有命令、清单和脚本都位于 awsome-distributed-ai GitHub 仓库的 3.test_cases/pytorch/trl/gpt-oss-lora-grpo/ 目录下。克隆该仓库并切换到测试用例目录:
git clone https://github.com/awslabs/awsome-distributed-ai
cd awsome-distributed-ai/3.test_cases/pytorch/trl/gpt-oss-lora-grpo
复制环境模板,然后编辑 env_vars,设置你的 ECR 镜像仓库、镜像名称、标签和 HuggingFace 令牌:
cp env_vars.example env_vars
source env_vars
构建训练镜像并推送到你的镜像仓库。该镜像打包了 PyTorch、TRL、HuggingFace Transformers、PEFT 以及训练和推理脚本:
cd artifacts && ./build_push.sh && cd ..将 kubectl 指向你的集群,并应用 FSx 存储管理器 pod。该存储管理器为你提供一个进入共享文件系统的 shell,用于检查点转换和评估日志检查:
aws eks update-kubeconfig --name <YOUR_CLUSTER_NAME> --region us-east-2
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/fsx-storage-manager.yaml | kubectl apply -f -
使用 SFT 和 LoRA 微调 GPT-OSS-20B
我们首先测量基础模型的表现,然后配置 SFT 运行并检查结果。
基础模型的差距
基础 GPT-OSS-20B 在 50 个用例的评估中得分为 22% 的推理-语言正确率(11/50)。分语言来看:英语 100%,法语 0%,德语 10%,西班牙语 0%,意大利语 0%。无论指令如何,该模型都默认使用英语进行推理。
SFT 配置
SFT 设置使用 LoRA r=8、α=16,在 4× ml.g6e.12xlarge(16× L40S 48GB)上训练 1,000 步,采用 Fully Sharded Data Parallel(FSDP)全分片、bf16 精度和梯度检查点。该作业以由 Kueue 管理的弹性 HyperPodPyTorchJob 形式运行,通过 hyperpodrun 启动。
应用 SFT 清单:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < hyperpod-eks/train-lora-hyperpod-elastic-g6e.yaml | kubectl apply -f -
观察训练进度:
kubectl get pods -l app=gpt-oss-lora-elastic
kubectl logs -f -l app=gpt-oss-lora-elastic
每一步都会输出损失值和梯度范数。健康的运行看起来像这样:
{'loss': 1.035, 'grad_norm': 0.163, 'learning_rate': 0.0002, 'mean_token_accuracy': 0.716, 'epoch': 3.25}
{'loss': 1.003, 'grad_norm': 0.171, 'lr': 0.0002, 'acc': 0.722, 'epoch': 3.32}
{'loss': 0.976, 'grad_norm': 0.159, 'lr': 0.0002, 'acc': 0.726, 'epoch': 3.57}
训练完成后,将 FSDP 检查点转换为 TRL 的 GRPO 训练器和推理脚本所要求的参数高效微调(PEFT)格式:
kubectl exec -it fsx-storage-manager -- python /app/convert_fsdp_checkpoint.py \
  --checkpoint /fsx/checkpoints/checkpoint-1000 \
  --output    /fsx/checkpoints/converted-peft/lora-checkpoint-1000-peft
SFT 结果与分阶段学习曲线
SFT 之后,模型在所有五种语言中100% 的时间都能用正确的语言推理(50/50)。SFT 通过两个阶段学会了这一点:
- 在大约第 200 步,模型学会了用目标语言推理(推理语言指标达到 100%)。
- 在大约第 1000 步,模型还学会了用目标语言给出答案。
SFT 最终评估(第 1000 步):
- 推理语言正确率:100%(50/50)。
- 答案语言正确率:62%(31/50)。
- 两者皆正确:62%(31/50)。
- 各语言答案准确率:法语 60%,德语 60%,西班牙语 30%,意大利语 60%,英语 100%。
要点:在这里 SFT 不是可选项。基础模型完全无法遵循推理语言的指令,而 SFT 把推理语言正确率从 22% 提升到 100%。剩下的差距在于答案语言的 62%。这是更难的一半,因为最终答案很短,而英语先验在其中最强。
用 GRPO 改进答案语言
答案语言显然是 GRPO 的目标。SFT 已经能 100% 地进行正确推理,且模型有时会用正确的语言给出答案,因此存在可强化的信号。
在 SFT 检查点之上运行 GRPO
我们以 SFT 检查点为起点,使用 TRL 的 GRPOTrainer 运行 GRPO。具体设置:加载 SFT LoRA,调用 merge_and_unload,并添加新的 LoRA(r=8,α=16,约 0.068% 的可训练参数,20B 中占 13.6M)。训练采用每个提示 K=8 个生成结果、device_map=auto、学习率 1e-6,共 10 个 epoch。奖励函数对答案语言(±5.0)、推理语言(±1.5)和简洁性(+0.5 或 −1.0)打分,综合范围为 −7.5 到 +7.0。
从转换后的 SFT 检查点启动 GRPO:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/train-grpo-singlenode.yaml | kubectl apply -f -
kubectl logs -f grpo-single
GRPO 将检查点写入 /fsx/checkpoints/grpo-singlenode/。根据留出评估集挑选最佳检查点(本次运行中答案语言指标很早就达到峰值),并将其转换为 PEFT 格式以便推理和评估。
结果(基于 SFT 检查点):
- 推理语言正确率:100%(保持:GRPO 没有破坏 SFT 学到的内容)。
- 答案语言正确率:62% 到 70%(+8 个百分点,35/50)。
- 两者皆正确:70%。
- 各语言答案:法语 70%,德语 80%,西班牙语 60%,意大利语 40%,英语 100%。
GRPO 在答案语言指标上带来了实实在在的 +8 个百分点提升,同时推理语言保持在 100%。提升来自有提升空间的地方。答案语言是 SFT 未能完全收敛的“时而正确”的行为,而 GRPO 对其进行了强化。
并排对比基础模型、SFT 和 GRPO 的推理结果
为了观察定性差异,部署三个推理 Pod,它们共享同一个基础模型但加载不同的适配器:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/inference-g6e-base.yaml    | kubectl apply -f -
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/inference-g6e-trained.yaml | kubectl apply -f -
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/inference-g6e-grpo.yaml    | kubectl apply -f -
对每个变体运行同一个法语推理提示:
kubectl exec -it inference-base    -- python /app/inference_g6e.py \
  --reasoning_language French

kubectl exec -it inference-trained -- python /app/inference_g6e.py \
  --checkpoint /fsx/checkpoints/converted-peft/lora-checkpoint-1000-peft \
  --reasoning_language French

kubectl exec -it inference-grpo    -- python /app/inference_grpo_new.py \
  --use_grpo \
  --grpo_checkpoint /fsx/checkpoints/converted-peft/checkpoint-1470-peft \
  --reasoning_language French
基础模型 Pod 无视指令用英语推理。SFT Pod 用法语推理但经常用英语回答。GRPO Pod 则用法语推理和回答。要复现此前生成这些数字的完整 50 例评估,请运行评估清单并从 FSx 存储管理器读取结果文件:
envsubst '$REGISTRY $IMAGE $TAG $HF_TOKEN' \
  < kubernetes/eval-grpo.yaml | kubectl apply -f -
kubectl logs -f eval-grpo
kubectl exec fsx-storage-manager -- \
  cat /fsx/experiments/grpo_eval_checkpoint1470_*.txt
为了更全面地了解 GRPO 何时能带来价值,我们在 Qwen2.5-7B 上针对两个能力差距不同的任务进行了一项对照实验。
用 Qwen2.5-7B 对照实验验证该模式
为了在不同的模型和不同的任务上测试“匹配技术与能力差距”这一论点,我们在 Qwen2.5-7B-Instruct 上进行了对照实验。第一个任务是同样的多语言推理任务(存在提升空间)。第二个任务是 GSM8K,模型已达到准确率峰值。这是一项内部实验,公开仓库尚未发布。
基础设施:2× g6e.48xlarge(16× L40S)、EFA 100Gbps、FSx Lustre、Ray 2.44 + KubeRay 1.4.2、veRL v0.6.1、vLLM 0.8.4。
实验组:A = 基线,B = 仅 SFT,C = SFT+GRPO。
多语言推理(50 个案例)
| 指标 | A 基线 | B SFT | C SFT+GRPO | Δ GRPO |
| 结构化格式 | 0% | 92% | 98% | +6 |
| 推理语言 | 0% | 96% | 98% | +2 |
| 答案语言 | 0% | 38% | 44% | +6 |
| 两者均正确 | 0% | 38% | 44% | +6 |
GSM8K,一个没有提升空间的任务
在 GSM8K 上,基线 Qwen2.5-7B 已经达到 90.5%(181/200)。GRPO 在第 30 步同样得到 90.5%。当大多数采样组全部正确时,组相对优势会坍缩为零,因此没有学习信号。这正是该论点的另一半:GRPO 需要提升空间(pass@k 远大于 pass@1)才有可优化的东西。没有提升空间就没有收益。
最佳实践
- 从 SFT 开始。GRPO 无法教会模型基线概率为零的行为。它只能强化模型偶尔已经能产生的回答。SFT 将推理语言的比例从 22% 提升到 100%,本工作中 GRPO 的每一次提升都建立在该 SFT 检查点之上。
- SFT 和 GRPO 都使用 LoRA。LoRA r=8/α=16 参数高效(可训练参数仅 0.068%),并且在 Qwen 对照实验中整个 GRPO 过程数值保持稳定(梯度范数 0.23,每 GPU 约 11.7 GB)。当你希望 SFT 和 GRPO 共用相同的适配器形状时,这是一个很好的默认选择。
- 根据差距匹配技术。缺失的行为用 SFT。已有但偶尔正确的行为用 GRPO 精炼。GRPO 在这里的实际上限是 +6 到 +8 分。
- 在花费 GPU 时数之前先检查奖励提升空间。如果大多数组全部正确(GSM8K 基线 90.5%),组相对优势会坍缩为零,GRPO 得不到任何梯度。在启动 GRPO 运行之前,先验证存在提升空间(pass@k 远大于 pass@1)。
清理资源
为避免持续产生费用,请先删除工作负载资源,然后删除底层基础设施:
- Delete the training and inference pods and jobs:
kubectl delete hyperpodpytorchjob lora-hyperpod-elastic --ignore-not-found kubectl delete pod grpo-single inference-base inference-trained inference-grpo \ eval-grpo fsx-storage-manager --ignore-not-found - 缩减或删除 Amazon SageMaker HyperPod 集群或其节点组。
- 在导出所有想要保留的检查点之后,删除 Amazon FSx for Lustre 文件系统。
- 删除任何用于训练数据或检查点归档的 Amazon Simple Storage Service(Amazon S3)存储桶或对象。
结论
我们展示了如何在 Amazon SageMaker HyperPod 上微调 GPT-OSS-20B 以进行多语言推理,以及如何在 SFT 和 GRPO 之间做出选择。SFT 完成了大部分工作:推理语言的比例从 22% 提升到 100%。在存在提升空间的地方,GRPO 在其之上增加了切实但适度的精炼(答案从 62% 提升到 70%)。平行的 Qwen2.5-7B 对照实验证实了这一模式。GRPO 在有改进空间的多语言推理上增加了 +6%。而在模型已达到准确率峰值(90.5%)的 GSM8K 上,它没有带来任何收益。
决策框架:
- 模型完全无法做到的行为:使用 SFT。
- 模型偶尔能做到且存在提升空间的行为:使用 SFT 再加 GRPO 以再争取几个百分点。
- 模型已达到最高准确率,或目标的基础概率为零:GRPO 不会带来帮助。
要亲自尝试,请浏览 awsome-distributed-ai 仓库中的测试用例。有关 Amazon SageMaker HyperPod 的更多信息,请参阅服务详情页面和 Amazon SageMaker HyperPod 文档。有关在 Amazon SageMaker HyperPod 上使用 Ray 的演练,请参阅相关文章 Running distributed training on Amazon SageMaker HyperPod with Ray and Amazon SageMaker Studio。该链接将在那篇文章发布后添加。欢迎在评论中分享你的结果。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com