用 Amazon Bedrock 与 Spring AI 构建自主 AI 智能体
Build autonomous AI agents with Amazon Bedrock and Spring AI
AWS 演示了 Java 团队如何用 Spring AI 2.0、spring-ai-agentcore 2.0 与 Amazon Bedrock AgentCore 构建自主 AI 智能体,实现规划、工具调用和跨会话记忆。
Java 团队已经建立了成熟的 JVM 工具链、持续集成与持续交付(CI/CD)流水线以及运维模式,但将 AI 智能体从原型推向生产环境仍然困难重重:智能体框架默认并不解决可扩展性、治理、安全和运维方面的问题。Amazon Bedrock 和 Spring AI 弥补了这些差距,使 Java 团队能够构建自主的 AI 智能体,这些智能体可以规划、调用工具和 API,并在多轮对话中保持上下文。Agentic AI(智能体 AI)正从提示-响应式的交互,转向执行复杂多步骤任务的自主系统。
Java 仍然是企业软件中使用最广泛的编程语言之一。团队已有围绕 JVM 构建的 CI/CD 流水线、运维经验和成熟模式。Spring AI 通过熟悉的 Spring 模式(自动配置、依赖注入和可组合的 advisor)为 JVM 带来 AI 能力。开发者可以使用与构建 REST API、安全和数据访问相同的惯用方式来构建 AI 智能体。
Amazon Bedrock AgentCore 是一个大规模构建、连接和优化智能体的平台,支持任何框架或模型。借助 AgentCore,你可以大规模地构建、部署和运维 AI 智能体。它与框架无关、与模型无关:你可以使用自己偏好的智能体框架和基础模型(FM)。借助 AgentCore,你可以访问所需的生产级基础设施:托管运行时、记忆、浏览器自动化、代码执行和身份管理。
在本文中,我们将介绍如何使用 Spring AI、Amazon Bedrock 以及 spring-ai-agentcore 在 Java 中构建自主 AI 智能体。我们探讨了两个系统的关键实现模式。第一个是展示工具调用和记忆的单智能体旅行助手。第二个是多智能体智能文档处理(IDP)系统,展示专业智能体、规则引擎和告警如何协同工作。
先决条件
要跟随本演练操作,你需要满足以下条件:
- Java – JDK 21(必需)
- Spring Boot – 4.1(包含 Spring AI 2.0 和 spring-ai-agentcore 2.0)
- Maven – 3.9+。
- Node.js – 18+(用于 React 前端)
- Terraform – 1.5+。
- Docker – 带有用于多架构构建的 Buildx。
- AWS 命令行界面(AWS CLI) – v2,已配置凭证。
- 一个 AWS 账户。
是什么让一个系统成为智能体
一次聊天补全调用可以生成文本,但它无法决定下一步做什么、访问外部系统,或记住昨天发生了什么。智能体可以做到这些,因为它集成了三种能力:
- 规划 – 给定一个目标,模型将其分解为若干步骤,确定优先级,并随着新信息的到来调整计划。
- 工具使用 – 除了生成文本之外,模型还可以选择并调用外部函数(如 API、数据库和代码解释器)来在世界中执行操作。
- 记忆 – 上下文在轮次之间(短期)和会话之间(长期)得以延续,因此每个决策都建立在此前的信息之上。
检索增强生成(RAG)应用的工具使用有限(仅限检索),但没有规划循环。智能体则同时具备这三种能力,在以目标为导向的循环中运行,直到任务完成或它判断无法继续推进为止。
下图展示了从请求到有依据的回答,这些能力在端到端智能体流水线中的体现。
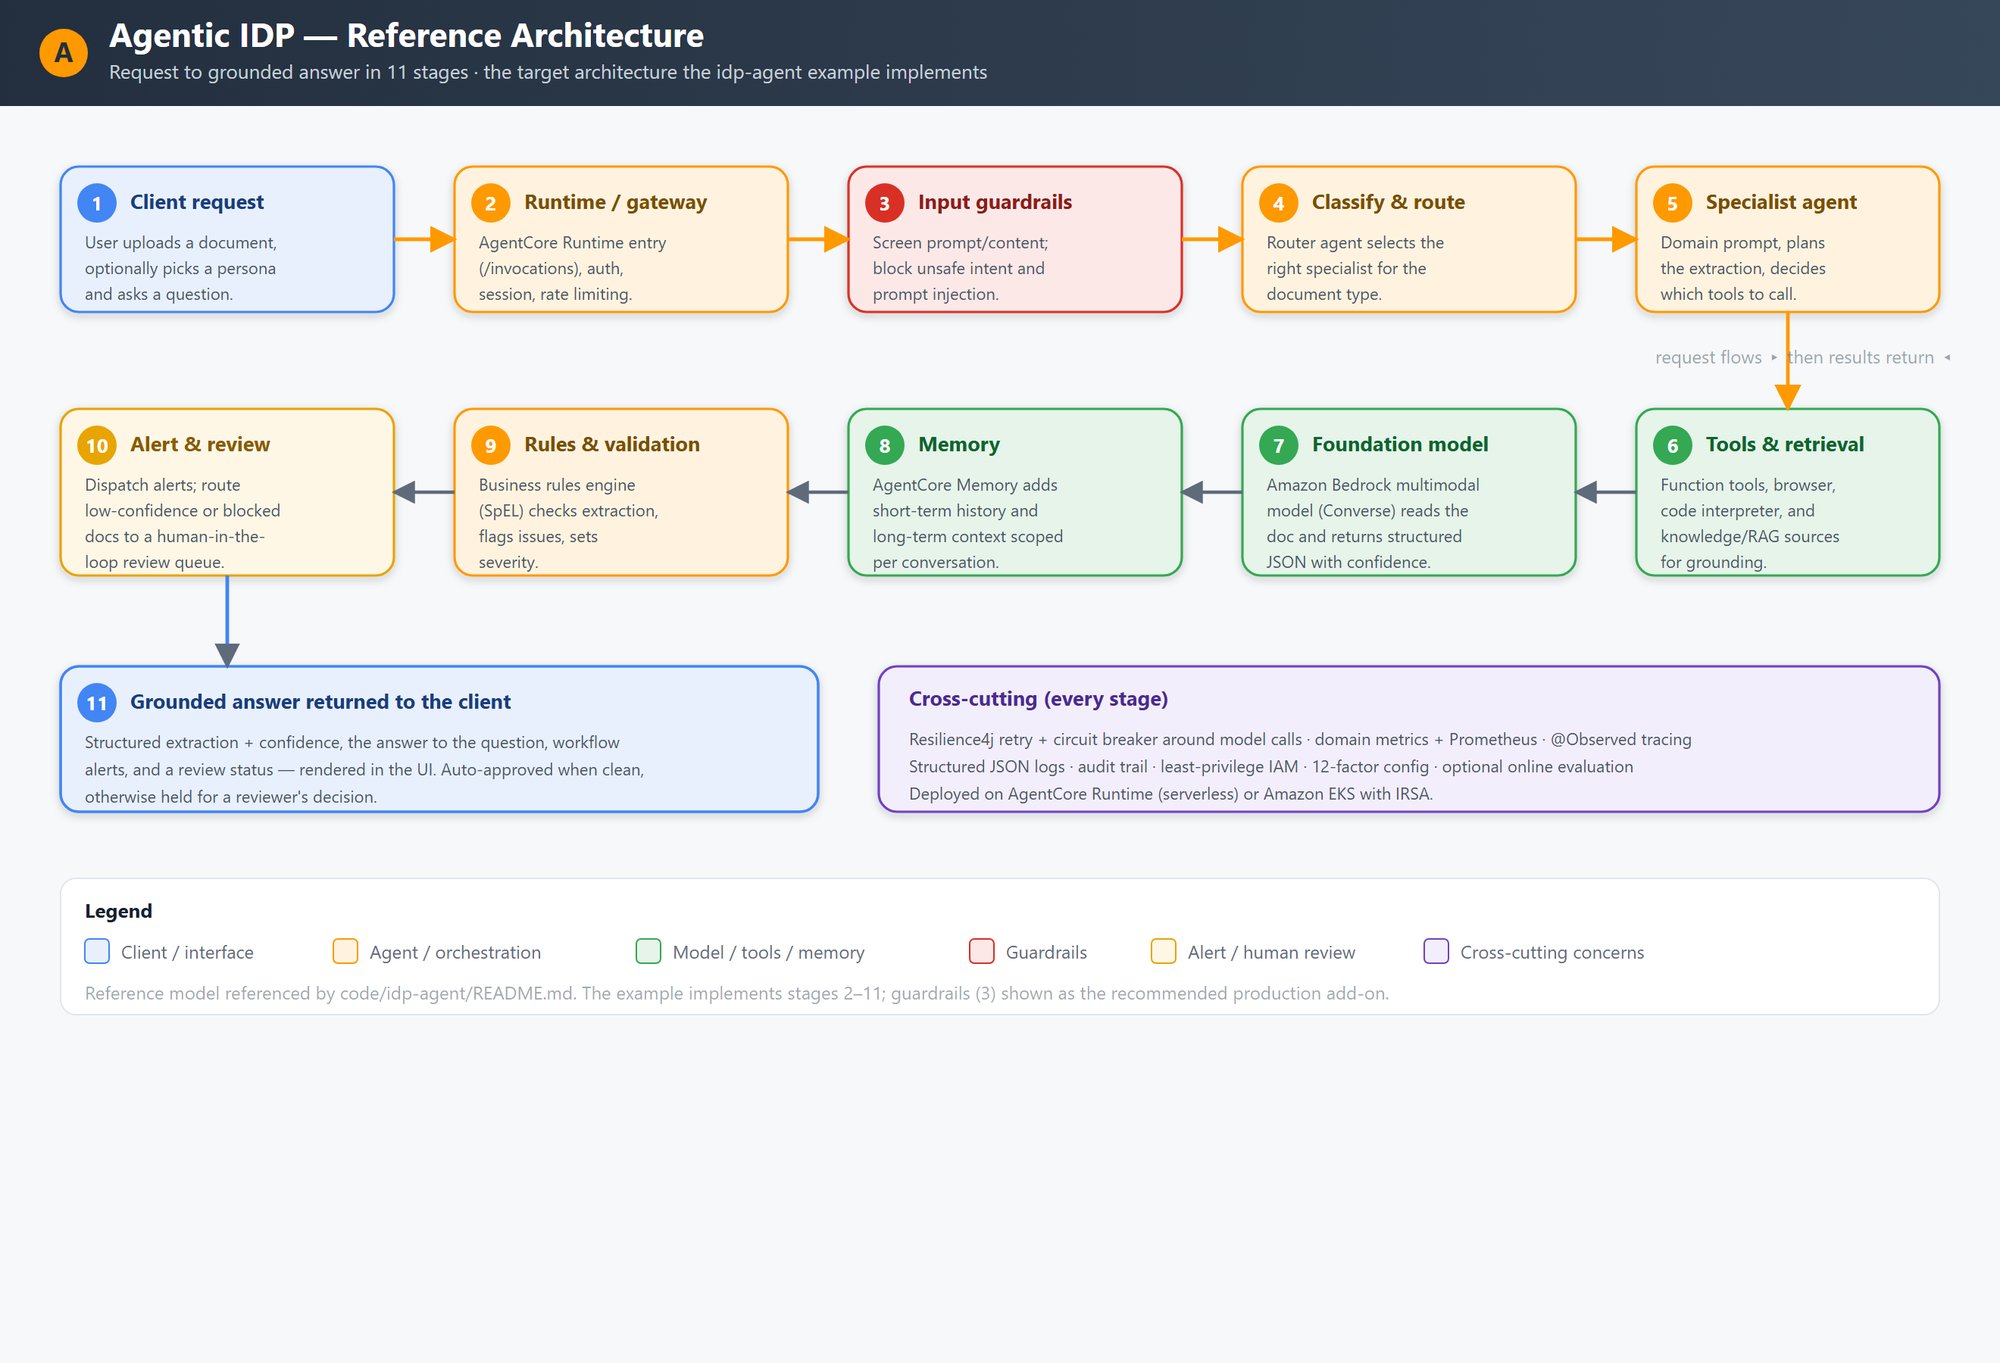
图 1:智能体参考架构。请求流经运行时、防护栏、分类、专业智能体、工具、基础模型、记忆、规则和人工审核,最终得出有依据的答案,其中韧性和可观测性是贯穿全局的关注点
该流水线共有 11 个阶段。客户端提交一份文档和一个问题。请求首先通过运行时网关进行身份验证和速率限制,然后输入防护栏筛选有害内容。路由器对文档进行分类,并将其路由到专业智能体,该智能体规划其工作流程,并按需调用工具、Amazon Bedrock 基础模型、记忆和规则引擎。低置信度或被标记的结果会进入人工审核队列,然后有依据的答案才返回给客户端。韧性、可观测性、日志记录和最小权限 AWS Identity and Access Management (IAM) 适用于所有阶段。
解决方案概述
该解决方案由两个共享通用模式的可部署系统组成:
- 旅行智能体 – 一个具备工具调用(天气查询、行程搜索)、流式响应、对话记忆和韧性模式的单一自主智能体。这是推荐的起点。
- IDP 多智能体系统 – 一个多智能体智能文档处理平台,拥有五个专业智能体(Lawyer、Mortgage、Insurance、Tax、General)、规则与工作流引擎、告警和可观测性。这在一定规模上展示了生产环境模式。
两个系统共享以下架构:
- 带有 Spring AI ChatClient、Spring AI agentcore 和 Amazon Bedrock Converse API 的 Spring Boot 应用。
- AgentCore runtime 是 Amazon Bedrock AgentCore 的一项能力,为托管部署定义契约(POST
/invocations、GET/ping)。 - 通过 AgentCore memory(Amazon Bedrock AgentCore 的一项能力)实现对话记忆,支持短期和长期上下文。
- 使用带有
@Tool注解的方法进行工具调用。 - 映射到 Java records 的结构化输出。
- 针对 AWS Graviton 优化的 ARM64 容器镜像。
- 用于基础设施预置的模块化 Terraform。
旅行助手是推荐的起点。下图展示了 Spring Boot 智能体如何与 AgentCore runtime、工具、记忆以及 Amazon Bedrock 上可用的模型进行交互。
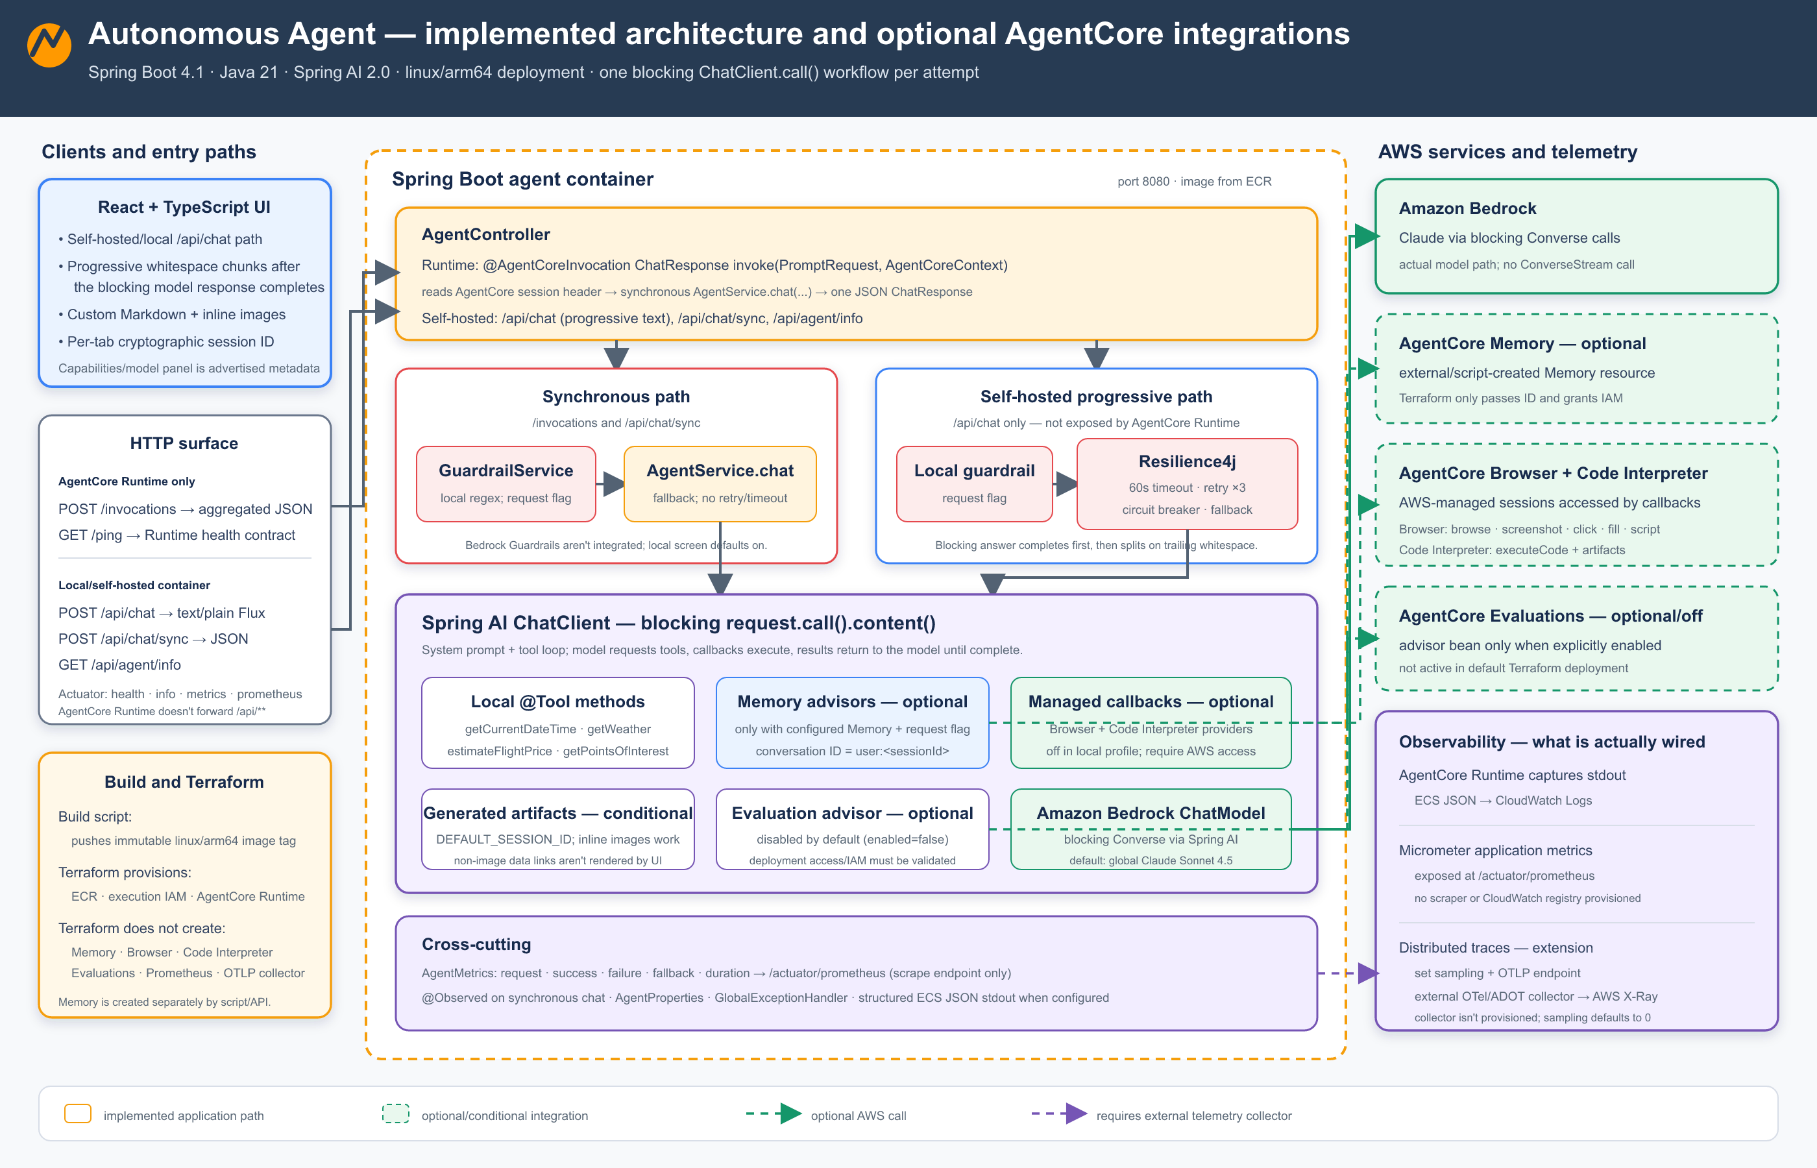
图 2:单智能体旅行助手。Spring Boot 应用既为 React UI 提供 REST 端点,也提供 AgentCore runtime 契约,通过 Converse API 调用 Amazon Bedrock,同时工具调用、流式传输和记忆都在同一个代码库内运行。
旅行助手运行一个单一的 Spring Boot 应用,包含两个入口点,即 AgentCore runtime 所要求的 /invocations 和 /ping 契约。Spring AI 通过 Converse API 编排对 Amazon Bedrock 的调用,并在同一进程内本地解析工具调用。服务器发送事件 (SSE) 在 token 生成时将其流式传输给客户端。AgentCore memory 同时提供会话内的短期上下文和跨会话的长期上下文,因此智能体无需外部状态管理即可保留对话历史。
下图展示了 IDP 多智能体系统的架构。
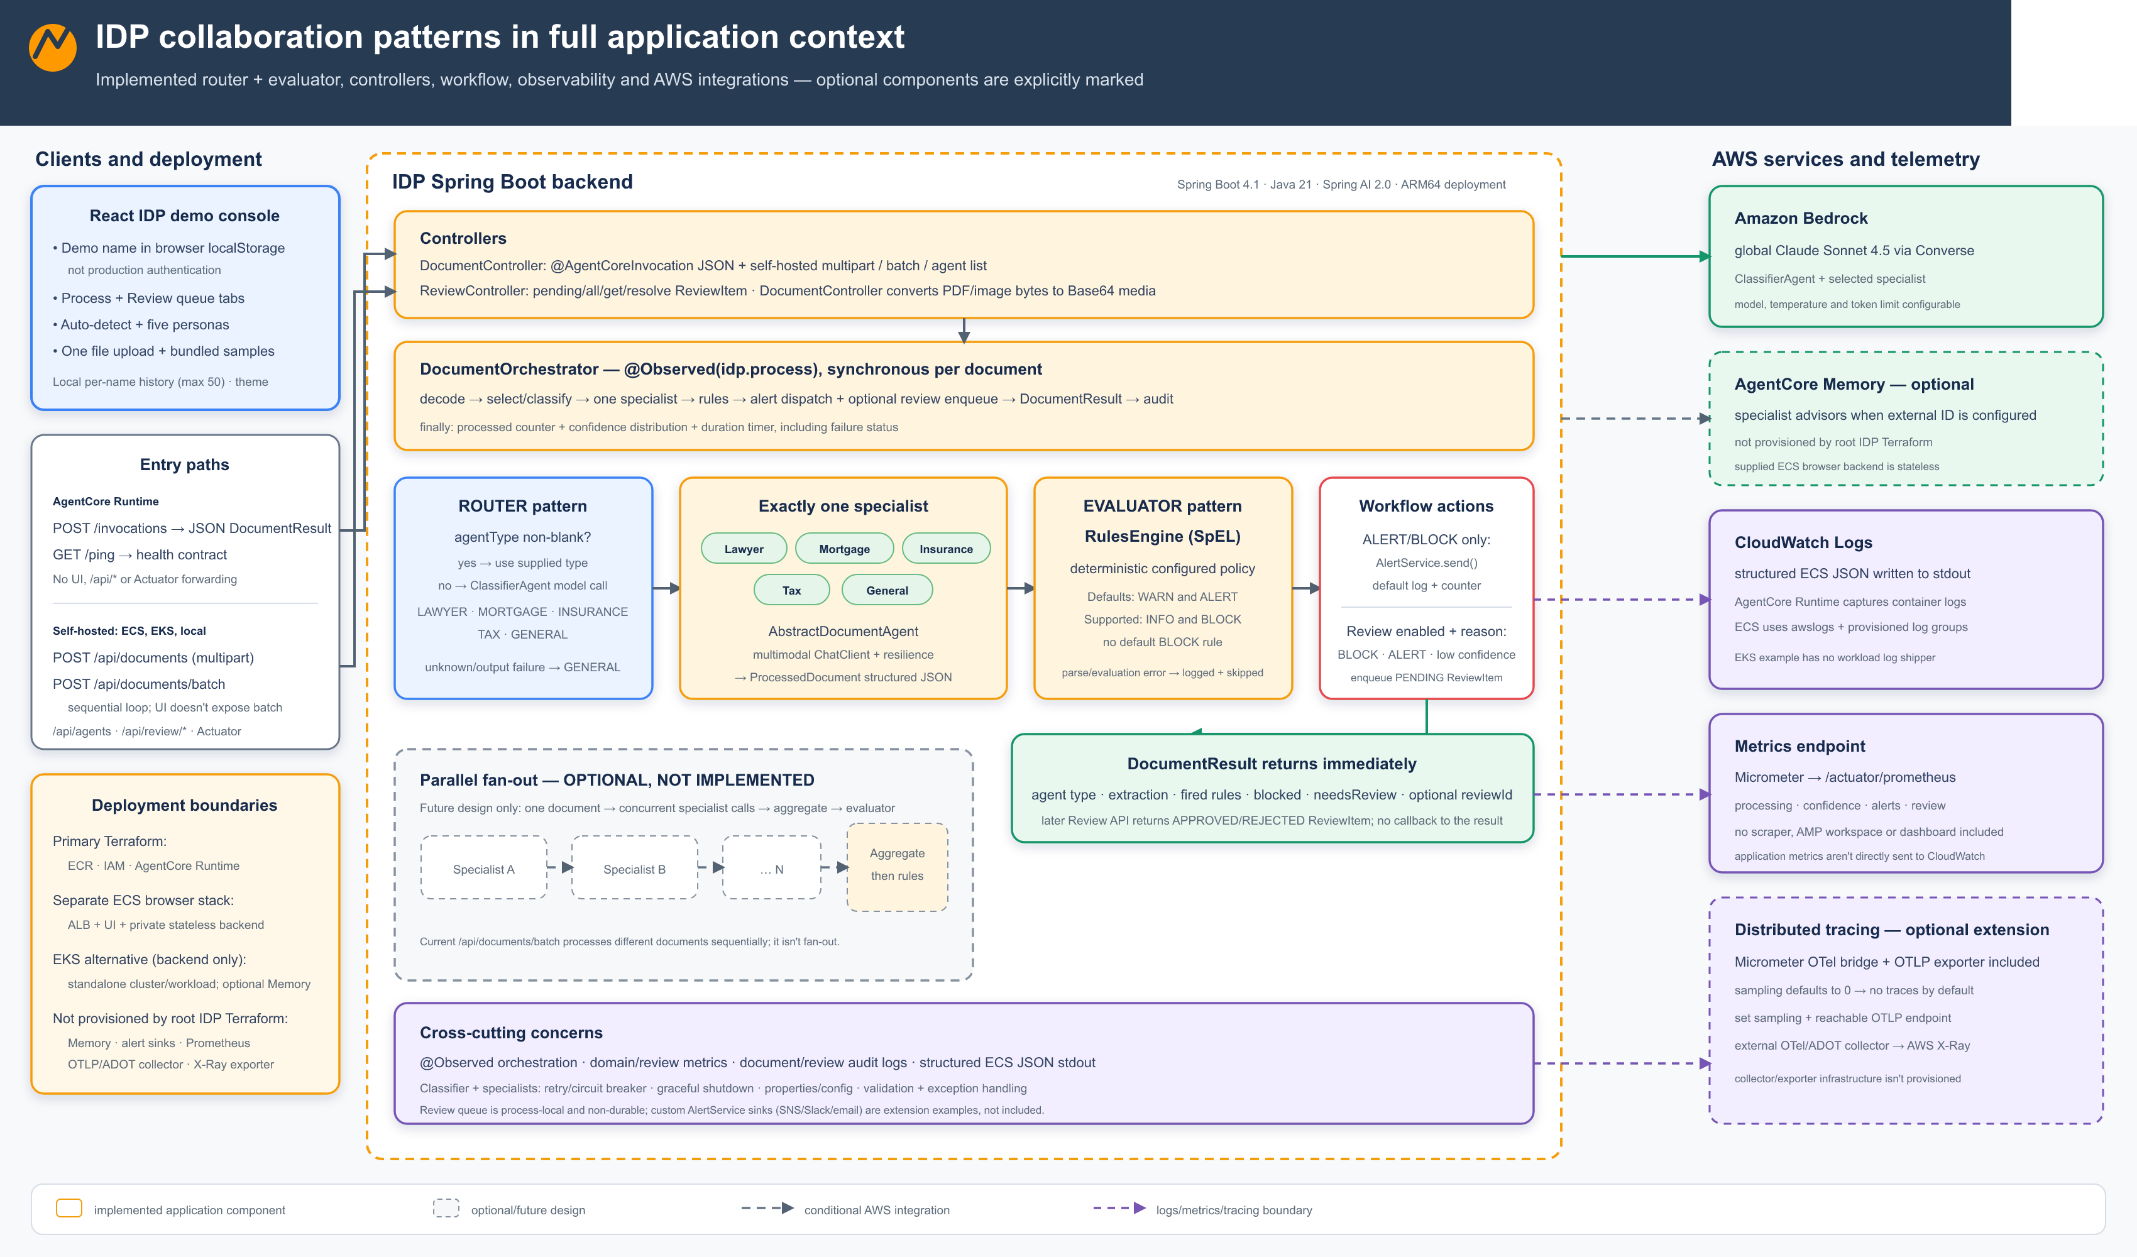
图 3:IDP 多智能体系统架构。专业智能体通过共享的 ChatClient 模式处理文档,结果流经规则引擎和告警服务。
IDP 多智能体系统将文档路由到五个专家智能体(Lawyer、Mortgage、Insurance、Tax 和 General),每个智能体都基于共享的 AbstractDocumentAgent 模板构建。ClassifierAgent 读取每份文档并将其转发给相应的专家。专家使用 Amazon Bedrock 的多模态 Converse API 提取带有置信度分数的结构化 JSON。规则引擎将来自 application.yml 的 Spring Expression Language (SpEL) 表达式与提取结果进行评估。ALERT 或 BLOCK 严重级别的规则通过 AlertService 进行分发。低置信度的文档会进入人工审核。指标、审计跟踪、弹性和可观测性适用于所有阶段。
智能体协作模式
当多个智能体协同工作时,它们的协调方式决定了系统行为。本解决方案使用三种模式:
下图对比了本解决方案中使用的三种协调模式。
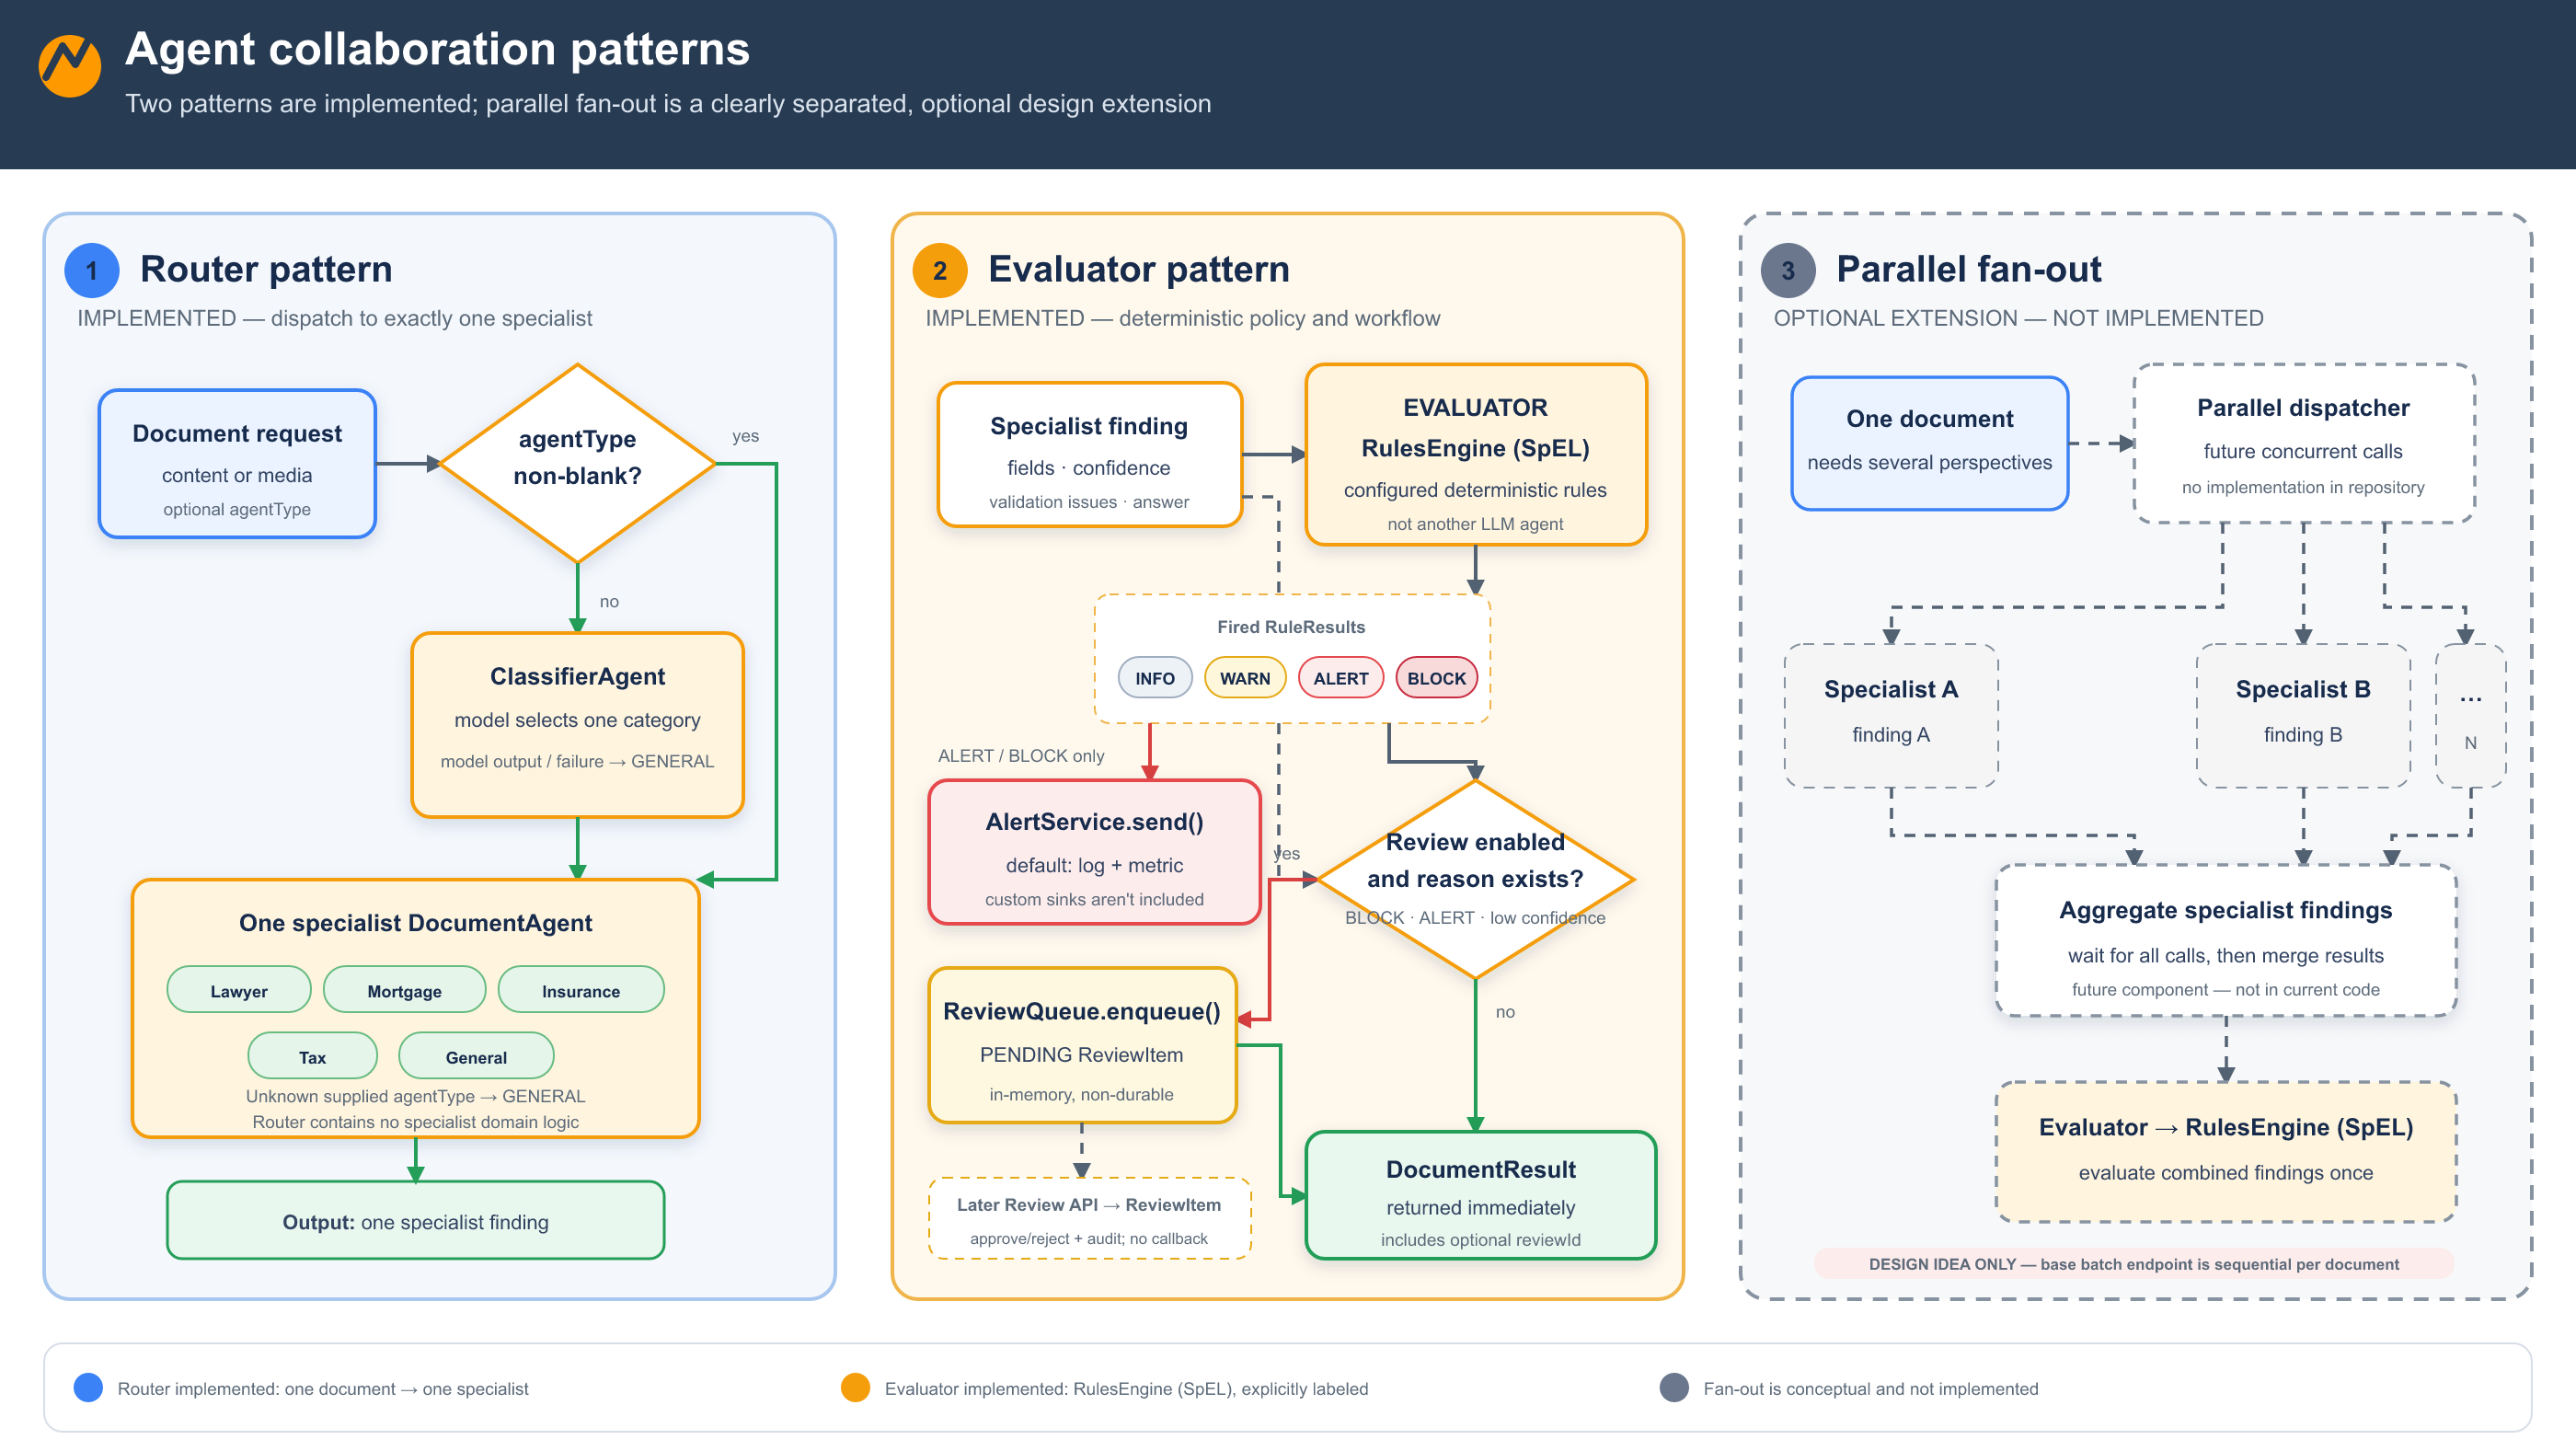
图 4:智能体协作模式
三种模式并排展示。路由器根据文档类型将每个请求分派给一位专家。评估器将专家的发现通过规则引擎处理,规则引擎应用于严重级别,并分发警报或阻止以进行人工审核。并行扇出将一个请求同时发送给多个专家,并在规则引擎运行之前聚合结果。
路由器模式:轻量级编排器检查传入请求并将其路由到相应的专家。在 IDP 多智能体系统中,路由器检查文档类型元数据并将其转发给 Lawyer、Mortgage、Insurance、Tax 或 General 智能体。路由器不包含任何领域逻辑,它只是一个分派层。
并行扇出(可选扩展):基础解决方案实现了路由器和评估器模式。批处理端点按顺序处理文档。当文档需要同时获得多个视角时,你可以添加并行扇出作为即插即用的扩展。并发地分派给专家,并在规则引擎运行之前聚合它们的结果。这样,综合分析的耗时便受限于最慢的单个智能体调用,而不是所有调用的总和。
评估器模式:在专家返回其发现之后,规则引擎会根据可配置的业务规则评估合并后的输出。触发 ALERT 或 BLOCK 严重级别的规则通过可插拔的 AlertService 进行分发,以供人工审核。
演练
以下章节将带你了解关键的实现模式,从 AgentCore 运行时契约开始,逐步介绍工具调用、内存、弹性和多智能体编排。
满足 AgentCore 运行时契约
Amazon Bedrock AgentCore 运行时负责管理智能体的生命周期和扩展。有关当前费率,请参阅 Amazon Bedrock AgentCore 定价和 Amazon Bedrock 定价。运行时将传入请求路由到你的智能体并监控其健康状况。你的智能体必须暴露两个端点:
- POST
/invocations– 接收请求,并以 JSON 或服务器发送事件 (SSE) 流的形式返回响应。 - GET
/ping– 报告健康状态(Healthy或HealthyBusy)。长时间运行的任务必须发出忙碌状态信号,否则运行时可能会缩减智能体的规模。
下图展示了 Spring AI 开发者模型如何映射到 AgentCore 运行时、Memory、Browser、Code Interpreter 和 Evaluations。
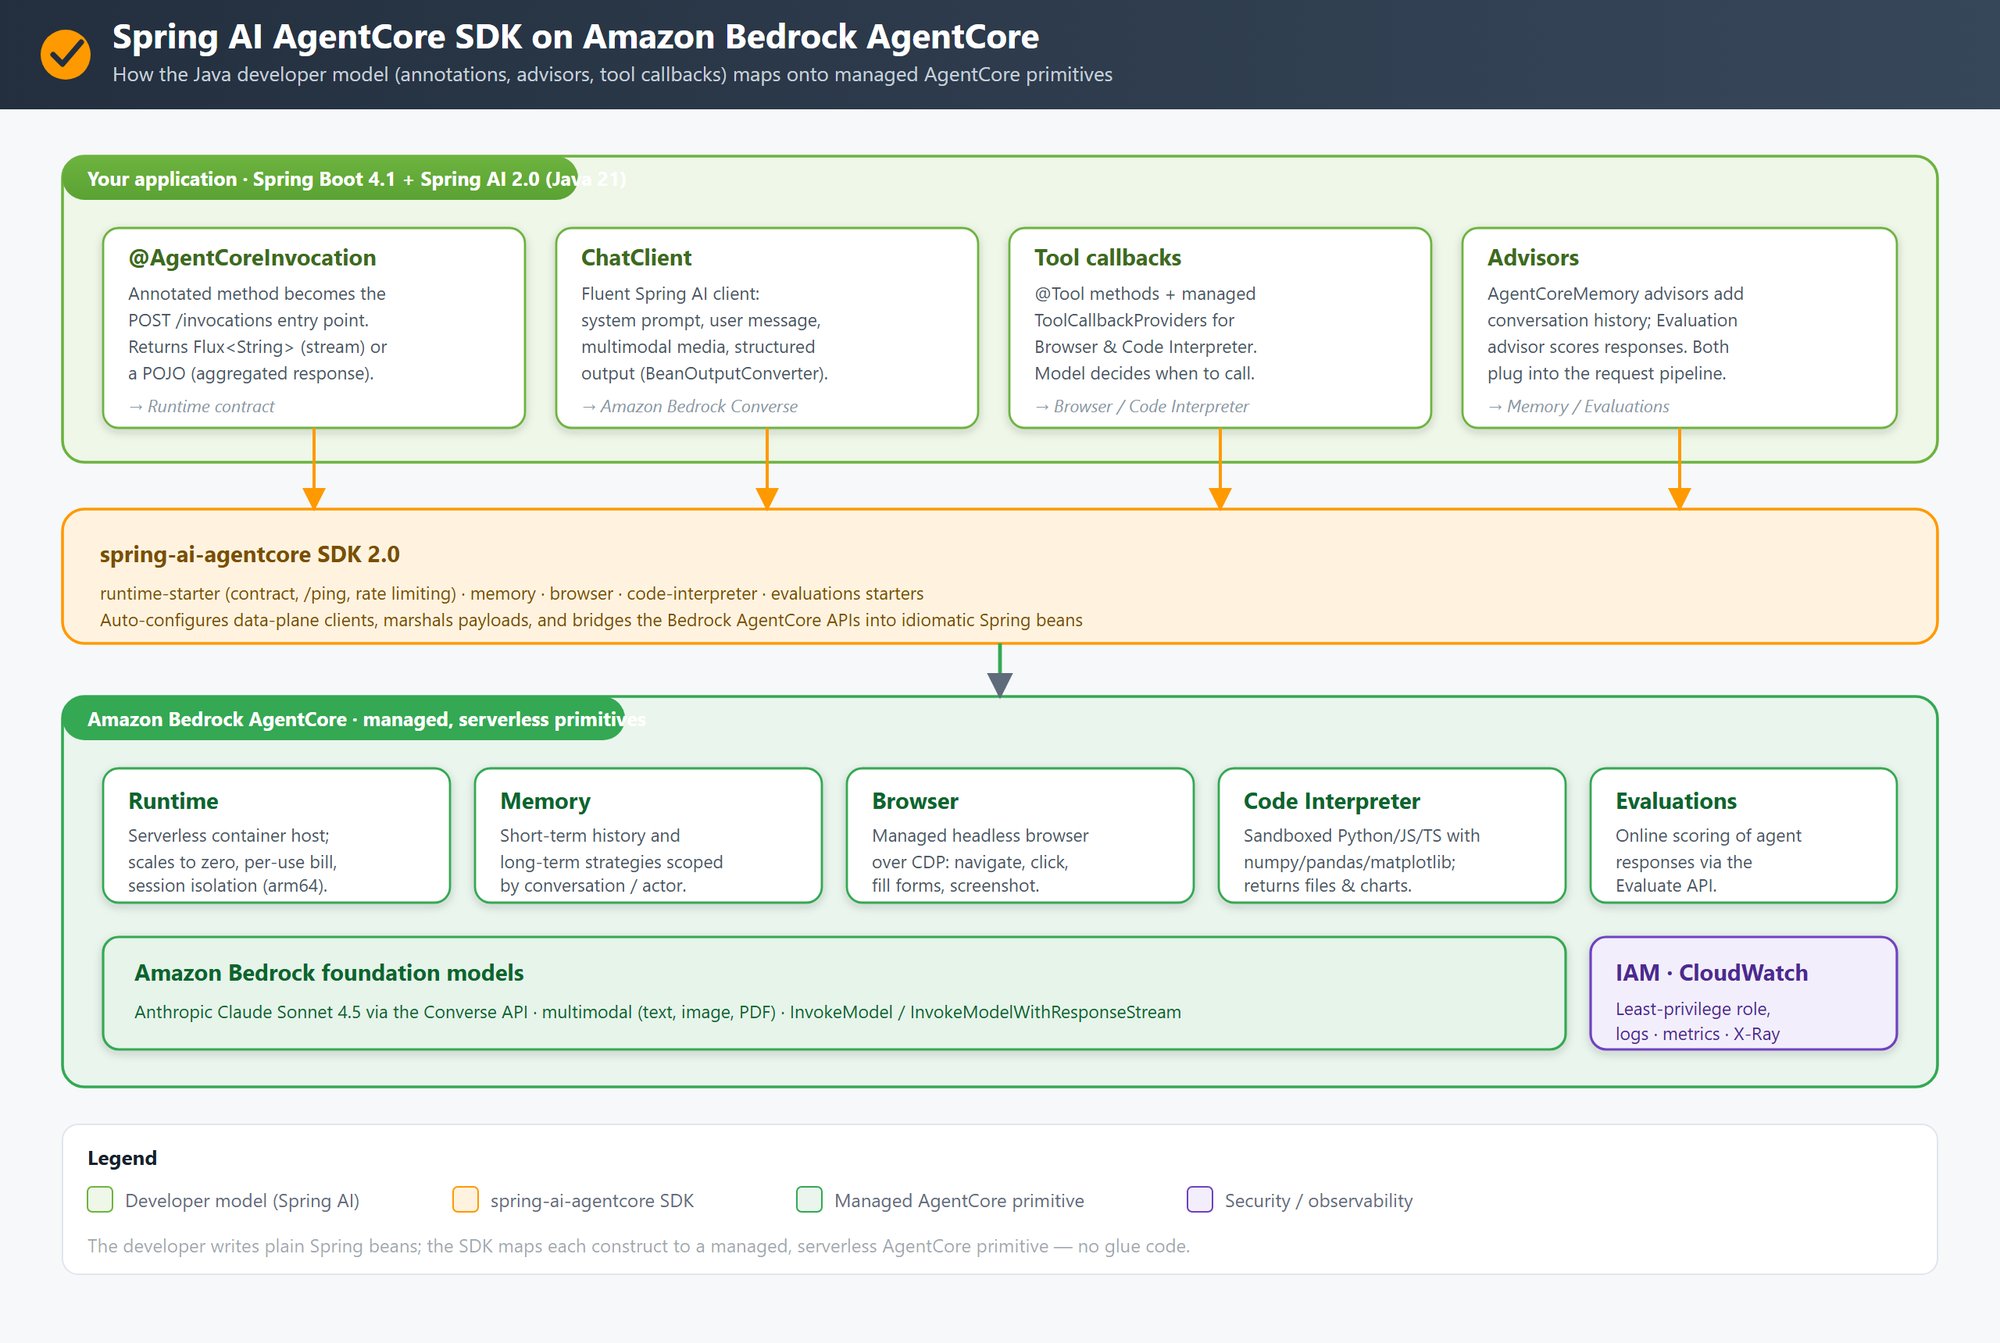
图 5:在 Amazon Bedrock AgentCore 上使用 Spring AI AgentCore SDK。注解、ChatClient、工具回调与 advisor 通过 spring-ai-agentcore SDK 映射到 AgentCore runtime、AgentCore memory、AgentCore Browser、AgentCore Code Interpreter 和 AgentCore Evaluations。
由 spring-ai-agentcore SDK 连接的两层。应用层使用 Spring AI 组件:@AgentCoreInvocation 用于端点接线,ChatClient 用于模型交互,@Tool 回调,以及用于记忆与防护栏的 advisor。基础设施层提供 AgentCore runtime、AgentCore memory、AgentCore Browser、AgentCore Code Interpreter 和 AgentCore Evaluations,这些都是 Amazon Bedrock AgentCore 的能力。SDK 在两层之间架起桥梁,开发者只需编写标准 Spring AI 代码,而由 AgentCore 处理生产基础设施。
借助 Spring AI AgentCore SDK,只需一个注解即可自动处理这一契约:
@Service
public class TravelAgent {
    private final ChatClient chatClient;

    public TravelAgent(ChatClient.Builder builder) {
        this.chatClient = builder.build();
    }

    @AgentCoreInvocation
    public Flux<String> chat(PromptRequest request) {
        return chatClient.prompt()
                .user(request.prompt())
                .stream()
                .content();
    }
}
@AgentCoreInvocation 注解可自动配置 /invocations 和 /ping 端点,处理 JSON 序列化,管理流式响应的 SSE 帧,并报告健康状态。同一项目还为 React UI 暴露了 REST 端点,因此该智能体可以从一个代码库同时服务于 AgentCore runtime 和浏览器。
关于流式传输的一点说明:前面的极简示例直接返回模型流,这非常适合聊天 UI。当智能体发起多参数工具调用时,应先用阻塞式 call() 组装响应,再将结果分块进行流式传输,以确保工具参数可靠绑定。旅行助手通过一个服务方法同时服务 AgentCore runtime 和 React UI:
@RestController
public class AgentController {
    private final AgentService agentService;

    public AgentController(AgentService agentService) {
        this.agentService = agentService;
    }

    // One annotation wires up POST /invocations + GET /ping, JSON/SSE framing, and health.
    @AgentCoreInvocation
    public Flux<String> invoke(PromptRequest request, AgentCoreContext context) {
        String sessionId = context.getHeader(AgentCoreHeaders.SESSION_ID);
        return agentService.streamChat(request.prompt(), sessionId,
                request.guardrailsEnabled(), request.memoryEnabled());
    }

    // The same app also serves the React UI from the same code base.
    @PostMapping(value = "/api/chat", produces = MediaType.TEXT_PLAIN_VALUE + ";charset=UTF-8")
    public Flux<String> chatStream(@Valid @RequestBody PromptRequest request) {
        return agentService.streamChat(request.prompt(), request.sessionId(),
                request.guardrailsEnabled(), request.memoryEnabled());
    }
}
实现工具调用
借助工具调用,模型可以在推理过程中调用外部函数。在 Spring AI 中,你用 @Tool 注解一个方法,模型会决定何时调用它以及使用什么参数:
@Tool(description = "Get a short weather forecast for a city")
public String getWeather(
        @ToolParam(description = "City name") String city) {
    return forecastService.lookup(city);
}
你在 ChatClient 上注册工具,由模型决定何时调用它们:
ChatClient chatClient = chatClientBuilder
        .defaultSystem(properties.getSystemPrompt())
        .defaultTools(new DateTimeTools(), new TravelTools())
        .build();
对于结构化输出,请求一个 Java record 类型。对于多模态输入,将媒体附加到用户消息上:
ProcessedDocument review = chatClient.prompt()
        .system(personaSystemPrompt)
        .user(u -> u.text(question).media(mimeType, fileResource))
        .call()
.entity(ProcessedDocument.class);注意:我们在 Amazon Bedrock 上使用 Anthropic Claude Sonnet 4.5 验证了此示例。Spring AI 会将 record 的 schema 加入提示词,并将回复解析回 Java 类型。其他模型系列的行为可能有所不同,请参阅 Spring AI 结构化输出文档和 Amazon Bedrock 文档以了解当前支持情况。这是尽力而为的方式,意味着模型偶尔可能返回与 schema 不匹配的输出。若需更严格的结果,请使用具有原生 schema 强制能力的提供商,或使用 Spring AI 的校验与重试机制。
模型在其上下文中接收工具定义,推理何时调用工具才能满足用户请求,并返回结构化的工具调用响应。Spring AI 会拦截该响应,调用被注解的方法,并将结果反馈给模型以继续推理。
添加对话记忆
现实中的智能体必须记住用户在对话中早些时候说过的话(工作记忆),以及随时间积累学到的内容(持久记忆)。Spring AI AgentCore SDK 通过 advisor 模式与 AgentCore memory 集成:拦截器在提示词到达模型之前为其注入上下文。
chatClient.prompt()
        .advisors(agentCoreMemory.advisors)
        .advisors(a -> a.param(
                ChatMemory.CONVERSATION_ID, "user:" + sessionId))
        .user(prompt)
        .stream()
        .content();
会话 ID 会以 actor:session 的形式成为对话 ID,因此每个用户的历史记录保持相互隔离。对于面向用户的部署,应从经过验证的 OAuth 2.0(JWT)身份派生 actor,而不是使用客户端提供的值,这样用户就无法访问彼此的历史记录。
此外,AgentCore memory 提供长期记忆支持,采用以下策略来识别和捕捉对话中的关键洞见:
- 语义记忆 – 关于用户的事实信息(例如,“用户从事金融工作”)
- 用户偏好 – 明确的设置和选择(例如,“偏好公制单位”)
- 摘要 – 精简的对话历史,用于跨会话保持连续性。
- 情景记忆 – 过去的交互和学到的经验教训。
长期记忆提取是异步且可选的。你在创建记忆时选择要启用的策略,AgentCore 在每次对话结束后于后台提取并整合记录,因此绝不会阻塞智能体的响应。根据工作负载选择策略:为旅行助手使用用户偏好,使其记住单位和座位选择。当会话跨越多轮时使用摘要。当智能体应复用过去任务的经验时使用情景记忆。而使用语义记忆来保留关于用户的持久事实。
配置规则引擎
阅读文档只是工作的一半。对发现的内容采取行动则是另一半。IDP 多智能体系统包含一个规则引擎,使运维人员无需修改代码即可添加业务检查。这是一个进程内的规则评估器,将 SpEL 条件应用于提取结果,而不是像 AWS Step Functions 这样的工作流编排服务。规则存放在 application.yml 中,每个条件都是一个针对提取结果求值的 SpEL 表达式:
idp:
  review:
    enabled: ${REVIEW_ENABLED:true}
    confidence-threshold: ${REVIEW_CONFIDENCE_THRESHOLD:0.7}
    rules:
      - id: legal-unsigned
        agentType: LAWYER
        condition: "field('signaturePresent') == 'false' || missing('signaturePresent')"
        severity: ALERT
        message: "Document appears unsigned; get all parties to sign before relying on it."
      - id: mortgage-high-dti
        agentType: MORTGAGE
        condition: "field('dtiRatio') != '' && T(java.lang.Double).parseDouble(field('dtiRatio')) > 0.43"
        severity: WARN
        message: "Debt-to-income ratio exceeds 0.43; likely needs manual underwriting."
      - id: low-confidence
        agentType: ALL
        condition: "confidence < 0.6"
        severity: WARN
message: "Low extraction confidence; consider human verification."严重级别控制引擎的行为。INFO 和 WARN 会被记录日志,而 ALERT 则通过可插拔的 AlertService 进行分发。默认实现会记录日志并发出指标,但你可以通过提供自己的 bean 来替换为 Amazon Simple Notification Service(Amazon SNS)、Slack 或电子邮件。BLOCK 会扣留文档以供人工审查。由于规则是运维人员的配置而非最终用户输入,它们提供了一个安全且可审计的扩展点。添加新的工作流只需更改配置,而无需部署。
评估器模式由规则引擎和一个可插拔的 AlertService 实现。默认实现会记录告警日志并发出指标。你可以提供自己的 bean,将告警路由到 Amazon SNS、Slack 或电子邮件:
public class LoggingAlertService implements AlertService {
    @Override
    public void send(RuleResult result, AgentType agentType, ProcessedDocument document) {
        registry.counter("idp.alerts.sent",
                "severity", result.severity().name(), "type", agentType.name()).increment();
        logger.warn("ALERT [{}] rule={} type={} message=\"{}\"",
                result.severity(), result.ruleId(), agentType, result.message());
    }
}
生产就绪模式
以下模式解决了原型通常忽略的常见生产需求。
韧性
每次模型调用都使用带指数退避的 Resilience4j 重试、在模型调用反复失败或超时时快速失败的断路器,以及超时设置。流式路径会发出回退消息而非原始错误。当流量超出你账户和区域的配额时,AgentCore runtime 会返回 HTTP 429,由重试机制处理。有关当前限制,请参阅 Amazon Bedrock AgentCore quotas documentation。
十二要素配置
每个可配置的值(区域、模型 ID、记忆 ID、超时、速率限制、系统提示词)都是绑定到类型化 @ConfigurationProperties 类的环境变量。应用是无状态的,启动快速,在缩容时排空进行中的对话,并作为单个不可变的 ARM64 镜像交付,从开发到生产原样晋级。
安全与身份
Agentcore runtime 默认使用 AWS Identity and Access Management(IAM)身份验证。对于面向用户的智能体,请添加 OAuth 2.0(JWT)授权器(例如 Amazon Cognito),并从已验证的身份派生记忆 actor ID(actorId)。IAM 执行角色遵循最小权限原则:
- Amazon Elastic Container Registry (Amazon ECR) 拉取。
- 范围受限的 Amazon CloudWatch Logs 和 AWS X-Ray。
- Amazon Bedrock InvokeModel 操作。
- 范围受限的工作负载访问令牌(
GetWorkloadAccessTokenForJWT),用于智能体的工作负载身份。 - 仅限于特定 Memory 资源 ARN 的 AgentCore 内存操作。
AgentCore Gateway 是 Amazon Bedrock AgentCore 的一项功能,它强制执行入站身份验证(充当 OAuth 2.0 资源服务器,通过 Cognito、Okta、Auth0 或您自己的 OIDC 提供商验证 JWT bearer 令牌),并支持在网关层配置速率限制。速率限制默认采用 fail-open 策略,因此它应该作为您核心安全控制措施的补充,而非替代。
负责任的 AI 控制
会采取真实世界行动的自主智能体需要将安全控制作为一等关注点。该示例附带一个轻量级进程内预检的替代演示,名为 GuardrailService。该服务会筛查提示词中的违禁意图和提示词注入,并通过 guardrailsEnabled 标志按请求进行开关。生产部署使用 Amazon Bedrock Guardrails 作为应用于每个请求的标准控制,而不是按请求开关。
要将演示服务升级为生产级,请在智能体前端部署 Amazon Bedrock Guardrails。Guardrails 在模型调用之外应用可配置的策略,同时覆盖输入和输出:
- 内容过滤。基于可配置的阈值,阻止针对提示词和响应的有害或离题内容。
- 拒绝主题。防止智能体与您定义为超出范围的主题进行交互。
- 敏感信息过滤器。检测并隐去提示词和响应中的 PII,支持 GDPR 和 HIPAA 等合规要求。
对于检索外部知识的智能体,请启用接地检查,以降低幻觉风险,避免智能体在执行具有真实世界副作用的工具调用之前出错。
要将 Bedrock Guardrails 接入 Spring AI,请实现 CallAdvisor 和 StreamAdvisor 函数,调用 ApplyGuardrail API,并在 ChatClient 上将其注册到 defaultAdvisors。由于策略存放在 guardrail 中,安全团队可以独立于应用发布周期更新过滤器。
可观测性
该示例使用 Micrometer Observation API(@Observed)进行检测,生成计时器;当您添加追踪桥接(OTLP 到 AWS X-Ray)后,这些计时器会转换为分布式追踪 span。系统会发出领域指标:
idp.documents.processed{type,status}
idp.extraction.confidence{type}
idp.alerts.sent{severity,type}
idp.processing.duration{type}
这些指标通过 /actuator/prometheus 暴露。应用程序还会向标准输出输出结构化 JSON 日志,Amazon Bedrock AgentCore 运行时会将其捕获到 Amazon CloudWatch Logs 中。
本文未实现的可选扩展:该示例包含 Micrometer OpenTelemetry 桥接和 OTLP 导出器依赖项,但本文的部署并未配置 OpenTelemetry 收集器或启用追踪采样。您可以通过设置非零的 TRACING_SAMPLING 值、将 OTLP_TRACES_ENDPOINT 指向 OpenTelemetry 或 AWS Distro for OpenTelemetry 收集器,并配置收集器将追踪转发到 AWS X-Ray 来添加分布式追踪。
本文未实现的可选扩展:该示例没有实现自动评估或优化反馈循环。您可以通过将应用指标、追踪、审计事件和人工审核结果保存为评估数据集来添加一个。然后,AgentCore 评估或单独的评估管道可以将版本化的提示词、模型、工具和路由规则与质量、安全性、延迟和成本阈值进行比较。只有在经过评估和人工批准后才推广变更。
部署该解决方案
这个GitHub 仓库包含两个 AI 智能体应用,展示了自主 AI 的不同用例。本指南介绍如何使用 Amazon Bedrock AgentCore runtime 将它们部署到 AWS。
下图展示了部署架构:一个 Arm64 镜像通过模块化 Terraform 推广到 AgentCore runtime,并带有一条可选的 Amazon Elastic Kubernetes Service(Amazon EKS)路径。
可选:在 Amazon EKS 上运行。已经标准化使用 Kubernetes 的团队可以在 Amazon EKS 上运行相同的 Arm64 镜像,利用其现有集群针对 /ping 端点进行扩展和健康检查,并通过 IAM Roles for Service Accounts(IRSA)实现范围受限、最小权限的 Pod 级访问,以访问 Amazon Bedrock 和 AgentCore memory。容器完全相同,应用无需任何更改。
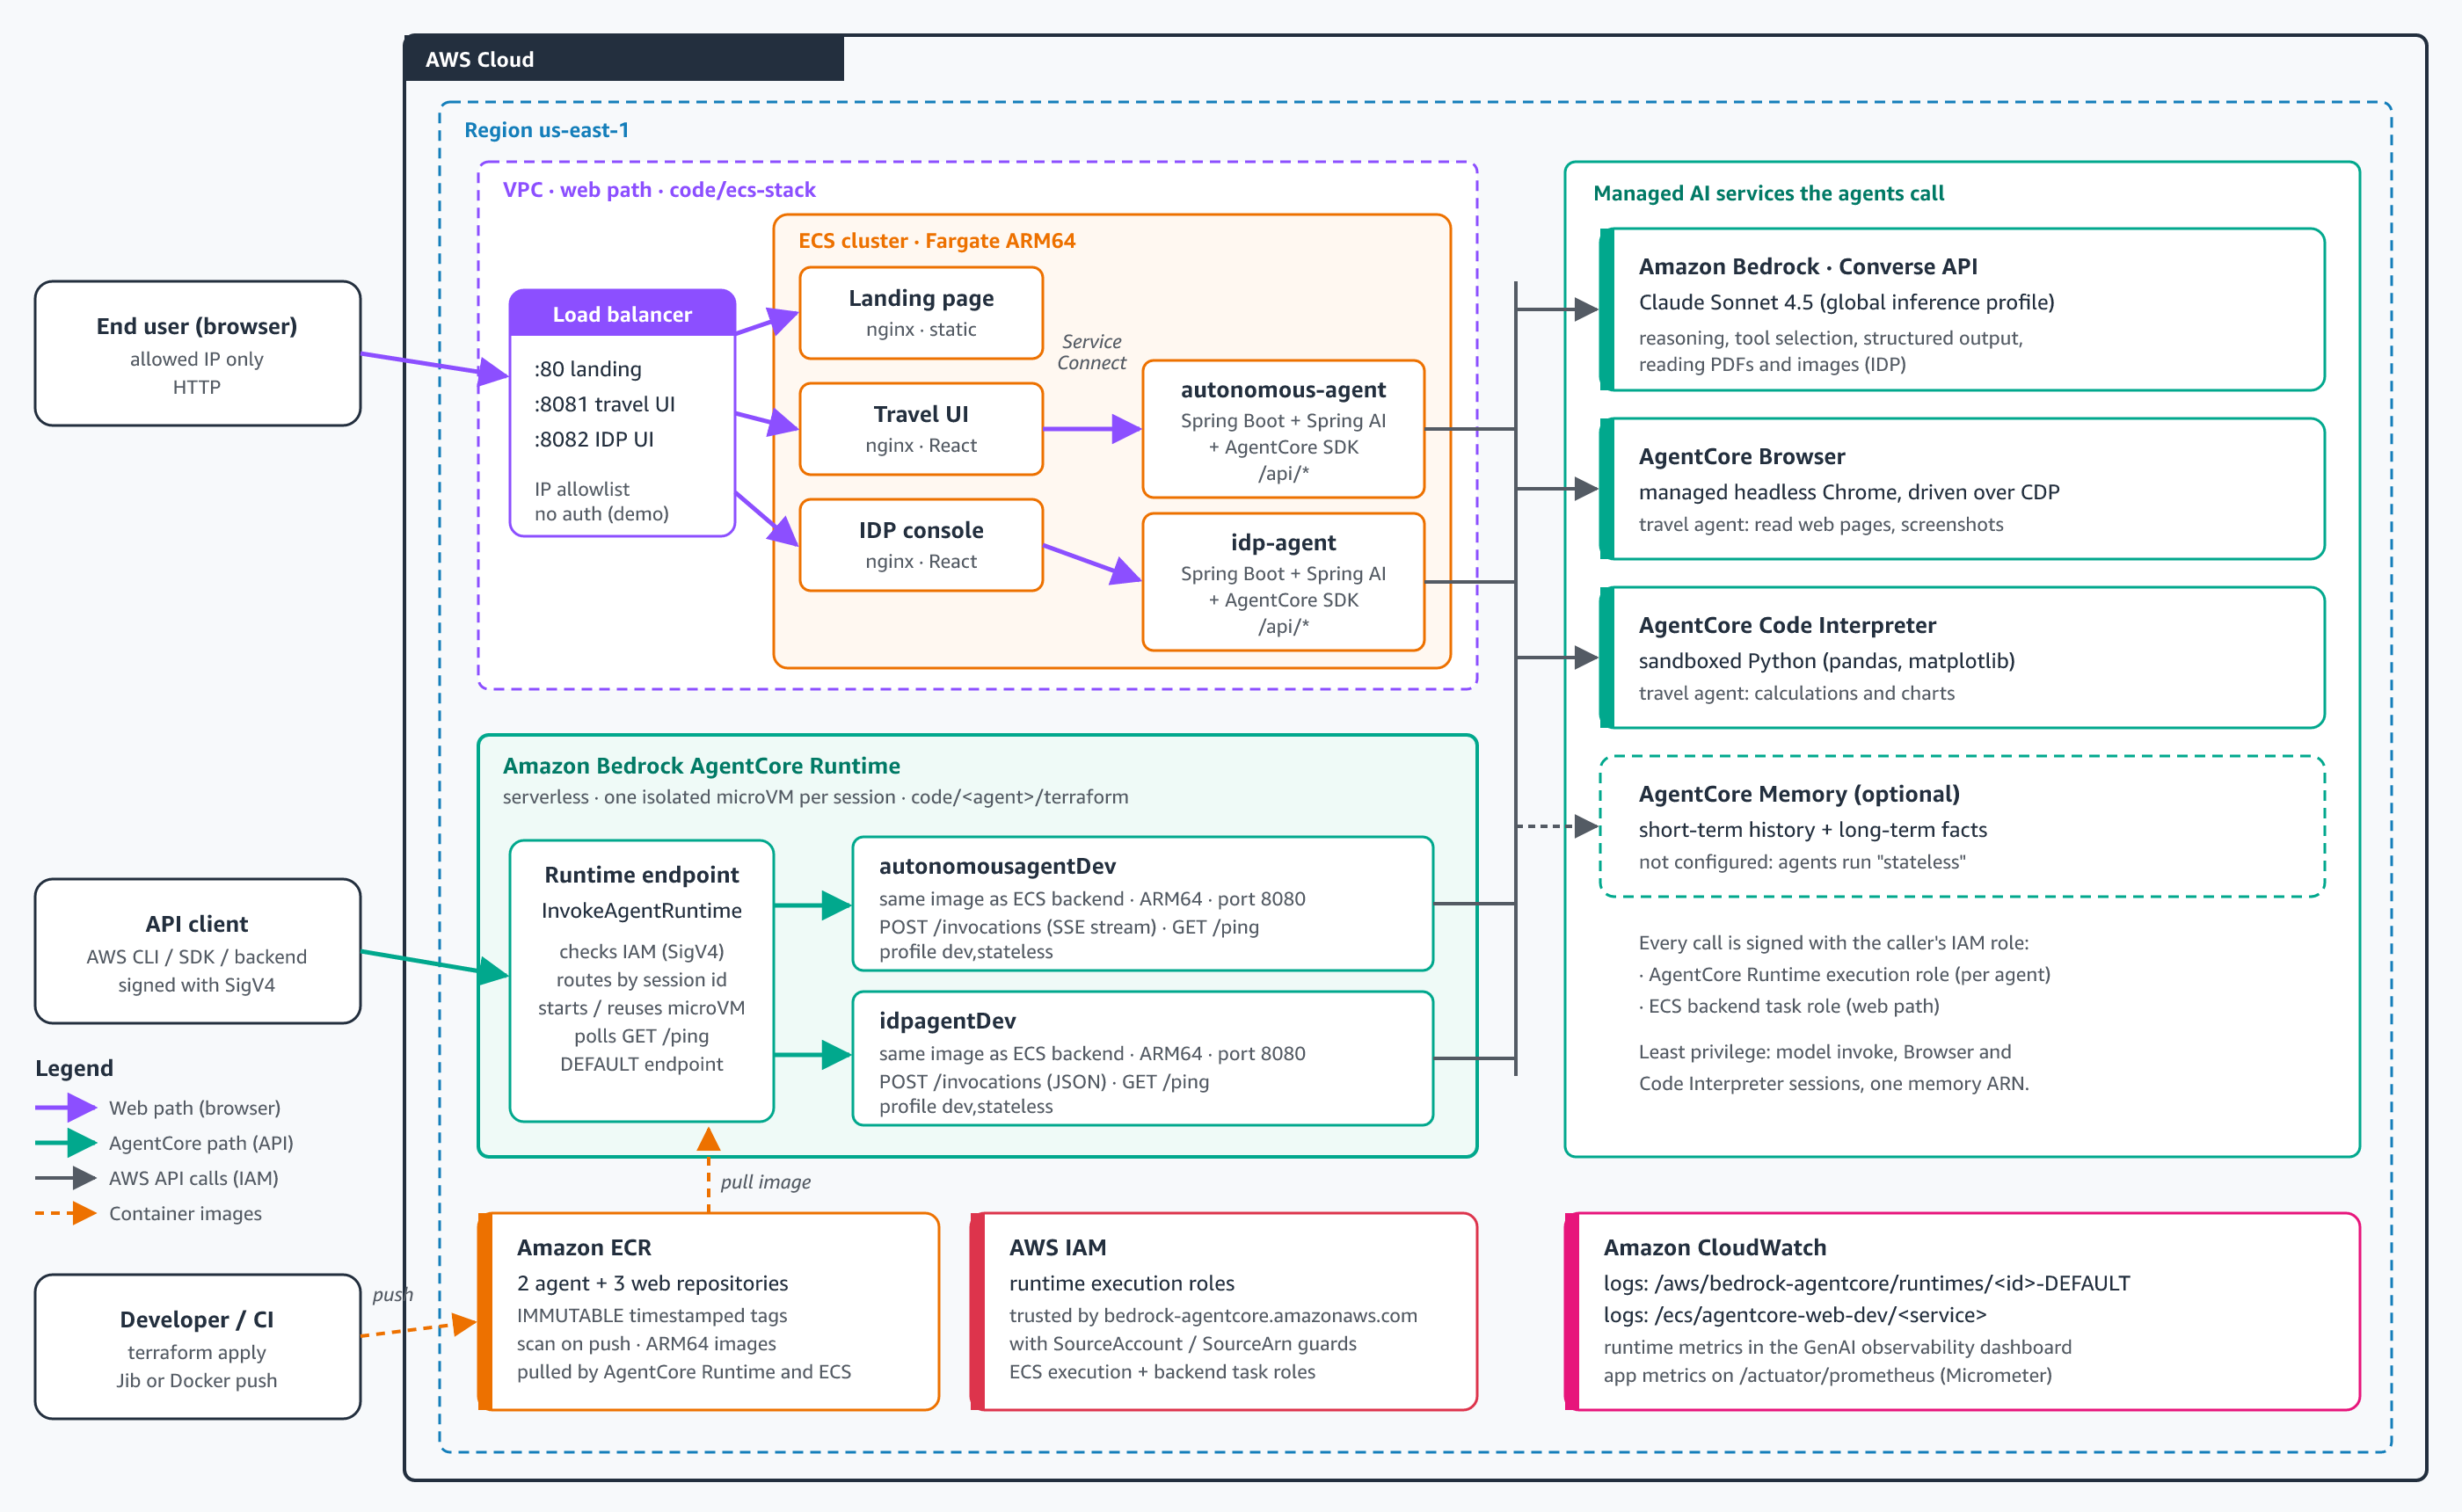
图 6:部署架构。模块化 Terraform 创建 Amazon ECR、最小权限的 IAM 执行角色以及 Bedrock AgentCore runtime,并提供可选的 Amazon EKS 和 IRSA 路径,复用相同的 Arm64 镜像。
三个阶段:构建和发布、Terraform、在 AWS 上运行。CI 流水线将应用打包为 linux/arm64 镜像,并以不可变标签推送到 Amazon ECR。三个 Terraform 模块分别创建 ECR 仓库、最小权限的 IAM 执行角色以及 AgentCore runtime。智能体以无服务器方式在 AgentCore runtime 上运行,调用 Amazon Bedrock 和 AgentCore memory。可选的 Amazon EKS 路径复用相同镜像,并通过 IRSA 提供范围受限的 Pod 级凭证。
按照以下步骤部署任一应用。
第 1 步:克隆仓库
打开终端并运行:
git clone https://github.com/aws-samples/sample-build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai.git第 2 步:导航到要部署的智能体所在目录
- Deploy autonomous agent:
cd build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai/code/autonomous-agent - Deploy IDP multi-agent system:
cd build-autonomous-ai-agents-with-amazon-bedrock-and-spring-ai/code/idp-agent
第 3 步:配置 Terraform 变量
在部署基础设施之前,请在 terraform 目录下的 terraform.tfvars 文件中配置 Terraform 变量。
基本配置
该方案对大多数设置使用默认值,但你可以在 terraform.tfvars 文件中自定义以下内容:
- AWS Region:部署资源所在的 AWS 区域(AWS Region)。
- Environment:用于资源命名的环境 ID(例如
dev或prod)。 bedrock_model:Amazon Bedrock 基础模型(例如:global.anthropic.claude-sonnet-4-5-20250929-v1:0)。有关各区域可用的模型,请参阅Amazon Bedrock 各 AWS 区域支持的模型。
第 4 步:运行部署脚本
对于 Linux/macOS:
./scripts/deploy.sh dev对于 Windows PowerShell:
.\scripts\deploy.ps1 dev部署脚本会执行以下操作:
- 创建 Amazon ECR 仓库。
- 构建 Java 应用。
- 创建并推送 Docker 容器镜像。
- 创建 IAM 执行角色。
- 部署 AgentCore runtime。
第 5 步:运行应用
部署完成后,你可以使用以下命令运行应用。
对于 Linux/macOS:
./scripts/run.sh dev对于 Windows PowerShell:
.\scripts\run.ps1 dev清理资源
AgentCore runtime 可扩展至零并按调用计费,因此空闲的智能体几乎没有成本。你的主要可变成本是 Amazon Bedrock 的 token 用量,外加 Amazon CloudWatch 和 Amazon ECR 存储的少量费用。有关当前费率,请参阅 Amazon Bedrock AgentCore pricing 和 Amazon Bedrock pricing。为避免产生后续费用,完成后请销毁基础设施:
对于 Linux/macOS:
./scripts/cleanup.sh dev对于 Windows PowerShell:
.\scripts\cleanup.ps1 dev使用 AWS CLI 删除不再需要的 AgentCore memory 资源和 Amazon ECR 镜像。
结论
在这篇文章中,你学习了如何使用 Spring AI 和 Amazon Bedrock 在 Java 中构建自主 AI 智能体。我们介绍了将模型转变为智能体的三大能力:规划、工具使用和记忆。我们还展示了 Amazon Bedrock AgentCore 服务如何将智能体推向生产环境。Spring AI AgentCore SDK 通过注解和熟悉的 ChatClient 将这些能力映射到符合 Spring 习惯的用法上。最后,我们概述了多智能体协作的架构模式,包括路由器模式、由规则引擎实现的评估器模式,以及作为可选扩展的并行扇出模式。
给 Java 团队的关键启示:构建生产级质量的智能体无需离开你现有的环境。你已经信赖的模式(依赖注入、配置属性、advisors、Actuator、Micrometer)可以直接带入智能体世界。AgentCore 则提供生产环境所要求的运行时、记忆、身份和治理能力。
接下来,可以考虑以下步骤:
- 通过 AgentCore Gateway 和 Model Context Protocol (MCP) 连接企业系统
- 添加 Amazon Bedrock Knowledge Bases(全托管的 RAG 能力)和网络搜索,让智能体基于你的数据进行推理。
- 实现基于 Amazon Cognito 的 JWT 身份验证,并支持按用户隔离的记忆。
- 自定义 Amazon Bedrock Guardrails 策略:添加特定领域的拒绝话题、收紧内容过滤阈值,并启用针对你的知识源调优的落地性检查。
- 使用 AgentCore Evaluations 对生产环境的追踪记录进行评分,并在审核后推广提示词或模型的更改。
每一项都是对你在本文中所构建基础的增量补充,而非重写。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com