CrossnoKaye 如何用 Amazon Bedrock AgentCore 落地物理 AI
How CrossnoKaye grounds physical AI with Amazon Bedrock AgentCore
CrossnoKaye 基于 Amazon Bedrock AgentCore 在 ATLAS 平台上构建物理 AI 系统 AURA,为重工业提供闭环控制。其平台已覆盖超 100 家工业设施、13,000 个受控资产,存储超 22 万亿机器数据点,每天新增超 500 亿条读数,运行超 1,000 个实时 APC 应用,据称可提升产量 11–17%、平均降低设施能耗成本 21%。
工业运营会带来典型企业软件中不会出现的 AI 挑战。在大多数工厂中,工厂数据和控制逻辑分散在不同厂商的独立系统中:可编程逻辑控制器(PLC)和分布式控制系统(DCS)运行设备逻辑,历史数据库按站点特定的命名方案记录时间序列标签,监控与数据采集(SCADA)系统驱动操作员屏幕,而独立的优化工具或报警记录器则放在一旁。把一个外部 AI 智能体硬接到这样的技术栈上,实际效果往往不佳。每个系统都使用自己的命名约定。真正决定设备行为方式的逻辑(控制序列、状态机和安全联锁)被锁在外部工具无法查看的专有控制器代码中。让一个外挂智能体跨多个运营技术(OT)系统访问,还意味着要在工厂网络中分发凭证。
CrossnoKaye 采用了一种不同的方法,利用 Amazon Bedrock AgentCore 将物理 AI 带入重工业。其软件定义的自动化平台 ATLAS 将实时工厂数据和 AI 推理与运行食品饮料工厂、工业制冷设施、砂石采石场和制造场所的设备的闭环控制连接起来。在超过 100 家工业设施和 13,000 个受控资产中,CrossnoKaye 存储了超过 22 万亿个机器数据点,每天摄取超过 500 亿条新读数,并运行超过 1,000 个实时先进过程控制(APC)应用;据 CrossnoKaye 报告,这些应用将生产吞吐量提高了 11–17%,同时使工厂总能源成本平均降低 21%。由于 ATLAS 已经在 AWS 上的单一平台中管理着设施模型、基础控制软件、历史数据库和优化应用,CrossnoKaye 的智能体智能系统 AURA 可以在单一安全边界内原生访问工厂的完整运营状态。
然而,拥有工厂上下文只是问题的一半。大语言模型(LLM)擅长解读工程上下文和规划调查,但无法可靠地在提示中对数百万条传感器读数进行统计或物理平衡计算。为了让每个数值答案都有真实的数学计算支撑,AURA 使用 Amazon Bedrock AgentCore 的代码解释器功能,在隔离的 AWS 托管 microVM 沙箱中于运行时编写和运行 Python 工作负载,同时配合 Amazon Bedrock Guardrails 和本地边缘安全控制。本文介绍 CrossnoKaye 如何在 AWS 上构建 ATLAS 和 AURA 的架构、AURA 如何在交互式聊天(Chat)、可重复任务(Task)和自动化例程(Routine)中使用 Amazon Bedrock AgentCore,以及团队在生产环境中运行物理 AI 的经验教训。
解决方案概览
ATLAS 在现有的 PLC 和 DCS 基础设施上控制工业过程,涵盖窑炉、破碎机、烘干房、烤箱和螺旋速冻机,以及冷水机组、涡轮机、阀门和压缩机,无需客户拆除和更换工厂硬件。图 1 展示了本地部署的 ATLAS 边缘集群、持续的云端优化和 AURA 如何在 AWS 上协同工作。
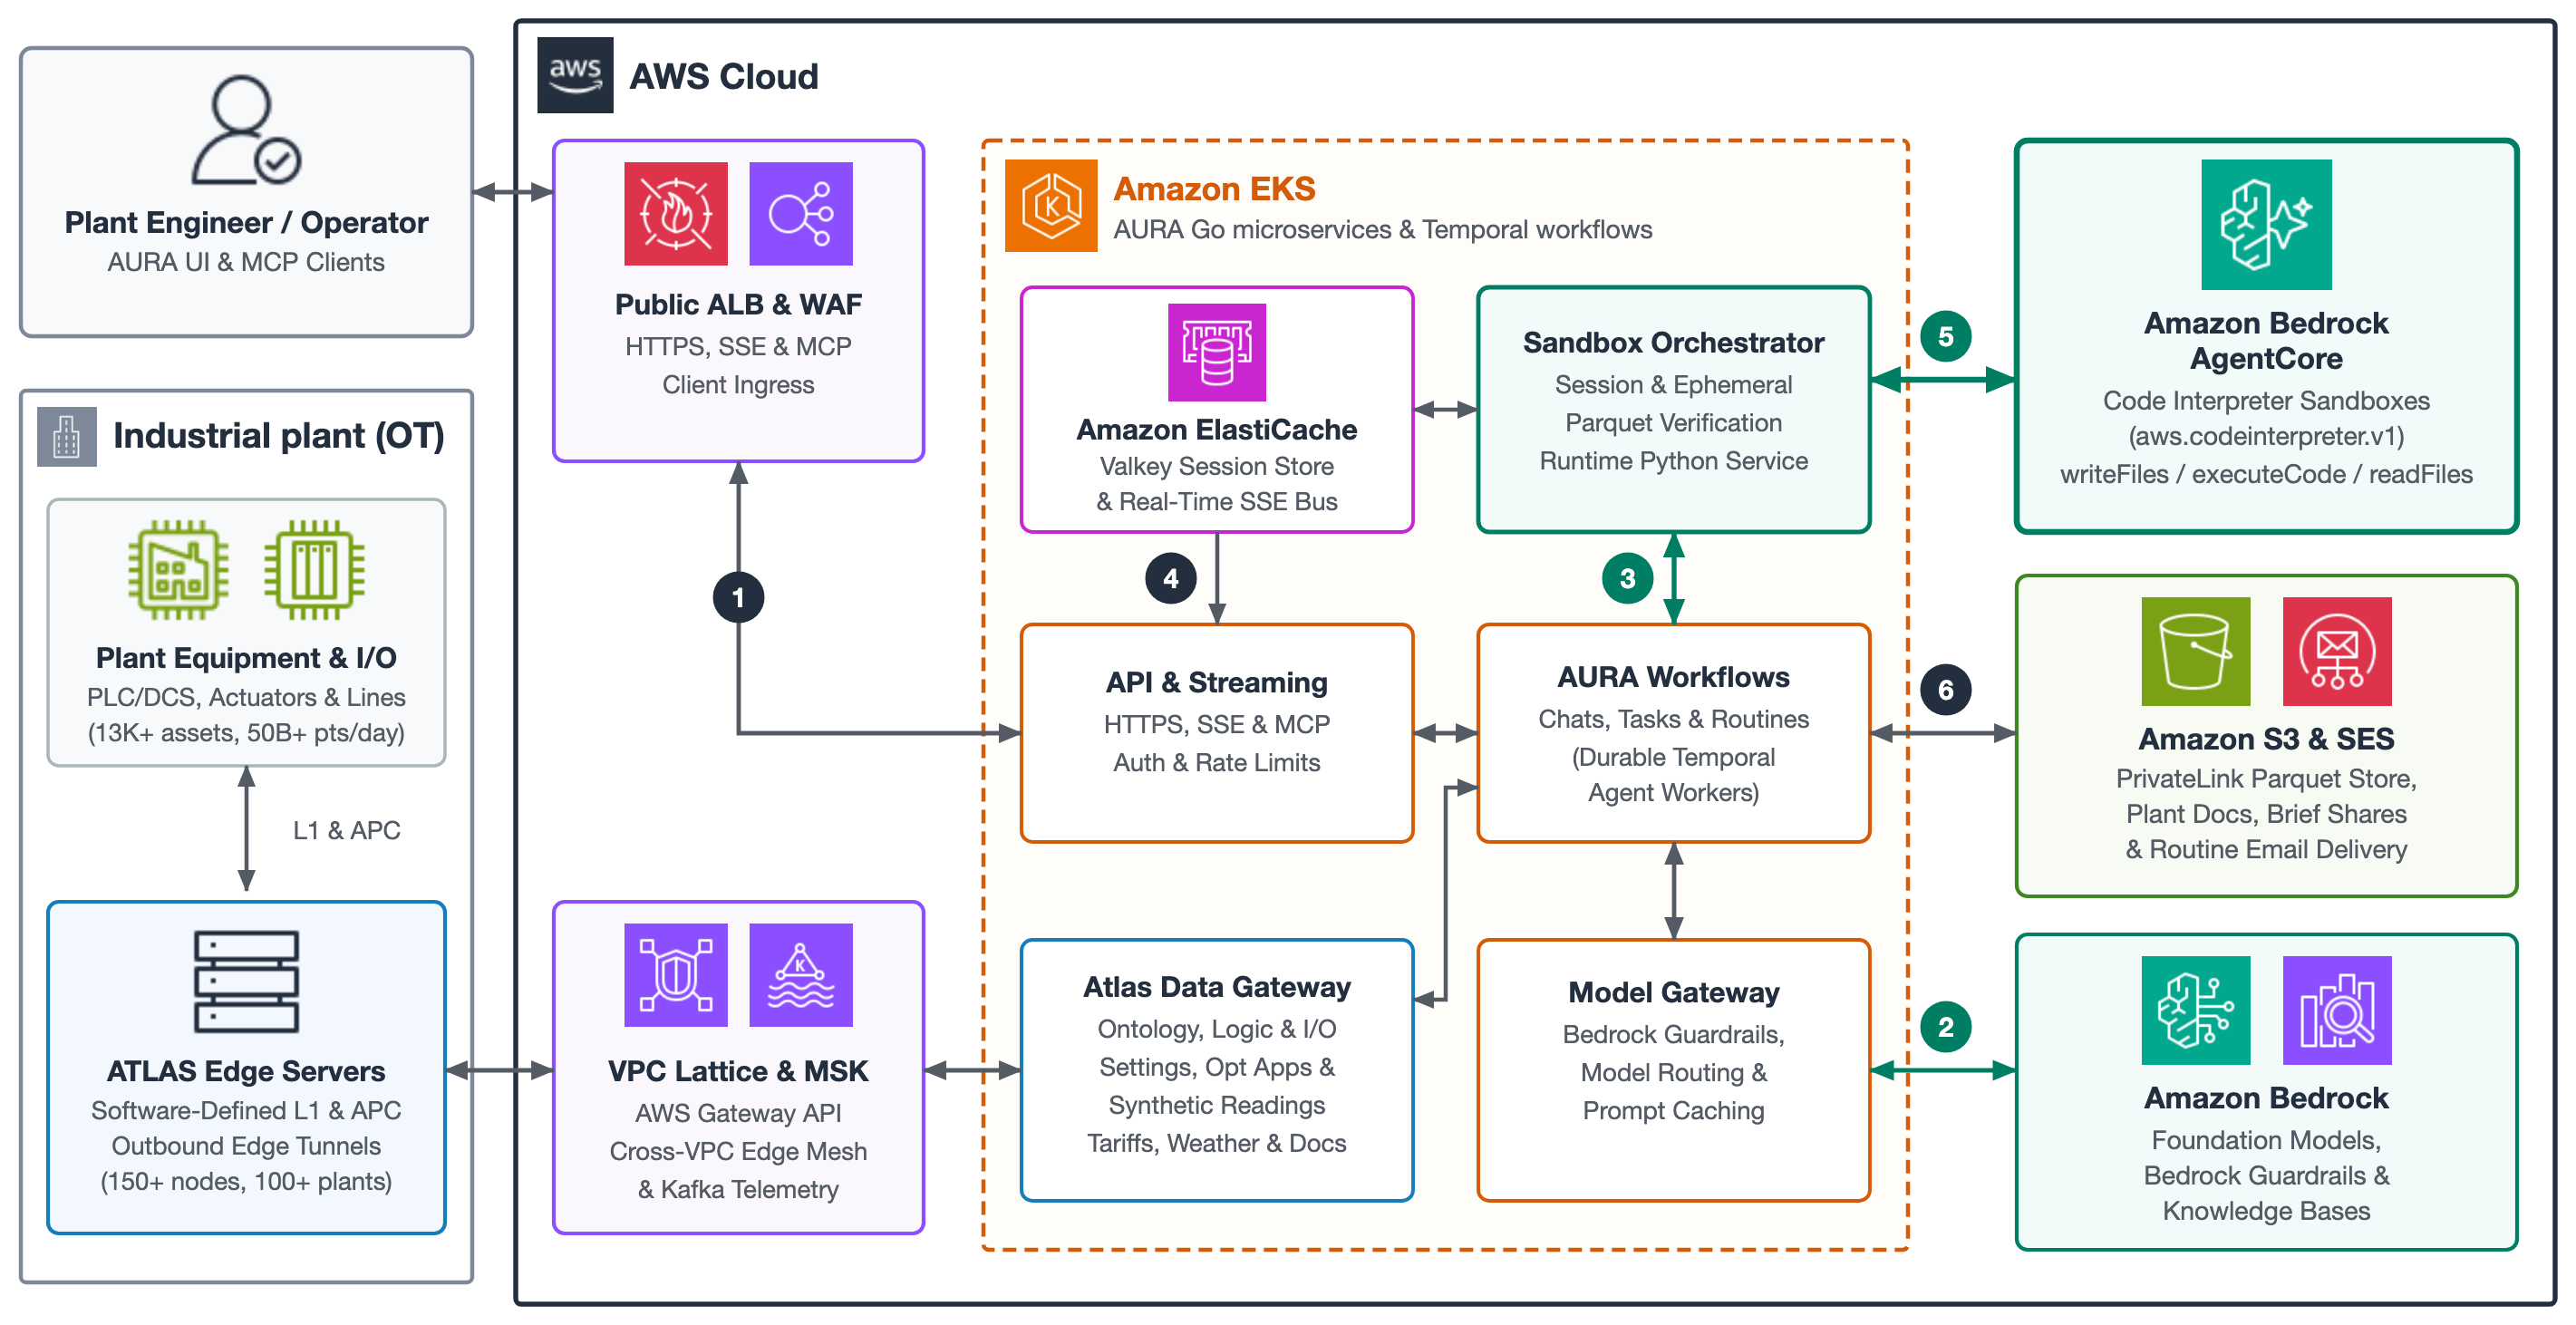
图 1:CrossnoKaye 使用 Amazon Bedrock AgentCore 的 AURA 和 ATLAS 物理 AI 架构
ATLAS 和 AURA 围绕三个核心层构建:
首先,从边缘开始,整个工厂在软件中被定义。在每个设施中,一台配备冗余计算机、电源和网络交换机的本地部署 ATLAS 控制面板(这样在更换故障硬件组件时,本地控制仍可不间断地继续运行)运行一个本地 Kubernetes 集群,采用契约优先的微服务,将 AWS 上的 ATLAS 云平台扩展到工厂车间。在云端,ATLAS 对设施的基础控制叙述(定义设备状态机、序列、运行边界、联锁和报警规则)进行编写、验证和版本管理,这些叙述被下载到边缘设备上,并针对现有设备和控制器在本地运行。据 CrossnoKaye 报告,其每年进行超过 9,000 次控制软件部署,累计运行超过 100 万小时,零安全事故。每个边缘设备还充当仅出站的信息技术/运营技术(IT/OT)网关,在工厂内部不开任何入站防火墙端口,通过 Amazon VPC Lattice 和 Amazon Managed Streaming for Apache Kafka (Amazon MSK) 将高频遥测数据流式传输到 AWS。如果云连接中断,工厂可以基于本地边缘集群上的基础控制叙述继续安全运行。
其次,派生的工程信号和闭环优化应用运行在基础控制之上,使用同一个共享的工厂模型。在云端,CrossnoKaye 的调度系统从 Amazon Simple Storage Service (Amazon S3) 中的版本化 Python 包运行两条连续的流水线,按可配置的每实例节奏运行,并在工厂设置变化时由事件驱动触发。合成读数算法计算派生的工程指标,例如热流分布、资产健康指数、能源强度和质量平衡偏差,并将它们与物理 I/O 一起写回历史数据库。闭环优化应用运行在基础控制层之上,将这些派生的合成读数与物理模型、模型预测控制(MPC)、强化学习、公用事业电价和天气预报相结合,以计算最优设定值调度。Amazon Simple Queue Service (Amazon SQS) FIFO 队列按设施对每一条调度和状态更新进行排序,然后将设定值分派到边缘集群上的本地基础控制叙述,据 CrossnoKaye 报告,该系统每天执行 650,000 次闭环控制操作。
第三,AURA 作为微服务和持久化的 Temporal 工作流,在 Amazon Elastic Kubernetes Service (Amazon EKS) 的平台边界内运行。在调用者的企业权限下,AURA 智能体查询内部 Atlas Data 网关,以一个一致的模型读取单个设施或整个机群的运营状态:上下游设备拓扑、已部署的基础控制叙述和联锁、物理 I/O 和合成读数、设置变更与报警历史、处于活动状态的优化调度,以及在 Amazon Bedrock Knowledge Bases 中建立索引的工厂文档。
将设备布局、基础控制逻辑和传感器数据放在同一个系统中,在诊断工厂问题时会带来实实在在的差异。在某家运营一级、二级、三级岩石破碎机的骨料采石场,一个班次内工厂后半段跳闸了两次。操作员从控制室看到二级破碎机故障,清除报警并重新启动生产线,结果几个小时后再次跳闸。仅从历史数据库的时间戳来看,二级破碎机在三级破碎机之后几秒才故障,这看起来像是破碎机的问题。由于 AURA 还能读取输送机布局和已部署的基础控制联锁,它的排查遵循了实际的控制逻辑:三级破碎机下方的循环皮带打滑,触发了三级破碎机的过载联锁。该联锁的上游安全联锁立即停机了二级破碎机,以防止石料掩埋已停止的下游破碎机。工厂经理没有去追查虚假的破碎机故障,而是派操作员去检查循环皮带,几分钟内就确认并修复了打滑问题。
图 1 中的编号流程展示了 AURA 的一次排查在 AWS 上的运行方式:
- 客户端与边缘接入:工程师和模型上下文协议(MCP)客户端通过 AWS WAF 和公有应用程序负载均衡器连接,API 网关在其中验证企业单点登录(SSO)或 MCP 凭证。边缘遥测和控制计划通过 Amazon VPC Lattice(使用 AWS Identity and Access Management(IAM)Signature Version 4(SigV4)进行身份验证)和 Amazon MSK 传输。
- 上下文检索与受保护的推理:AURA 工作流通过 Atlas Data 网关读取工厂状态,并通过模型网关将提示词和限定组织范围的检索增强生成(RAG)查询路由到基础模型、Amazon Bedrock Guardrails 和 Amazon Bedrock Knowledge Bases。
- 运行时计算分发:对于统计、热力学或多数据集数学计算,工作流通过 gRPC 将输入数据集流式传输到 AURA 内部的 Sandbox Orchestrator 服务。
- 会话协调与实时流传输:在交互式会话中,Sandbox Orchestrator 跟踪活跃的沙箱会话 ID,并通过面向 Valkey 的 Amazon ElastiCache 流式传输实时进度。
- 隔离的 Python 执行:Sandbox Orchestrator 使用 AWS SDK 调用 Amazon Bedrock AgentCore 运行时端点(Amazon Bedrock AgentCore 的一项功能),暂存数据集并在隔离的代码解释器 microVM 中运行由模型生成的 Python 代码。
- 工件存储与 Brief 交付:经验证的 Apache Parquet 输出、图表和带引用的 Brief 通过 AWS PrivateLink 保存到 Amazon S3,并由 Amazon Simple Email Service(Amazon SES) 将自动生成的 Brief 发送给工厂团队。
演练
AURA 将 Amazon Bedrock 上的基础模型(模型在各 AWS 区域的可用性请参阅《Amazon Bedrock 用户指南》中的按 AWS 区域列出的支持模型)与 Amazon Bedrock AgentCore Code Interpreter(Amazon Bedrock AgentCore 的一项功能)中的隔离 Python 沙箱相结合,支持三种运营模式:
- 聊天:跨单个设备、一条工艺线或多站点组合(单次最多 200 个设施)的交互式多轮工程对话。
- 任务(Tasks):可重复、可参数化的调查,绑定到不可变的版本快照,生成包含带引用的证据表和图表的结构化技术简报。
- 例程(Routines):由计划任务、传感器阈值、变化率窗口、警报或设备模式转换触发的自动化后台监视器。
以下章节将探讨这些工作流背后的四项架构决策。
与干净的单次运行管道相比的暖会话对话沙箱
交互式调试和自动化工厂报告有不同的状态要求:
- 在交互式 Chat 中,工程师逐步探索假设:加载 94 座设施 24 小时内的关键警报,过滤掉某个现场的频繁抖动的储罐液位传感器,并将压缩机跳闸与环境湿球温度进行关联。每轮都启动冷沙箱会清除内存表并增加延迟。对于 Chat,沙箱编排器(Sandbox Orchestrator)将一个暖 Amazon Bedrock AgentCore 会话绑定到 Amazon ElastiCache for Valkey 中的对话,并设置 15 分钟的滑动生存时间(TTL);如果工程师在空闲超时后返回,则透明地配置一个替换会话。
- 在定时执行的 Task 或凌晨 2:00 的 Routine 中,可重现性是第一位的。每次运行都必须在干净的环境中开始,没有先前运行遗留的状态。对于 Task 和 Routine,沙箱编排器为每次运行配置一个全新的、一次性的 AgentCore microVM,并在计算完成后立即以
StopCodeInterpreterSession停止会话,既防止跨运行污染,也避免空闲沙箱产生费用。
这种暖会话设计使在整个车队范围内的单次对话中开展排查成为可能。当运营总监要求 AURA 审查过去 24 小时内 94 座设施的所有关键警报并识别主要机械风险时,智能体从 Atlas Data 网关将车队警报摘要加载到其 AgentCore 沙箱中,并按设施、规则和报警间隔时间对报警进行分组。Python 分析不是按原始报警数量对现场进行排名,而是区分出 103 次关键报警来自两条重复的污水罐液位规则的工厂,与 58 次报警在彼此一秒之内横跨氨气检测、蒸发器故障和热气阀的工厂,从而让安全和维护团队直接关注出现级联设备故障的设施。
用可验证的计算代替未经核实的模型数学运算
当工程师要求 AURA 分析工艺趋势或审计班次绩效时,响应中的数字必须准确。在 AURA 开发早期,团队发现让模型编写自由格式的 Python 脚本并将 JSON 或文本摘要打印到标准输出的做法过于脆弱:模型偶尔会拼错列名、丢失部分时间窗口,或以破坏下游图表渲染的方式格式化输出。
为了使运行时计算可验证,AURA 在每次 Amazon Bedrock AgentCore 运行周围强制执行严格的数据契约:
- 前置契约验证和多源数据暂存:在分配沙箱会话之前,沙箱编排器验证输入契约,并将多达 50 个数据集暂存到 microVM 工作区,其中结合了物理 I/O、派生的合成读数、设置日志、报警历史和公用事业费率表。
- 沙箱内 DataFrame 模式验证:该服务不再解析标准输出的自由格式文本,而是在模型的 Python 脚本后附加一个确定性的验证工具。在沙箱内,该工具验证每个声明的输出表都作为
pandas.DataFrame存在于内存中,且包含所有必需的列和类型,并将验证过的表直接序列化为二进制 Apache Parquet 文件。 - 自动自我纠错:如果脚本抛出 Python 异常或遗漏了必需的列,任何未经验证的数字都不会到达用户。Temporal 工作流将回溯信息和模式不匹配捕获为结构化的重试提示,让智能体修复其 Python 逻辑,并在发布任何结论之前在干净的沙箱中重新运行计算。
通过 Amazon SES 实现自动化夜班例程和带引用的简报
工厂工程师无法全天候监视 100 个工厂的仪表盘,而许多设备问题在夜班时只是缓慢的漂移。AURA 例程在后台运行,监视特定的工艺条件(例如制冷级的吸气压力漂移、批次干燥曲线偏离规格,或未经计划的 вруч上设置点覆盖),并在条件触发时自动启动调查。
一个工业冷水机组工厂的夜班捕获案例展示了这一流程的端到端运作方式:
- 自动检测与沙箱根因分析(凌晨 02:00–02:03):凌晨 2 点,一个例程检测到低级吸气压力漂移,并以只读模式启动其固定的 Task。在 Amazon Bedrock AgentCore 沙箱内,智能体将冷凝器逼近温度与跨物理和合成读数的低级吸气压力进行关联,排除了传感器漂移和制冷剂充注不足的可能性,并锁定为冷凝器侧结垢。
- 确定性引用验证(凌晨 02:04):在发布简报之前,AURA 会解析每个内联引用,并验证每个论断都链接到 Amazon S3 中保存的遥测窗口、设置变更记录或沙箱输出工件。不会自动进行任何控制变更。
- 通过 Amazon SES 交付简报并一键移交至 Chat:在触发后的四分钟内,AURA 通过 Amazon SES 向工厂工程团队发送一封格式化的 HTML 简报邮件,其中包含诊断结果、引用的信号轨迹以及一个“在 AURA 中调查”按钮。当主任工程师在早班班前会上选择该按钮时,AURA 会验证该工程师的实时设施权限,并打开一个预加载了简报证据的交互式 Chat,使团队可以立即提出后续问题或下达工单。
纵深防御的工业安全
在工业工厂中,运营安全不能依赖 LLM 遵循提示词中的指令。由于 ATLAS 和 AURA 共享同一个平台——从云端一直延伸到工厂车间的边缘 Kubernetes 集群,CrossnoKaye 在四个独立层上对 AI 和优化工作负载可以执行的操作强制实施严格的边界:
- Amazon Bedrock Guardrails 与可验证的来源(Observe):通过 AURA 的 Model Gateway 路由的每个提示词和补全都由 Amazon Bedrock Guardrails 评估,以强制执行内容、主题和安全策略。Knowledge Base 检索按组织进行隔离,且每个简报都需要经过验证的内联引用,注明分析了哪些时间窗口以及传感器数据不可用的任何时段。
- 气隙隔离的只读沙箱与人工审批的提案(Propose):Amazon Bedrock AgentCore Code Interpreter microVM 在 AWS 托管的隔离环境中运行,没有任何通往工厂设备的网络路由、凭据或 API 通路。Automated Routines 严格以只读模式运行。当工程师通过交互式会话提出设置变更提案时,平台要求以运营方的企业身份进行明确的人工审批,并在事后通过工厂遥测数据验证物理结果。
- 边缘侧不可绕过的确定性一级基础控制(Bounded and Base Control):云优化应用不直接驱动现场硬件。它们在平台的基础控制层之上运行,通过在工程部门批准的范围内下发设定值计划来工作。在工厂现场,边缘 Kubernetes 集群实时本地运行下载的基础控制程序,执行确定性的状态机防护、变化率限制、运行边界和设备联锁,这些防护无法被云服务、优化应用或 AI 智能体绕过。
- 独立的物理硬件保护:在 ATLAS 软件定义控制器之下,工厂的物理机械和现场接线构成独立的硬接线保护层,包括安全继电器、本地可编程跳闸装置,以及机械式泄压和过温保护装置。
成果与经验教训
在食品加工、工业制冷、砂石与采矿以及制造现场,CrossnoKaye 报告称,软件定义的边缘控制、持续的云端优化与 AURA 相结合,将批次干燥时间标准差降低了 34%(目标良率规格内完成的产品增加 6%),并在采石场运营中识别出每年超过 50,000 吨的可挽回产量缺口。凭借超过 5,000 个 AI 智能体监控客户设施中 10,000 多个工厂资产(包括 ATLAS 机群中超过 13,000 个受控设备和装置),过去需要数小时导出历史数据 CSV、交叉比对 PLC 梯形图逻辑并制作电子表格的调查工作,如今在四分钟内即可完成,并通过 Amazon SES 在早班会前送达带有引用来源的技术简报。
在工业设施中构建和运营 AURA 的过程中,有三条经验尤为突出:
- 在引入 AI 之前统一工厂模型与控制逻辑:只有当智能体能够在一个一致的模型中读取工艺拓扑、已部署的基础控制程序与联锁、设置变更历史以及优化器状态时,它才能诊断出真实的物理根因——例如区分下游打滑的循环皮带与二级破碎机故障——而不是把六个互不连通的工厂系统拼凑在一起。
- 在操作员的日常工作流程中交付价值,而不是提供一个需要专门使用的独立工具:工厂团队忙于运行设备。如果 AI 助手是一个工程师必须从空白提示词开始的独立入口,日常采用就会停滞。将 AURA 嵌入日常轮班节奏(后台 Routines 在夜间捕获异常,在 Amazon Bedrock AgentCore 中运行 Python 分析,并将带有引用来源的简报送达工程师收件箱,且支持一键切入预加载的 Chat 会话)意味着操作员在正常工作中就能看到价值,无需专门去使用一个独立产品。
- 用代码而非提示词来强制执行数据、覆盖范围和安全契约:在工厂里,缺失一小时的传感器数据与一小时没有事件并不等同,而一个未经验证的计算可能把维护人员派去错误的机器。在工具契约中明确数据覆盖缺口、在提取二进制 Apache Parquet 输出之前于 AgentCore 沙箱内验证
pandas.DataFrame模式,并在边缘 Kubernetes 集群上强制执行确定性的基础控制边界,可以在概率性模型错误触及操作员或设备之前将其拦截。
结论
在重工业中实现可靠的物理 AI,需要将模型建立在工厂实际的设备拓扑和控制逻辑之上,并为每个定量结论提供可验证的 Python 计算支撑。结合 Amazon Bedrock Guardrails 和 Amazon Bedrock AgentCore 中隔离的 Python 沙箱,ATLAS 和 AURA 使智能体能够对实时设施工件模型、基础控制规程、设置历史、物理 I/O、优化状态和合成读数进行推理,通过 Amazon SES 交付可核查的工程答案和附引用的技术简报,同时将确定性安全控制牢牢保留在工厂现场。
要进一步了解如何使用隔离代码执行构建智能体,请参阅 Amazon Bedrock AgentCore 开发人员指南,或访问 CrossnoKaye,了解物理 AI 如何变革重工业。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com