AWS 详解 Amazon Bedrock 上如何以每任务成本优化并证明 Agent ROI
Optimizing cost per task and proving agent ROI on Amazon Bedrock
AWS Machine Learning Blog 发布 Amazon Bedrock Agent 成本与 ROI 度量框架教程,指出每 token 定价不反映真实支出,需以每任务成本衡量。
本系列第 1 部分构建了控制 Amazon Bedrock 支出的运营模型:通过 AWS Identity and Access Management (IAM) 委托人标签和 Cost and Usage Report 2.0 进行成本归因,通过模型调用日志实现可观测性,在三个层级上执行管控,以及审查节奏。这一层回答了是谁花的钱,并且你可以阻止他们。但它无法告诉你这些支出是否花得值。
本文回答第 1 部分刻意留出的两个问题。第一个:为什么这个工作流这么贵?答案需要以每任务成本而非每 token 成本来思考。第二个:这个智能体比之前的人类做得更好吗?答案需要基线、对照实验以及与决策挂钩的记分卡。
在本文中,你将学习一个计算真实模型成本的框架(包括定价页面未展示的四个隐藏成本驱动因素),通过缓存、路由和输出约束降低每任务成本的技巧,以及一套衡量智能体 ROI 的规范——包括人类基线、留出实验和五维记分卡。本文面向两类读者:拥有优化杠杆的应用和平台工程师,以及需要向领导层论证智能体支出的产品负责人和 FinOps 合作伙伴。
每任务成本,而非每 token 成本
每 token 价格便于快速比较,但它并不反映你实际支付的费用。公布的费率反映的是单个 token 的成本。你的账单反映的是完成一项任务的成本。任务是应用程序要求模型完成的一个完整工作单元:处理一封支持邮件、从一张发票中提取字段,或回答一个用户问题。任务从请求开始,直到产出可用结果为止,无论需要多少次模型调用。
价格更低的模型运行起来未必更便宜。更便宜的模型可能把你的文本切分成更多 token、用填充词拉长响应、误读你的工具 schema 而陷入纠错循环,或在回答前消耗数千个推理 token。这些成本都不会出现在 Bedrock 定价页面上。
四个隐藏成本驱动因素
四个模型特性决定了公布的费率在你的工作负载上实际要花多少钱。
分词器效率
token 不是单词,而且在不同模型之间并不相等。每个模型家族使用不同的分词器和词表。同样的文本、代码或 JSON 负载会被切分成不同的 token 数量。如果模型 A 的标价低 15%,但它的分词器对你的数据需要多 40% 的 token(在结构化 schema 和数字数组中很常见),那么模型 B 更便宜。非英语文本的差距更大:许多分词器会把非拉丁文字切分成等效英文的两到三倍 token。
输出对齐与冗长度
输出 token 的成本通常比输入 token 高 3–5 倍(比率因模型家族而异。请参阅 Bedrock 定价页面)。一个忽略“仅返回原始 JSON”这类格式约束的模型,会让你为填充词支付输出溢价。一个严格遵守格式指令的模型,通过生成更少这类更昂贵的输出 token 来节省成本。
智能体循环效率
智能体工作流彻底改变了成本的计算方式。工具使用(函数调用)让模型可以调用外部函数,需要多轮循环:分析提示词、决定调用工具、等待观察结果、生成答案。每一轮都会把完整的对话历史和工具结果作为输入 token 重新发送。一个需要四轮才完成(每轮都重新发送更大的上下文负载)的模型,其成本远高于单轮完成的模型。
推理开销
许多模型支持扩展思考,在输出可见答案之前先进行思维链推理。推理 token 按输出 token 计费,因此一个在 200 token 的答案之前思考了 2,000 token 的模型,会向你收取 2,200 token 的费用。有些模型会隐藏推理内容,但仍然照常计费。应先关闭推理功能,只有当基准测试显示出足以证明成本合理的质量差距时才启用它。
单任务成本:一个实际案例
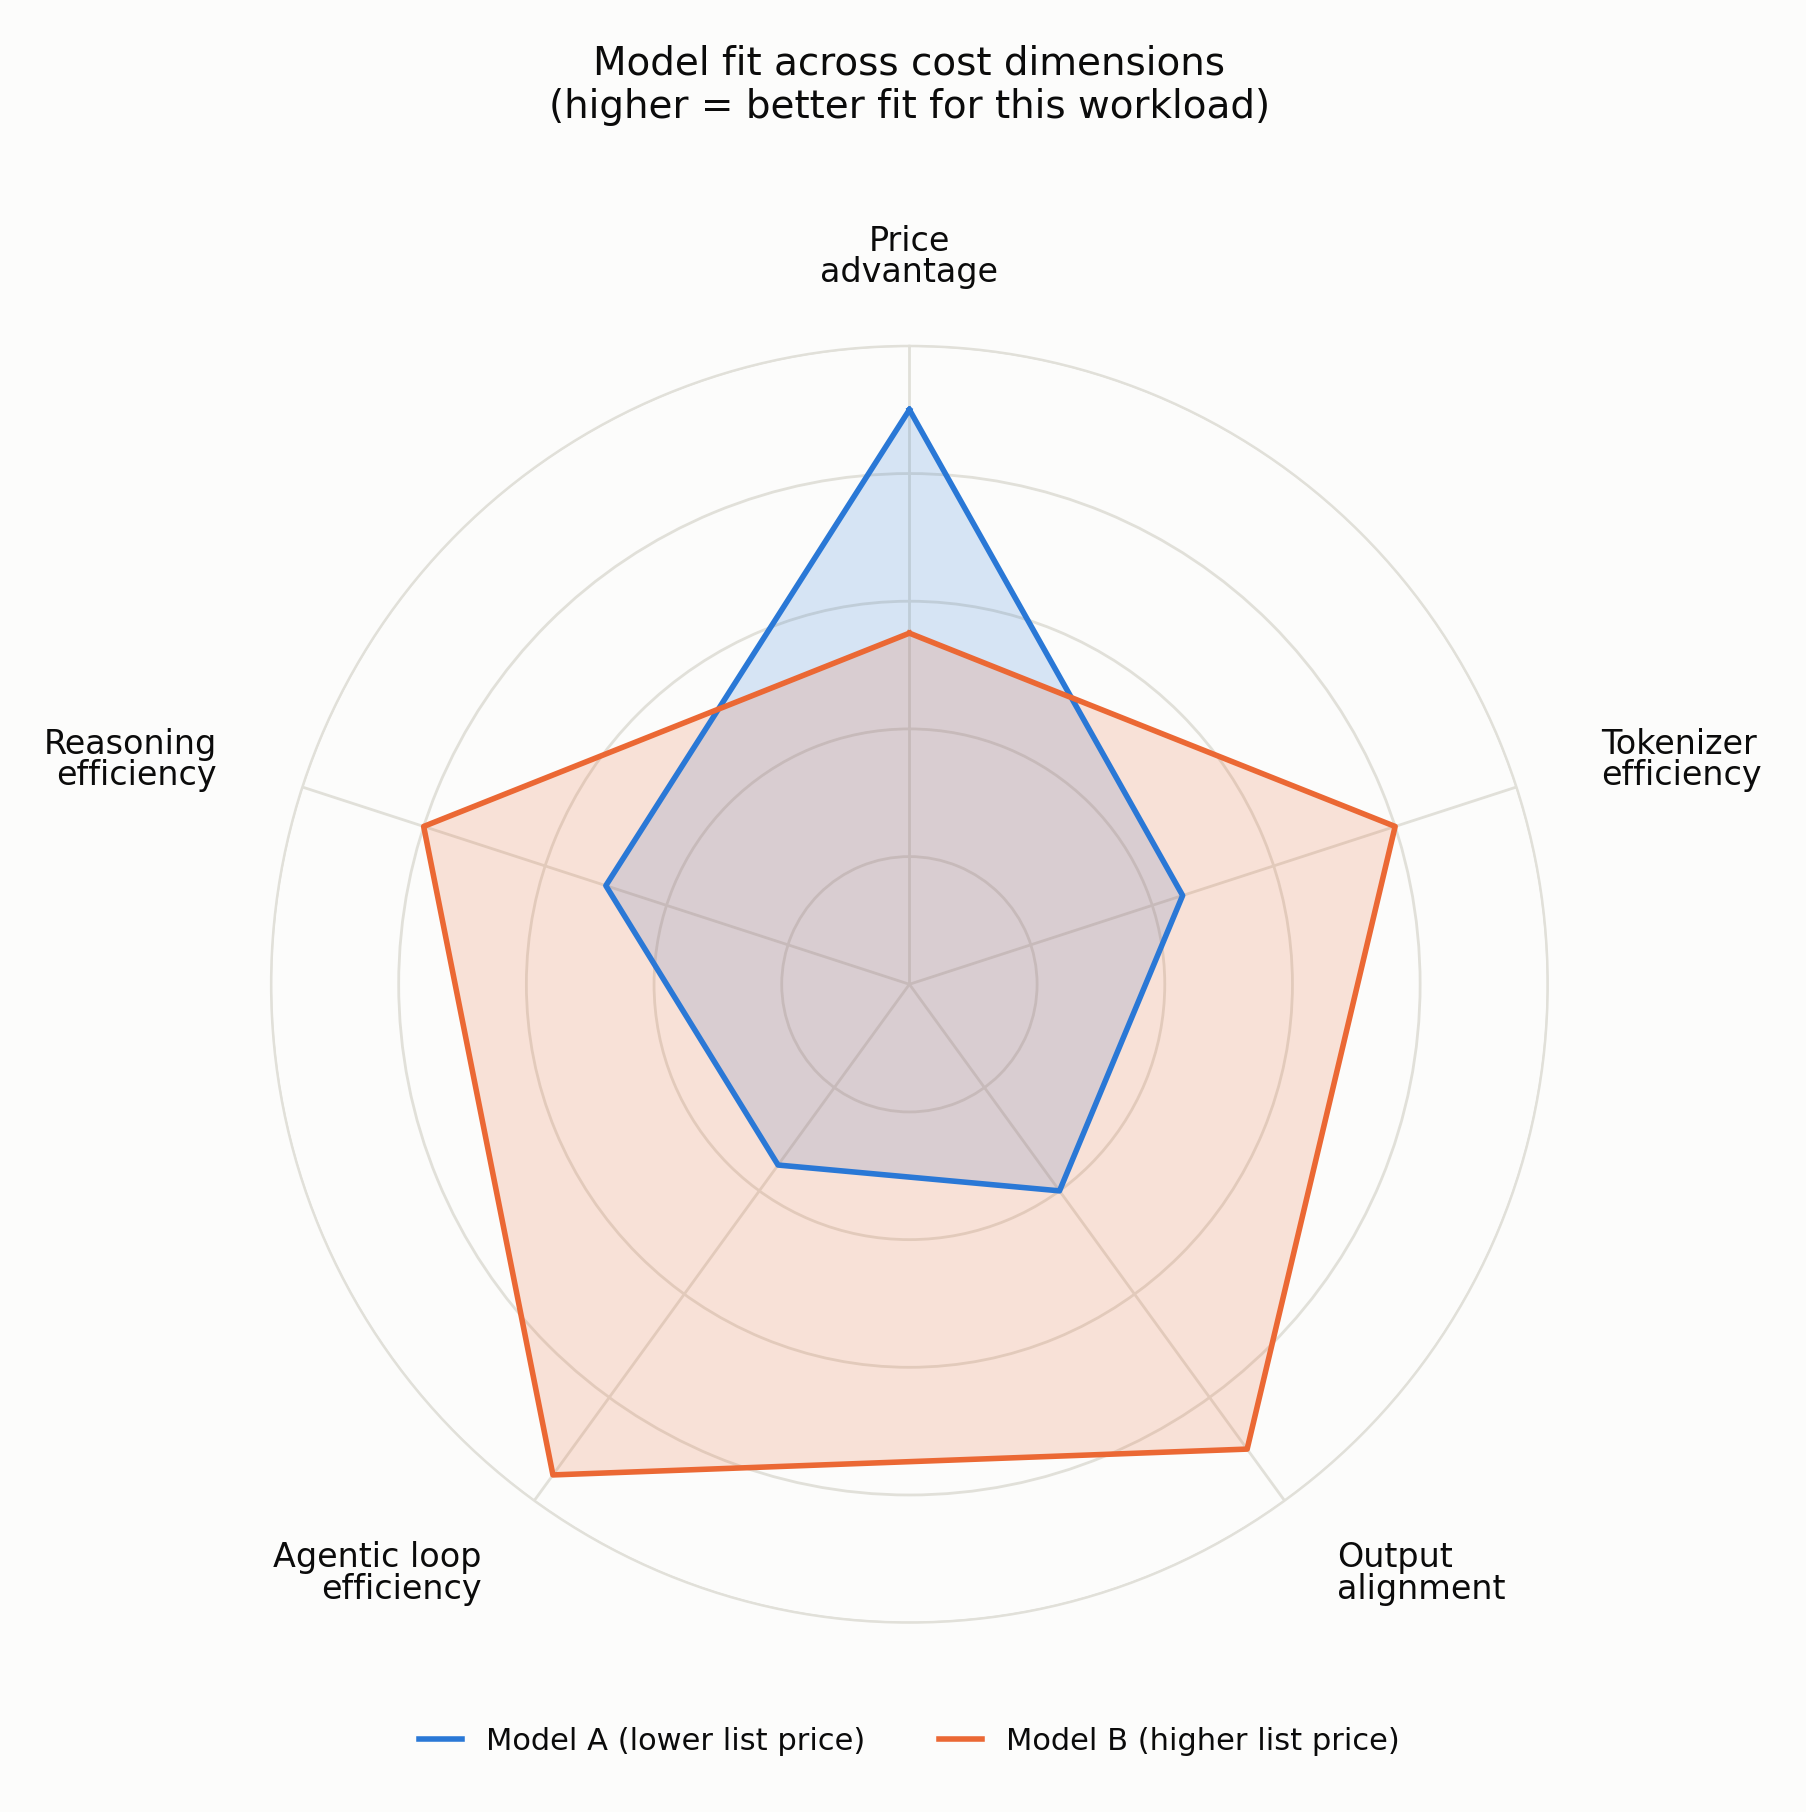
图 1:从五个成本维度比较两个模型。标价只是决定实际成本的五个因素之一
考虑这样一个智能体工作流:读取一封 750 词的客户邮件,提取实体,调用 API 验证账户状态,并输出严格的 JSON。以下对比使用的是示例价格(请始终基于你自己的数据和当前 Bedrock 定价进行基准测试):
| 指标 | 模型 A(标价较低) | 模型 B(标价较高) |
| 输入标价 | $0.50 / 1M token | $1.00 / 1M token |
| 输出标价 | $1.50 / 1M token | $3.00 / 1M token |
| 分词器效率(第 1 轮输入) | 1,500 token | 1,000 token |
| 输出冗长度(最终响应) | 450 token | 150 token |
| 所需智能体循环次数 | 3 轮(错误纠正) | 1 轮(零样本) |
| 所有轮次的累计输入 token | 6,150 | 1,000 |
| 所有轮次的累计输出 token | 750 | 150 |
| 单任务总成本 | $0.0042 | $0.00145 |
模型 A:(6,150 x $0.50 + 750 x $1.50) / 1,000,000 = $0.0042
模型 B:(1,000 x $1.00 + 150 x $3.00) / 1,000,000 = $0.00145
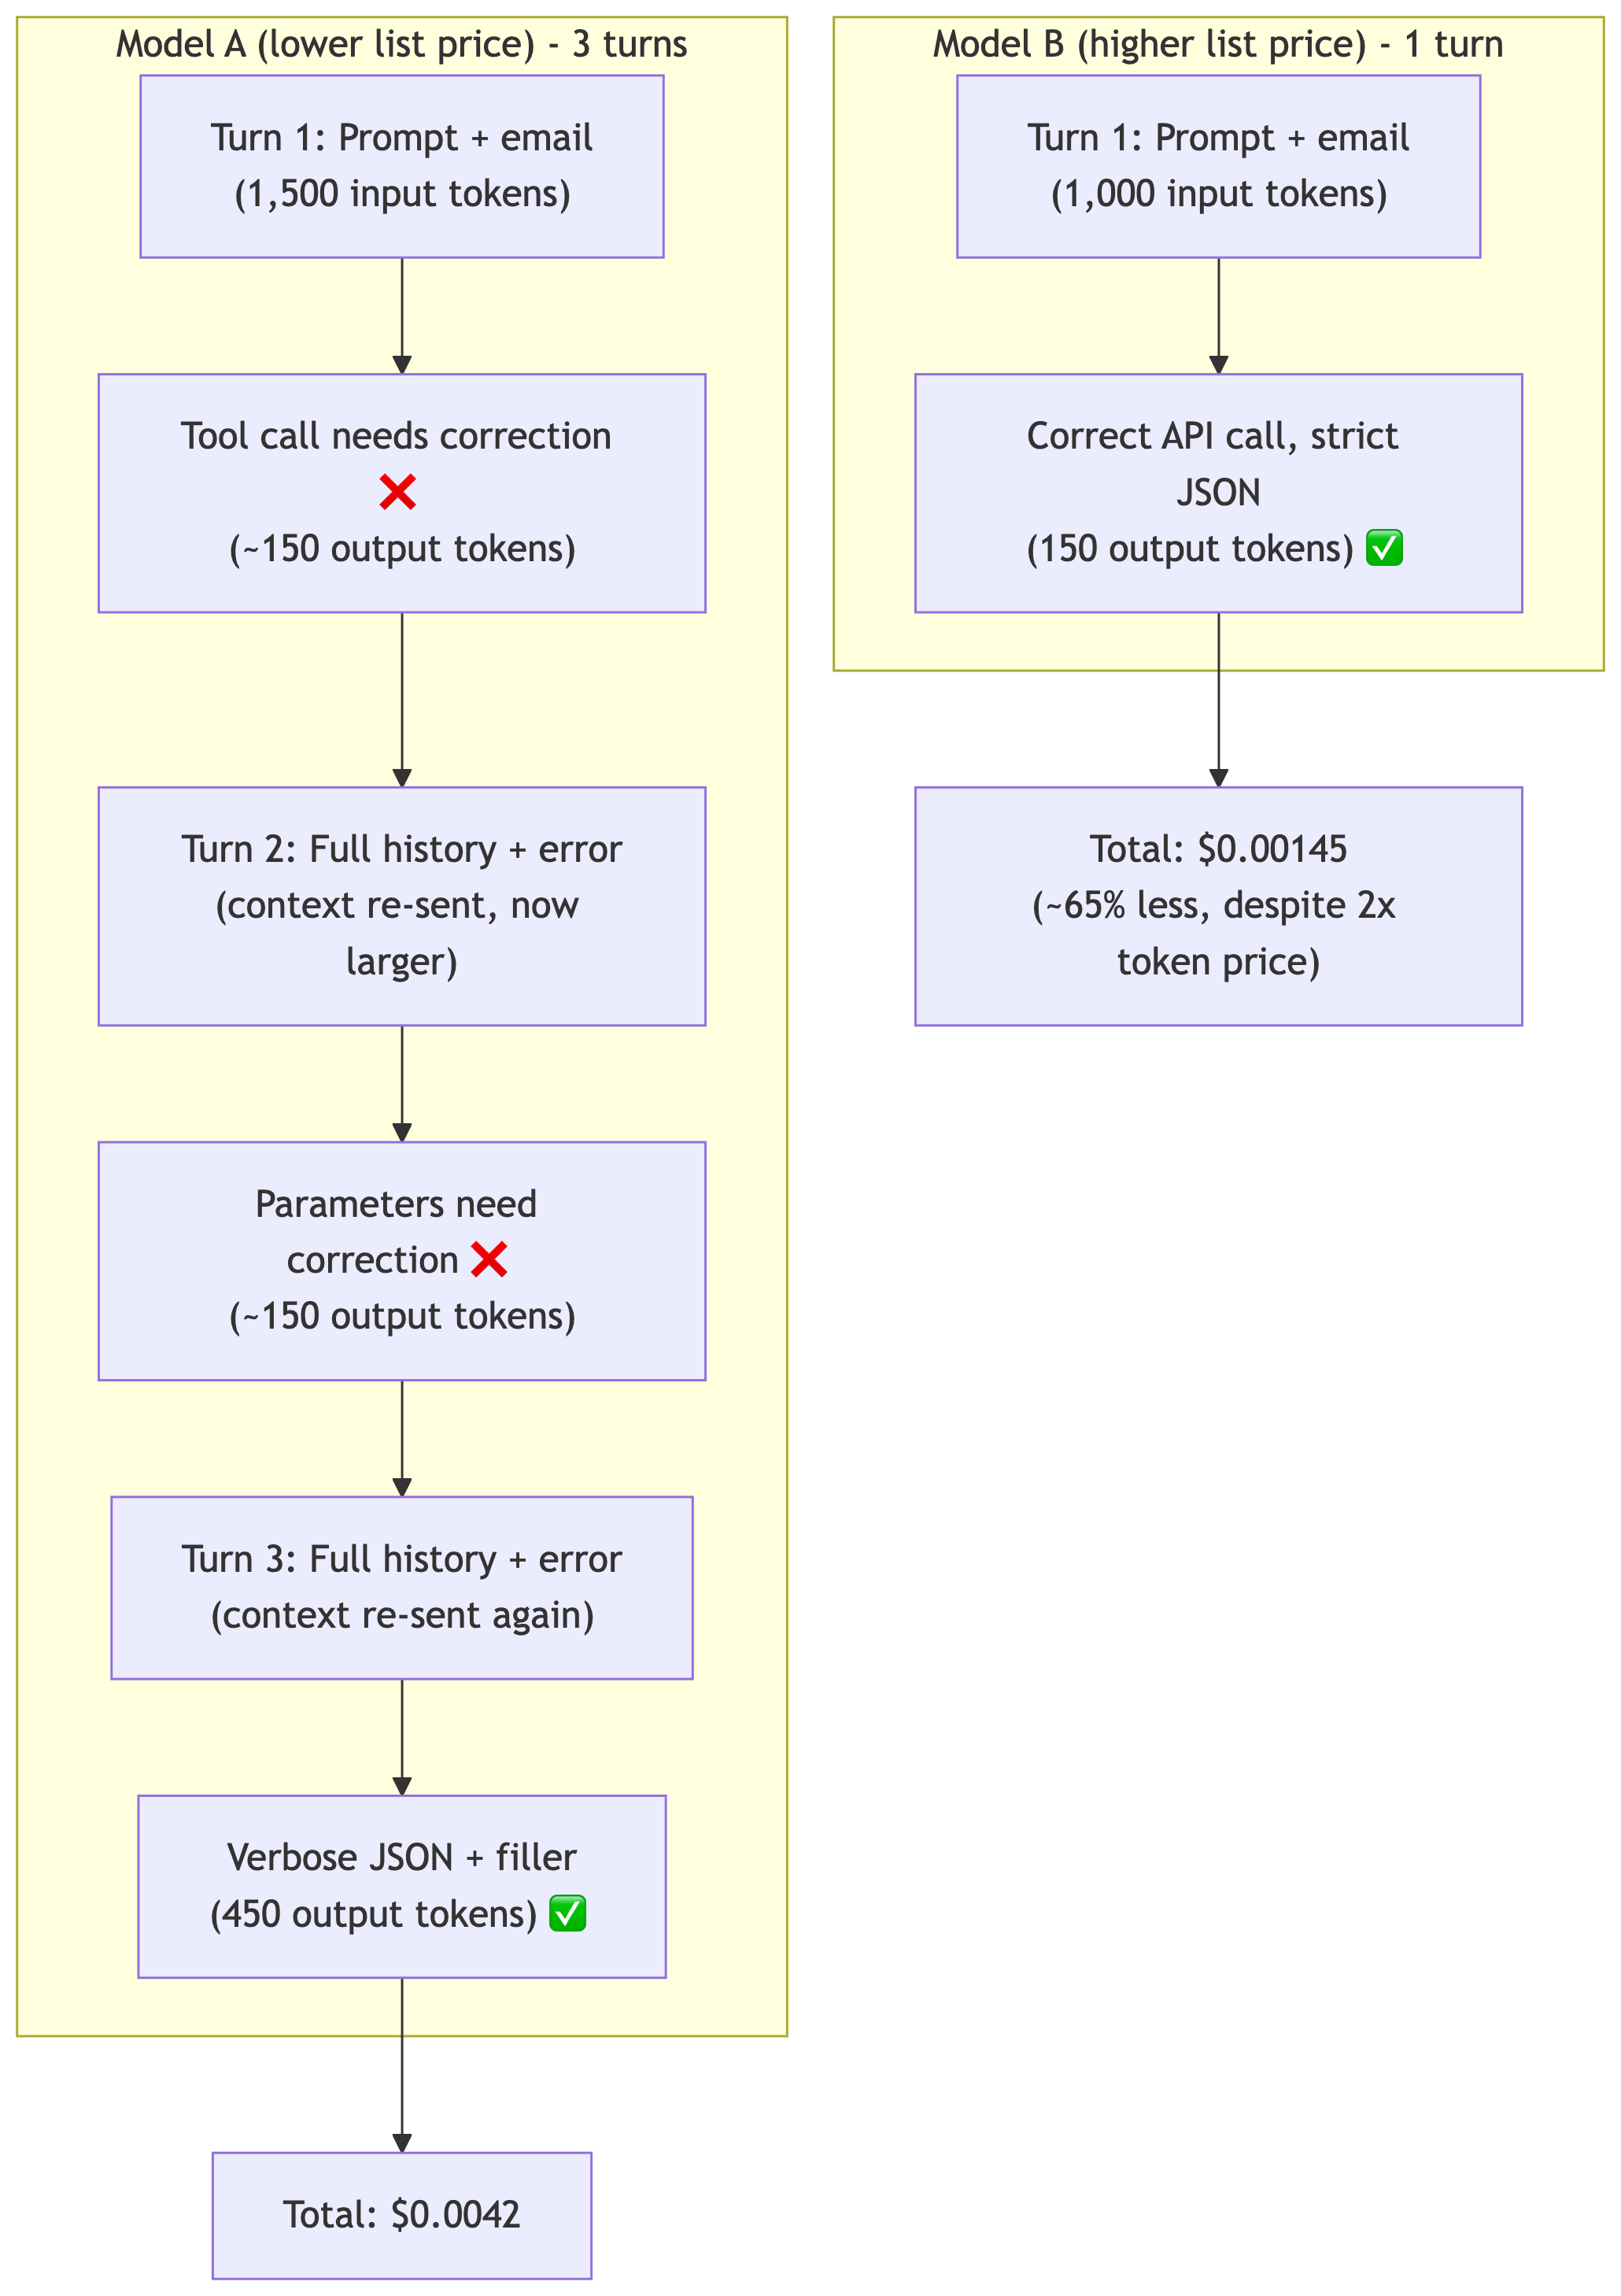
图 2:为什么标价更高的模型反而便宜 65%。每一轮额外的调用都会重新发送不断增长的上下文负载,使账单不断叠加
为什么标价 2 倍的模型反而便宜 65%:三个叠加因素。模型 A 的分词器把邮件切分出多 50% 的 token,导致每一份输入负载都膨胀。它在 JSON 中填充冗余内容,使输出 token 增加到三倍。而且它与工具模式不匹配,需要两轮纠正,每轮都会重新发送不断增长的历史记录。
单次成功任务的成本
前面的例子假设两个模型最终都能成功。在生产环境中并非如此,而且失败很少是免费的。公式如下:
对于重试直到成功的工作流:
cost per successful task = cost per attempt / success rate
对于失败后升级处理的工作流:
cost per successful task = cost per attempt + (1 - success rate) x escalation cost
当提示词缓存启用时,输入会进一步分为三类:按基础费率计费的未缓存输入、低于基础费率的缓存读取,以及高于基础费率的缓存写入。
在你自己的工作负载上进行测量
哪个模型实际上更便宜,只有基于你自己的数据进行基准测试才能显现。Amazon Bedrock 模型评估是用于完成其中质量评估部分的托管功能:定义评估标准、上传你的提示词数据集,即可获得带有自动指标和可选人工审核的评分结果,无需自建基础设施。
不过,仅有质量评分并不能生成账单。另外三项 Bedrock 功能可以提供与之对应计价所需的 token 数和轮次数:
- CountTokens 返回某个模型针对给定负载会收取的输入 token 数,而无需实际运行推理。这是在花费任何生成成本之前,比较候选方案分词器效率(驱动因素 #1)的最廉价方式。
- 模型调用响应包含一个
usage代码块,其中有inputTokens、outputTokens、cacheReadInputTokens和cacheWriteInputTokens。将单个任务的各个轮次中这些数值累加起来,就得到前文每次尝试成本公式中的四项。有一个陷阱:启用缓存时,inputTokens只统计未缓存的 token,因此你的总输入量是inputTokens + cacheReadInputTokens + cacheWriteInputTokens。把它们加总可以了解占用规模,但要分开计价,因为三者按不同费率计费。在整个过程中要多次评估这一点,并根据当前活跃的负载来设置缓存检查点。缓存检查点的漂移会随着应用的发展而发生,工具也会变得陈旧。这意味着三个月后,当漂移发生时,你将向缓存写入更多内容。持续评估你的数据以实现最优缓存使用,成为降低成本的主要杠杆。 - 模型调用日志记录 将每次调用的 token 数写入 Amazon Simple Storage Service(Amazon S3)或 Amazon CloudWatch Logs,这样你就可以用真实的生产流量而非样本来衡量完成任务所需的轮次数。用 请求元数据 标记调用,以便按团队、功能或实验切分这些记录的 token 数。然而,这些只是日志字段,而非成本分配标签,绝不会出现在 AWS Cost Explorer 或你的成本与使用报告中。应用程序推理配置文件 则可以同时到达两者,粒度为每天每个使用类型。这种粒度适合内部计费,但对于每个任务的成本来说太粗糙。将记录的 token 数乘以公布的费率,可以得到接近实时的估算值,而不是账单。除非你自己建模,否则它不会反映承诺折扣、批量定价或预置吞吐量。在把它当作账单之前,先与你的成本与使用报告对账。
降低每任务成本:四个杠杆
四个驱动因素各有一个对应的杠杆,每个都有详细的文档说明。提示词缓存 可减少重复发送的上下文——正是它让模型 A 变得昂贵,因此它在智能体路径上收益最大。智能提示词路由 将简单的请求发送到同一家族中更便宜的模型。一个 工具架构 加上 maxTokens 上限,比文字指令更可靠地抑制冗长输出,而扩展思考功能在基准测试证明其物有所值之前应保持关闭。批量推理 将批量单轮工作的费率减半,尽管它排除了工具调用和多轮交互。
证明智能体 ROI:描述人工基线
高效不等于有价值。一个智能体可能被完美地优化了,却仍然不值得运行。决定预算的问题是:这个智能体比原来的人类做得更好吗?
先记录人工流程
智能体 ROI 分析中最大的错误,就是在没有先描述人工工作流的情况下试图证明价值。在构建或扩展智能体之前,用操作性的术语写下当前流程:什么触发这项工作,涉及哪些人工角色,交接环节在哪里,完成如何定义。这听起来像官僚主义,实际上是测量设计。下游的每个插桩决策(什么算作一次运行、什么算作成功、人工时间花在哪里)都源自这份描述。
在智能体上线之前测量基线
按照上述流程,在一个有意义的时间窗口内测量人类基准:完成时间、排队时间、实际投入、重开率、升级率、单任务成本以及成果质量。基准必须在智能体上线之前测量,而不是事后凭记忆重构。回溯性的基准会系统性地美化智能体的表现:人们记住的是平均情况,却忘记了那些快速完成的。
把工作流作为实验进行监测
基准建立之后,从第一天起就把智能体工作流作为一个实验进行监测。每次运行都有一个 trace ID,每个有意义的步骤都是可观测的。一个工作流运行记录将模型调用之上的所有内容聚合为一个可分析的单元:
{
  "runId": "run-8f3a2c",
  "workflow": "renewal-risk-summary",
  "agent": "renewal-agent",
  "principalArn": "arn:aws:sts::123456789012:assumed-role/BedrockRuntimeRole/gw-alex",
  "team": "sales-ai",
  "costCenter": "CC-2041",
  "experiment": {
    "variant": "treatment",
    "holdout": False,
    "promptVersion": "v14",
    "policyVersion": "2026-07"
  },
  "ops": {
    "latencyMs": 41200,
    "retries": 1,
    "toolCalls": 6,
    "humanApprovals": 1,
    "humanMinutes": 35,
    "escalations": 0
  },
  "econ": {
    "inputTokens": 48210,
    "outputTokens": 3105,
    "cacheReadTokens": 31500,
    "estCostUsd": 0.87
  },
  "outcome": {
    "status": "success",
    "accepted": True,
    "reopened": False,
    "revenueEventId": "opp-44121"
  }
}
有三个字段值得强调:
experiment block(实验块):在运行创建时打上标记,并传播到 Bedrock 的 请求元数据 中,使模型级和工作流级的记录能够干净地关联。
humanMinutes(人工分钟数):这是大多数团队遗漏、却又最需要的字段。没有它,“智能体完成了工作”的说法就悄悄抹去了人工审查所花费的 35 分钟。
revenueEventId(收入事件 ID):这是让日后的收入归因成为可能的挂钩。记录它毫无成本,事后却无法重构。
规则是:如果工作流遥测数据无法回答业务问题,那么监测就是不完整的。
将成本与结果关联
当 调用日志 落入 Amazon S3(第 1 部分),工作流运行记录存入你的分析存储后,只需一次关联就能得到真正重要的指标。Amazon Bedrock 日志记录的是 token 而不是美元,因此首先要构建一个视图,根据 token 数量和你的模型费率为每次调用定价,并按运行 ID 聚合。然后用 Amazon Athena 查询:
SELECT
  w.workflow,
  w.variant,
  COUNT(*) AS runs,
  SUM(IF(w.outcome_status = 'success', 1, 0)) AS successes,
  ROUND(SUM(c.est_cost_usd) /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 2)
    AS cost_per_success,
  ROUND(SUM(w.retries) * 1.0 /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 2)
    AS retries_per_success,
  ROUND(SUM(w.human_minutes) /
    NULLIF(SUM(IF(w.outcome_status = 'success', 1, 0)), 0), 1)
    AS human_min_per_success
FROM workflow_runs w
JOIN invocation_costs_by_run c ON c.run_id = w.run_id
GROUP BY w.workflow, w.variant
ORDER BY cost_per_success DESC注意:前面查询中显示的列名和关联键仅供参考。请根据你的调用日志模式和工作流遥测存储进行核实,它们可能因实现而异。
单次成功结果的成本、每次成功的重试次数以及每次成功的人工分钟数,是经受住持怀疑态度的 CFO 审视的三个数字。单次调用成本会美化那些陷入循环的智能体,而单次成功成本则不会。注意变量分组方式:同一个查询,按实验分支拆分,就是 ROI 对比。
正确地比较智能体与人类
最可信的评估是 A/B 测试或保留组测试。受控的实验组和对照组将智能体辅助的工作流与人类基准进行比较,而不会让市场、季节性或组织变化混淆结果。
对于面向客户或与收入相关的工作流,按访客、潜在客户、账户或案例级别进行随机化。对于内部工作流(支持运营、编程助手),使用匹配队列:团队、代码仓库组或小组。
比较涵盖四个维度:
效率:完成时间、节省的工时、排队时间减少。
质量:错误率、通过率、重开率、升级率。
成本:单任务成本、单次成功结果成本、总服务成本。
业务价值:转化率提升、留存率提升、扩展率、每位代表或每个工作流的收入。
如果智能体在一个维度上有所改善,却在另一个维度上明显退化,那么结果就是模糊的,部署需要调整。
收入:最难的指标
效率提升是 ROI 故事中最容易证明的部分。收入影响则更难衡量,而这正是领导层决定投入的指标。在与收入相关的工作流中,应衡量智能体是否改善了转化率、响应时间、交易推进速度或每位销售代表的收入。留出测试是把可归因于智能体的增量收入与业务整体增长区分开来的最可靠方法。
当收入提升确实存在时,对话就会改变。组织不再追问 Bedrock 账单为什么涨了,而是开始追问这些额外的支出是否换来了业务产出的实质性提升。
记分卡
根据我们与客户合作中观察到的有效做法,一个强大的运营模式并不需要五十个指标。真正有效的是一张与决策挂钩的小型记分卡,并对每个生产环境中的智能体定期复盘。
以下阈值只是起点,并非硬性规定。请根据你自己的集群数据和组织环境进行校准。
| 维度 | 指标 | 绿 | 黄 | 红 |
| 采用度 | 活跃用户数 / 目标用户数 | >70% | 40-70% | <40% |
| 质量 | 无需返工完成的任务 | >90% | 75-90% | <75% |
| 效率 | 每周节省的小时数 | >目标 | 目标的 50-100% | <目标的 50% |
| 成本 | 每次成功结果的成本 | ≤预算 | 预算的 1-1.5 倍 | >预算的 1.5 倍 |
| 业务影响 | 相比基准的 KPI 提升 | 显著 | 边际 | 无或为负 |
绿色意味着扩展:智能体在满足成本和质量阈值的同时超越了基准。黄色意味着调优:有潜力但还需改进。红色意味着退役或重新设计:智能体消耗了成本却没有产生足够的可衡量价值。真正愿意退役红色智能体,才能让记分卡的其余部分具有公信力。
结论
在这篇文章中,你学习了如何通过核算四个隐性成本驱动因素(分词器效率、输出对齐、智能体循环效率和推理开销)来计算模型的真实成本,如何通过提示词缓存、模型路由、输出约束和批量推理降低每项任务的成本,以及如何通过衡量人工基准、将工作流作为实验进行监测、把成本与业务结果关联起来、进行留出对比来证明智能体的 ROI。
成本优化部分回答的是“为什么这么贵,我该如何解决”。ROI 部分回答的是“智能体是否比之前的人类做得更好”。再加上第 1 部分的运营模式(归因、观测、执行、优化、运维),它们共同构成一个完整的框架:你能看清是谁花的钱、解释为什么、减少浪费,并为剩余支出提供正当理由。
要开始上手,请使用 Amazon Bedrock 模型评估针对你自己的提示词对候选模型进行基准测试,从 usage 代码块或你的 调用日志中捕获 token 数和对话轮数,对照当前 Bedrock 定价计算费用,再除以成功率。至于 ROI 衡量,请参阅 Well-Architected Agentic AI Lens 了解智能体成本治理的最佳实践。
如果你发现了其他降低每项任务成本或在 Amazon Bedrock 上衡量智能体 ROI 的技巧,欢迎在评论中告诉我们。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com