用 Amazon Nova Multimodal Embeddings 和 Amazon Bedrock AgentCore 构建智能体化工程智能
Agentic engineering intelligence with Amazon Nova Multimodal Embeddings and Amazon Bedrock AgentCore
AWS 展示如何用 Amazon Bedrock AgentCore、Amazon Nova Multimodal Embeddings 和开源 Strands Agents SDK 构建多智能体工程助手,用于航空零部件替代评估。
当合格的航空航天元件停产或交货周期过长时,工程师需要花费数天时间在供应商数据手册、接口控制文件(ICD)和鉴定记录之间交叉比对规格,然后撰写替代方案论证文件供审查。飞行关键元件的错误替代可能导致任务失败,但每项决策背后的证据链往往散落在电子邮件和未成文的经验知识中,因此没有一套正式、可重复的资料包供审查者核验。
在上一篇文章 Manufacturing intelligence with Amazon Nova Multimodal Embeddings 中,我们展示了该模型如何检索纯文本流水线无法触及的、藏在工程图、热力图和数据手册图表中的答案。本文承接上文的检索工作,将这些能力融入一个多智能体系统中,用于汇集替代方案证据,从检索直到起草评估报告。
在本文中,我们将展示如何使用 Amazon Bedrock AgentCore、Amazon Nova Multimodal Embeddings 和开源的 Strands Agents SDK 构建一个多智能体工程助手,以减少元件替代评估中的人工交叉比对工作。一个规划器将工作分派给三个专业智能体,它们会搜索多模态知识库、根据确定性公差规则为候选元件打分、比较元件照片,并用实时网络数据佐证生命周期声明。工程师始终是决策者,因为该系统只负责汇集证据和起草文档,绝不会自行批准任何替代方案。
解决方案概述
该助手围绕一条设计原则构建,即由工程师做出每一项决策,系统则为决策汇集证据。这条原则决定了我们在何处使用大语言模型(LLM),在何处改用确定性代码。
三大支柱定义了该架构:
- 确定性规格匹配评估 – 用 Python 编写的公差规则代码将每个候选元件与参考元件以及工程师陈述的要求进行比对打分。由于相同的输入始终产生相同的通过/标记结论,这些结果可以纳入正式的工程审查。
- 多智能体编排 – 一个轻量级规划器将每个查询路由给三个专业智能体(目录、评估、知识)中的一个或多个,只有当多个专业智能体参与时,监督器才会综合它们的发现。诸如“检查这个轮子是否将停产,寻找替代品并为其打分”这类复杂问题会依次串联全部三个专业智能体。
- 人在回路的决策 – 系统会为工程审查起草论证备忘录和集成影响评估,但它不会推荐或批准替代方案。每次评估还会写入一条与 AS9100 第 8.4 和 8.5.6 节对齐的审计跟踪记录。
下图展示了该架构。
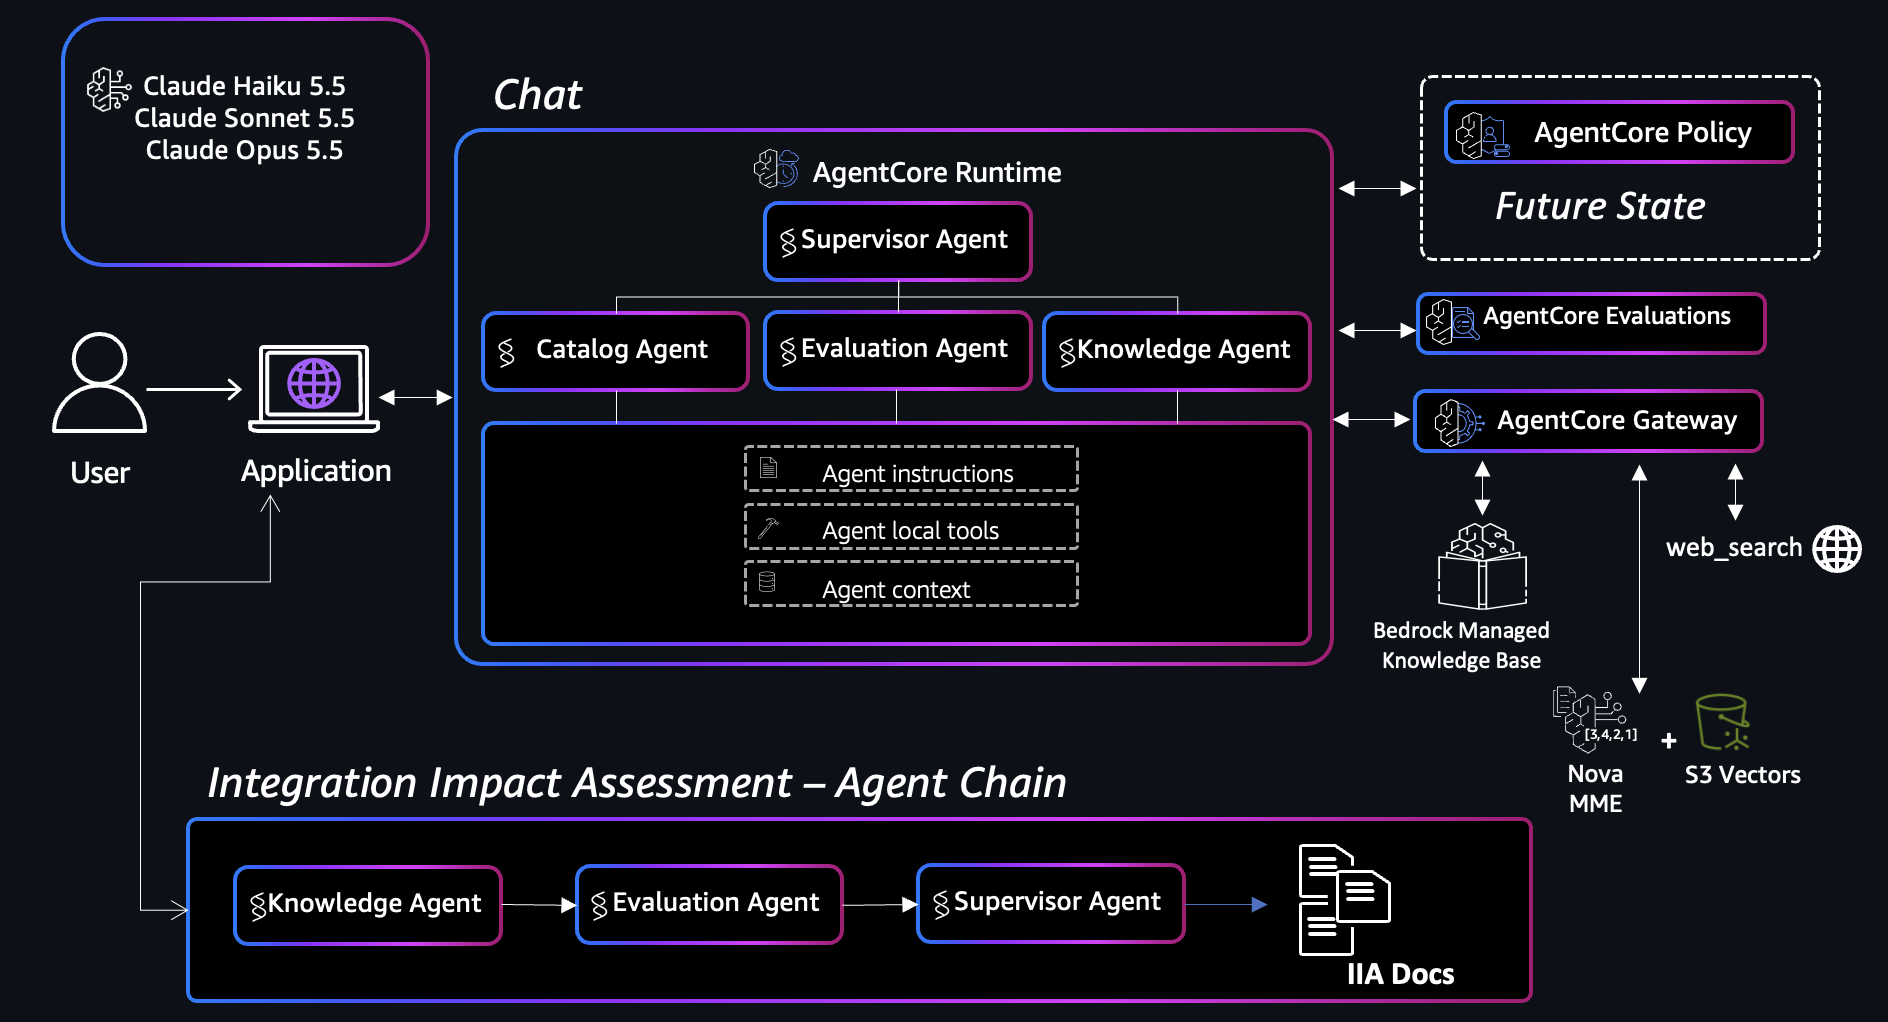
图 1:基于 Amazon Bedrock AgentCore 的多智能体工程助手架构
Amazon Bedrock AgentCore 是一个用于大规模构建、连接和优化智能体的平台,支持任意框架或模型。在本解决方案中,来自工程师应用的聊天请求流入托管在 AgentCore 运行时上的多智能体图:规划器(Claude Haiku 5.5)生成路由计划,专家智能体(Claude Sonnet 5.5)执行各自的工具,当多个专家智能体运行时,监督者(Claude Opus 5.5)综合它们的结果。这些专家智能体从我们使用 Amazon Nova Multimodal Embeddings 通过 Amazon Bedrock Managed Knowledge Bases 创建的托管知识库中检索,经由 AgentCore Gateway(Amazon Bedrock AgentCore 的一项功能)路由,并配合 Web Search 连接器获取实时网络数据。对于以图代查询(上传图表以识别零件)的场景,智能体直接调用原生的 Amazon S3 Vectors 索引,因为托管知识库检索 API 不接受图像输入。Amazon S3 Vectors 是 Amazon Simple Storage Service(Amazon S3)的一项功能。另一个固定链(知识、评估,然后是监督者)生成正式的集成影响评估(IIA)文档。
Amazon Nova Multimodal Embeddings 在两个不同的角色中出现:
- 多模态检索 – 数据手册、ICD 和性能图表使用 Nova Multimodal Embeddings 进行嵌入,使文本和视觉内容共享同一个语义空间。工程师可以输入“0.06 Nms 轮子的扭矩曲线”,或上传一张图表图像,检索会返回匹配的图表及其来源出处。
- 视觉相似度评分 – 当比较两个候选零件时,Nova Multimodal Embeddings 会对它们的照片计算量化的余弦相似度,而 Claude 则分析具体的物理差异(安装孔位、连接器位置、外壳几何形状)。该分数为确定性的规格对比提供佐证,适配性结论正是基于此得出的。
先决条件
要跟着操作,你需要:
- 一个 AWS 账户,并有权访问美国东部(弗吉尼亚北部)AWS 区域的 Amazon Bedrock。
- 在 Amazon Bedrock 中获得 Amazon Nova Multimodal Embeddings、Claude Haiku 5.5、Claude Sonnet 5.5 和 Claude Opus 5.5 的模型访问权限。有关各区域的模型可用性,请参阅 Amazon Bedrock 中 AWS 区域的模型支持。
- 一个使用 Amazon Bedrock Managed Knowledge Bases 创建的托管知识库,基于你的零件语料库(数据手册、ICD、描述)使用 Amazon Nova Multimodal Embeddings 进行文本和文档检索。
- 一个基于你的零件照片和数据手册图表裁剪图的 Amazon S3 Vectors 索引,用于以图代查询路径。
- 一个 Amazon Bedrock AgentCore Gateway,配置有 Web Search 连接器和托管知识库目标。
- Python 3.10 或更高版本,以及用于运行笔记本的 Jupyter。
- Docker(如果你要改编笔记本 03 中的部署方案以在 AgentCore 运行时上托管智能体)。
- 来自 GitHub 仓库 的示例代码。
解决方案演练
以下各节按照查询使用系统的顺序介绍系统的各个部分。我们从零件语料库和专家智能体开始,然后介绍路由、确定性评分、助手使用 Nova Multimodal Embeddings 的两种方式、生成正式文档的固定链,以及部署到 AgentCore 运行时。
完整的代码示例是 GitHub 仓库中的五个 Jupyter 笔记本,每个笔记本都可以独立运行。这些笔记本从 mei_core 导入内容——这是同一文件夹中智能体和工具模块的一个自包含副本——并且它们自带零件数据、图表截取图和评估查询集。你可以直接在笔记本中运行本文的每个代码片段,无需其他应用程序代码。
构建零件语料库
示例数据集是来自虚构制造商(AnyCompany)的七个反作用轮,动量存储范围 spanning 0.003–5.0 Nms。每个零件是一个文件夹,其中将结构化数据与工程师实际阅读的源文档配对,正是这种混合使语料库具有多模态特性。specs.json 文件保存着驱动确定性评分的机器可读字段,而 ICD、产品照片和渲染的数据手册页面则承载着结构化字段未能涵盖的视觉和叙述性细节。
data/synthetic-parts-data/rw_rl_0060/
├── specs.json # structured specs + lifecycle fields
├── description.txt # flat text for text retrieval
├── AC-ICD-00068-RW3-0.06-Interface-Control-Document-v2.2.pdf
├── datasheet_page.png # rendered datasheet page
├── datasheet_chart.png # cropped chart region (image-as-query index)
└── photo.png # product image (visual similarity + chart matching)
specs.json 文件既包含工程规格,也包含生命周期档案,这使得助手能够同时标记过时风险与交期风险以及规格匹配度。
{
  "name": "AnyCompany RW3 0.06",
  "category": "reaction_wheel",
  "vendor": "AnyCompany",
  "model": "RW3-0.06",
  "momentum_storage_nms": 0.06,
  "max_torque_mnm": 20,
  "mass_g": 235,
  "voltage_v": "28",
  "voltage_range_v": "7.5 to 36",
  "operating_temp_c": "-30 to +70",
  "interface": "RS-422 or Redundant RS-485",
  "qual_standard": "AnyCompany internal (flight heritage qualified)",
  "lifecycle": {
    "lifecycle_status": "Active",
    "production_status": "Full production",
    "estimated_years_to_eol": "10+",
    "last_time_buy": "Not announced",
    "typical_lead_time_weeks": 10,
    "lead_time_risk": "Low",
    "bathtub_region": "Useful life (highly mature)",
    "recommended_screening": "Standard flight acceptance"
  }
}
每个零件的 vendor 字段都是明确标注的。由于目录文件夹 ID 和文件名在不同数据集中会被复用,每个专家提示词都将 get_part_specs 返回的结构化 vendor 值视为权威信息,并禁止从 ID、文件名、照片或网络搜索结果中猜测制造商。从结构化数据中获取制造商信息,可以防止助手因为模型自认为认出了硬件而将零件错误归到某个供应商。
每个零件文件夹还包含两个纯文本索引无法利用的资源。产品照片用于视觉相似度评分,渲染的数据手册页面则包含力矩盒图和力矩曲线图,能够回答任何 OCR 文本层都无法捕捉的性能问题。Amazon Nova Multimodal Embeddings 将这两者嵌入到与文本相同的向量空间中,因此一次查询可以匹配规格值、段落或图表。
下面的示例展示了语料库中的四页数据手册,动量存储跨度达三个数量级。
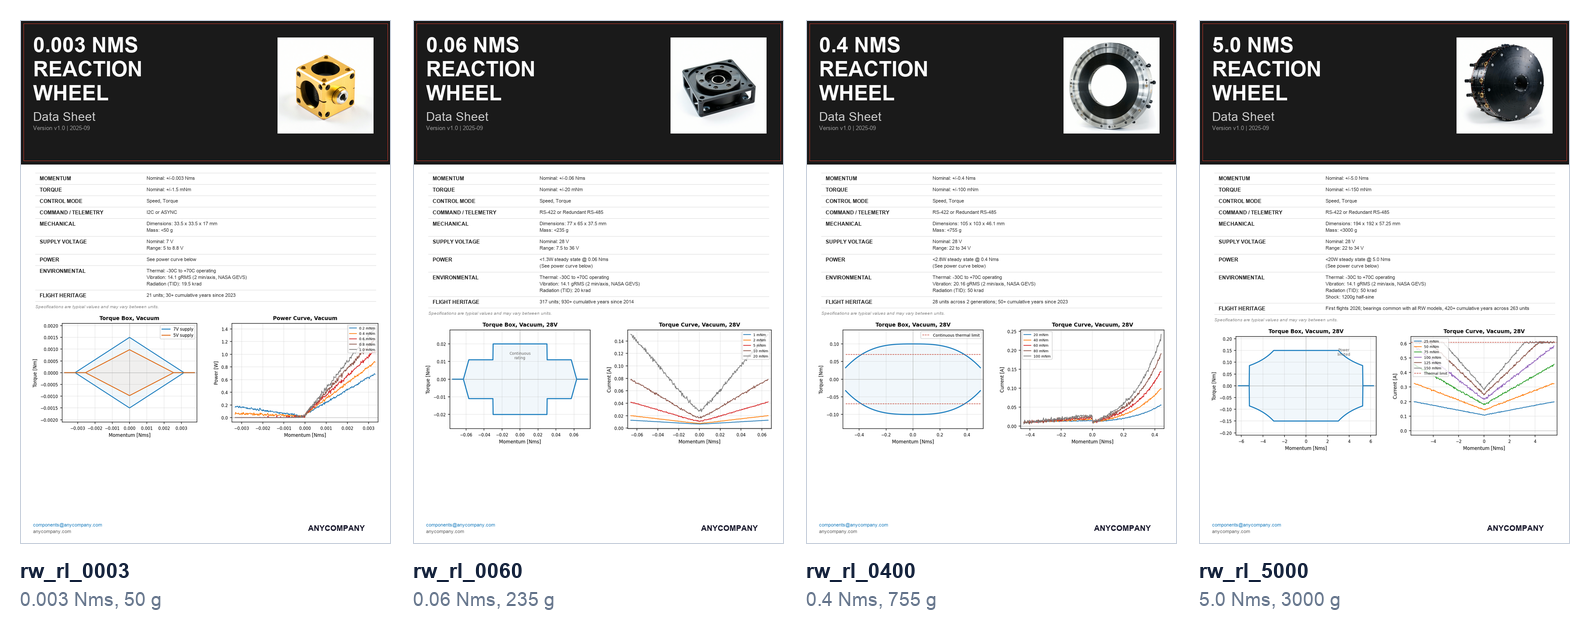
图 2:零件语料库中的四页数据手册,动量存储跨度达三个数量级
模板在该系列中重复出现,但产品照片和两张性能图表随每个零件而变化。这些区域显示了外壳几何形状、安装孔位、力矩包络和功耗,这些是规格字段没有直接说明的,因此我们将它们与文本一起嵌入。
用限定范围的工具定义专家
每个专家都是一个 Strands 智能体,带有狭窄的提示词和仅其所需的工具。为每个专家限定工具范围可以保持行为的可预测性,因为 Knowledge 专家无法访问目录发现工具,而 Catalog 专家无法访问评估工具。以下代码创建了 Evaluation 专家。
from strands import Agent

def create_evaluation_specialist() -> Agent:
    """Evaluation Specialist: deterministic spec-by-spec comparison and scoring."""
    return Agent(
        name="evaluation_specialist",
        system_prompt="""You are the Evaluation Specialist. Your job is to run
deterministic, spec-driven comparisons between parts.
...
RULES:
- Your comparisons are deterministic (code, not opinion)
- NEVER recommend or approve --- present evidence and flags; the engineer decides
- Always include the disclaimer that this is evidence only""",
        tools=[score_substitution_fit, compare_parts, visual_similarity_score,
               check_qualification_status, generate_substitution_memo],
        model="us.anthropic.claude-sonnet-5-5",
    )
下图展示了规划器如何将查询路由到各专家,以及监督者何时综合它们的结果。其后的列表描述了每个专家的职责。
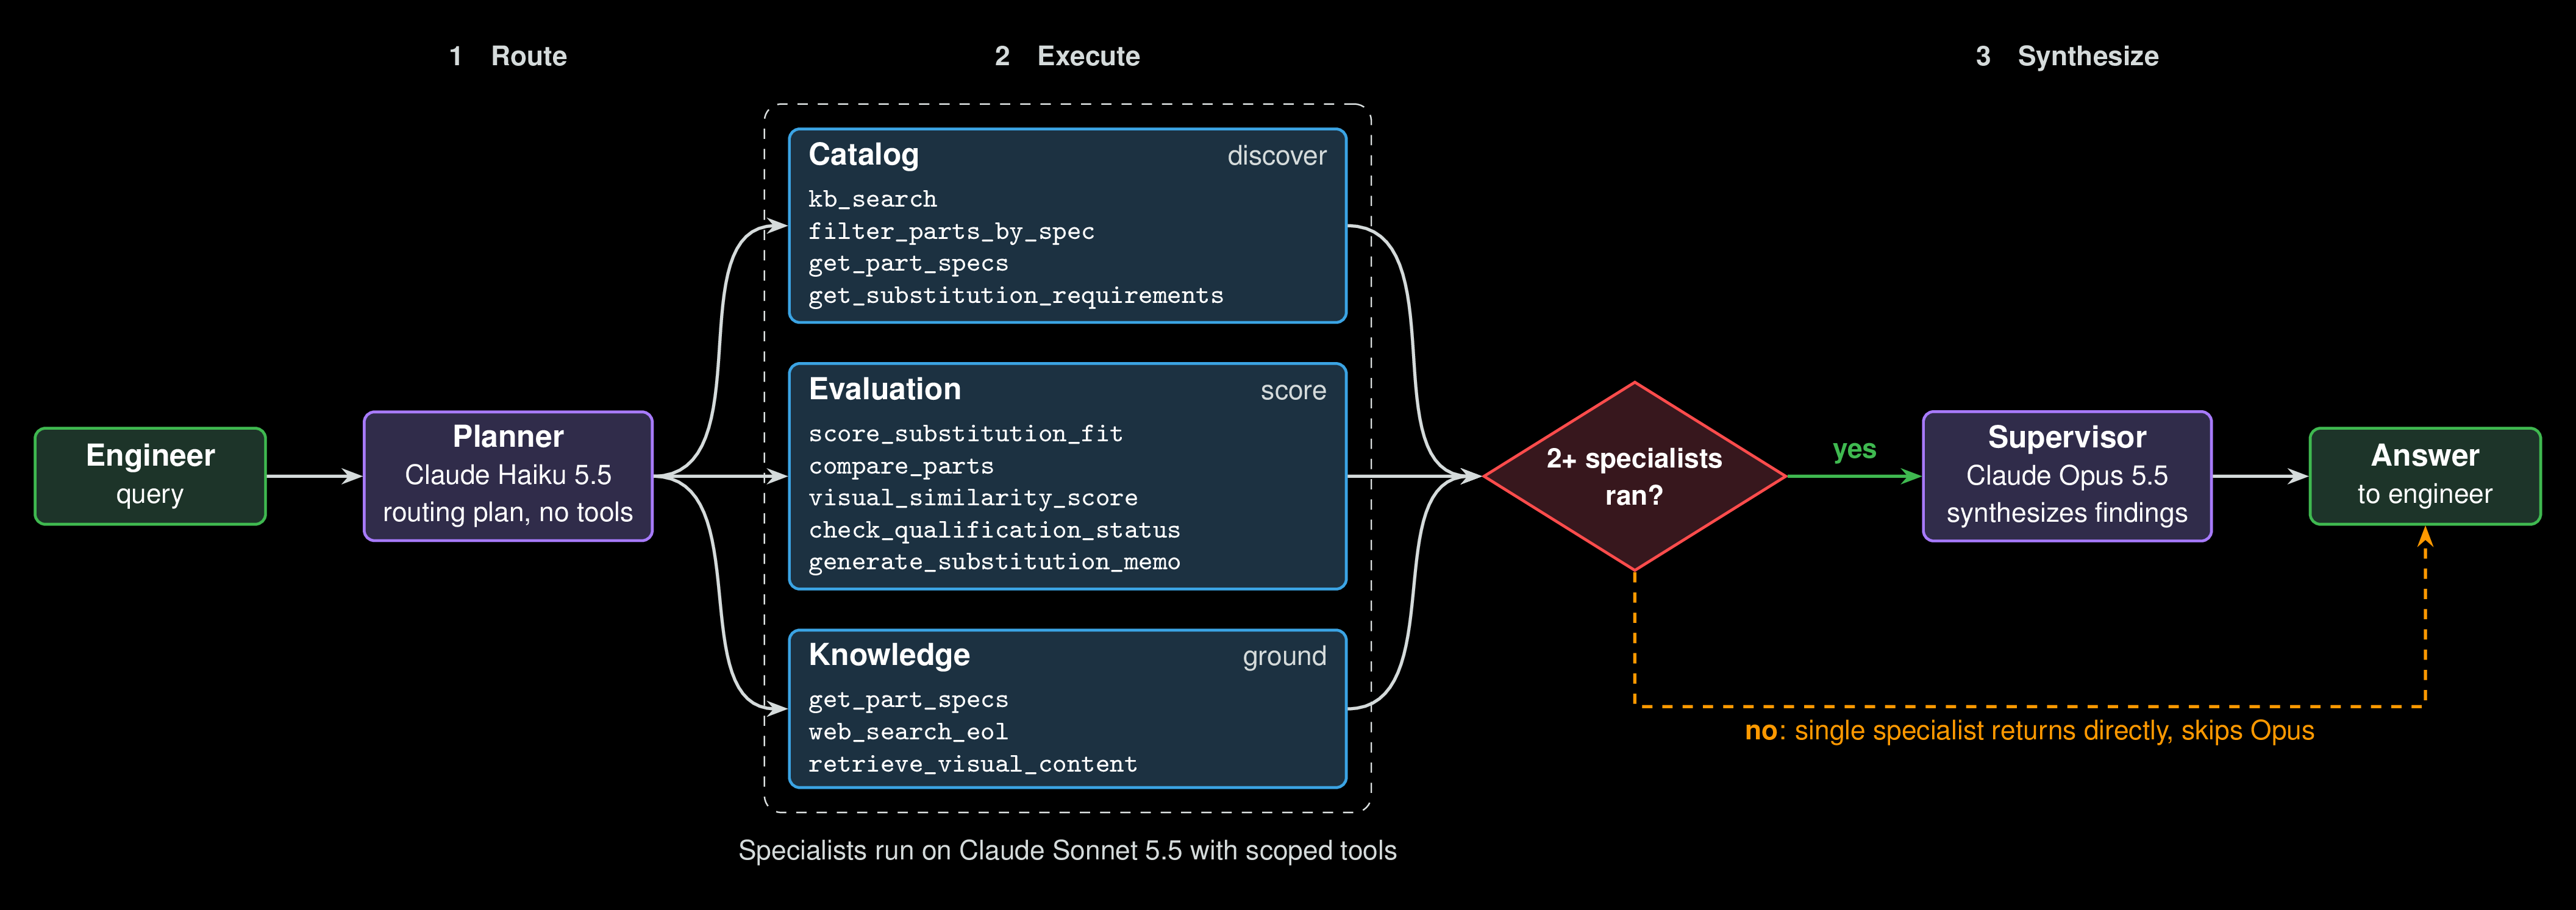
图 3:规划器如何将查询路由到各专家以及监督者何时综合结果
- Catalog – 通过知识库搜索和穷举式规格筛选来发现零件(
kb_search、filter_parts_by_spec、get_part_specs、get_substitution_requirements)。 - Evaluation – 确定性地为候选零件评分并进行视觉比较(
score_substitution_fit、compare_parts、visual_similarity_score、check_qualification_status、generate_substitution_memo)。 - 知识 – 回答来自数据手册和 ICD 的问题,检查实时的停产(end-of-life)状态,并检索可视化内容(
get_part_specs、web_search_eol、retrieve_visual_content)。
使用小模型进行路由,使用大模型进行综合
路由是一个无需工具调用的分类任务,因此不需要大型推理模型。基于 Haiku 的规划器在几秒钟内返回一个带编号的路由计划。只有当两名或以上专家都参与了回答时,Opus 主管才会运行,因为综合单个专家本已完整的答案会增加约 8 秒的延迟,却没有任何质量提升。
# Step 1: Planner (fast model) plans the routing (may be multi-step).
plan_response = planner(planning_prompt)
ordered_specialists = _parse_specialist_plan(str(plan_response))

# Step 2: Execute specialists in sequence, passing context forward
accumulated_context = ""
for spec_name in ordered_specialists:
    specialist = specialists[spec_name]
    specialist_response = specialist(spec_prompt)
    accumulated_context += f"\n[{spec_name.upper()}]: {specialist_response}\n"

# Step 3: Synthesize only when 2+ specialists ran.
if len(ordered_specialists) == 1:
    final_text = steps[0]["response"]
else:
    final_text = str(supervisor(synthesis_prompt))
将工作分配到三个模型层级,使成本和延迟与各阶段相匹配。Haiku 对查询进行分类,Sonnet 运行工具,Opus 撰写综合答案——这是响应质量最关键的一步。
保持评分的确定性
规格符合性评估以普通 Python 代码的形式运行,对照手写的要求模式(schema)。该模式为每个元器件类别定义了关键规格和公差规则,score_substitution_fit 逐项比较规格、统计合格数和标记项,并揭示生命周期风险。由于评估结论必须可供工程审查包复现,此步骤不涉及任何 LLM。
{
  "categories": {
    "reaction_wheel": {
      "critical_specs": [
        {"field": "voltage_v", "label": "Bus voltage (V)",
         "rule": "match", "required_from_user": true},
        {"field": "mass_g", "label": "Mass (g)",
         "rule": "candidate_lte_reference_within_pct", "tolerance_pct": 20,
         "required_from_user": false}
      ]
    }
  }
}
该工具返回一个带明确免责声明的结构化结论:
return {
    "spec_results": results,  # per-spec pass/flag/review status
    "counts": counts,
    "out_of_tolerance": out_of_tolerance,
    "lifecycle": {...},  # obsolescence and lead-time flags
    "summary": summary,
    "disclaimer": "Evidence only. This tool does not recommend or approve "
                  "a substitution; the engineer decides.",
}
专家呈现该表格并解释标记项,但它无法更改结论。审计追踪遵循同样的分工。每次评估后,编排层会读取专家的工具调用历史并自行撰写审计条目,因此日志记录不依赖于模型主动记得去做。
使用 Amazon Nova Multimodal Embeddings 评分视觉相似度
当替代件必须安装到现有支架上时,外形尺寸至关重要。visual_similarity_score 工具使用 Nova Multimodal Embeddings 对两张零件照片进行嵌入并计算余弦相似度,然后让 Claude 描述具体可观察到的差异。
def embed_image(image_bytes):
    """Embed one image with Nova MME (IMAGE_RETRIEVAL) -> 1024-d vector."""
    b64 = base64.b64encode(image_bytes).decode('utf-8')
    fmt = 'png' if image_bytes[:8] == b'\x89PNG\r\n\x1a\n' else 'jpeg'
    body = {
        'taskType': 'SINGLE_EMBEDDING',
        'singleEmbeddingParams': {
            'embeddingPurpose': 'IMAGE_RETRIEVAL',
            'embeddingDimension': 1024,
            'image': {'detailLevel': 'STANDARD_IMAGE', 'format': fmt,
                      'source': {'bytes': b64}},
        },
    }
    resp = bedrock.invoke_model(
        modelId='amazon.nova-2-multimodal-embeddings-v1:0',
        body=json.dumps(body), accept='application/json',
        contentType='application/json',
    )
    result = json.loads(resp['body'].read())
    return np.array(result['embeddings'][0]['embedding'])

# cosine similarity of the two photo embeddings
emb_a, emb_b = embed_image(photo_a_bytes), embed_image(photo_b_bytes)
similarity = float(np.dot(emb_a, emb_b) /
                   (np.linalg.norm(emb_a) * np.linalg.norm(emb_b)))
嵌入相似度是确定且可复现的:同一产品系列的两个轮子返回约 0.84,不同类别的轮子返回约 0.40。随后 Claude 的视觉分析会解释造成差异的原因,例如指出其中一个外壳的直径约为另一个的两倍,并且采用六孔安装模式,而另一个是四孔。
通过两条检索路径检索图表和示意图
文本和文档查询经由以 Amazon Nova Multimodal Embeddings 为支撑的托管知识库,并通过 AgentCore Gateway 路由。以图搜图(上传图表或照片以查找匹配内容)则使用一个直接从智能体调用的原生 Amazon S3 Vectors 索引,因为托管知识库的检索 API 不接受图像输入。
知识专家的 retrieve_visual_content 工具为两条路径提供统一接口。工程师可以把需求文档中的性能曲线粘贴到聊天中,询问哪个零件与之匹配,也可以改用文本查询来描述该图表。
# Image-as-query: embed the uploaded image with Nova MME, exactly as the
# datasheet crops and photos were embedded at indexing time.
def embed_query_image(image_bytes):
    b64 = base64.b64encode(image_bytes).decode('utf-8')
    fmt = 'png' if image_bytes[:8] == b'\x89PNG\r\n\x1a\n' else 'jpeg'
    body = {'taskType': 'SINGLE_EMBEDDING', 'singleEmbeddingParams': {
        'embeddingPurpose': 'IMAGE_RETRIEVAL', 'embeddingDimension': 1024,
        'image': {'detailLevel': 'STANDARD_IMAGE', 'format': fmt,
                  'source': {'bytes': b64}}}}
    r = bedrock.invoke_model(modelId=NOVA_MME_MODEL_ID, body=json.dumps(body),
                             accept='application/json', contentType='application/json')
    return json.loads(r['body'].read())['embeddings'][0]['embedding']
在图像路径上,上传内容使用 IMAGE_RETRIEVAL 用途以 1,024 维的 Nova Multimodal Embeddings 进行嵌入,然后与 S3 Vectors 索引进行匹配:
# Query the native S3 Vectors index and collapse to the best vector per part.
emb = embed_query_image(image_bytes)
s3v = boto3.client('s3vectors', region_name=REGION)
fetch_k = max(top_k * 6, 12)  # each part has several vectors; dedupe below
resp = s3v.query_vectors(
    vectorBucketName=S3_VECTOR_BUCKET, indexName=S3_VECTOR_INDEX,
    queryVector={'float32': emb}, topK=fetch_k,
    returnDistance=True, returnMetadata=True,
)

best = {}
for v in resp.get('vectors', []):
    meta = v.get('metadata', {}) or {}
    pid = meta.get('part_id', '')
    if not pid:
        continue
    sim = 1.0 - v.get('distance', 1.0)  # cosine distance -> similarity
    if pid not in best or sim > best[pid]['score']:
        best[pid] = {'part_id': pid, 'score': sim}
ranked = sorted(best.values(), key=lambda r: r["score"], reverse=True)[:top_k]
由于一个零件会产生多个向量(其照片、整页数据手册以及每个裁剪出的图表区域),结果在送达模型之前会去重,只保留每个零件得分最高的向量。
在构建检索路径的过程中,我们总结了三条实用经验:
- 在建立索引前裁剪图表 – 完整的数据手册页面作为索引条目效果很差,因为页面中大约 90% 的内容(页眉、规格表、页脚)是每个器件都相同的模板内容,而这些共享内容会在嵌入中占据主导地位。将裁剪后的图表区域与完整页面一起索引解决了这个问题。在我们的测试中,图表上传匹配的正确率从整页索引时的 7 个器件对 3 个,提升到使用图表条带裁剪后的 7 个全对。我们将裁剪区域定义为页面宽高的比例值,这保证了它们在不同数据手册分辨率下都保持正确。
- 当工程师指名器件时过滤结果 – 仅靠跨模态的文本到图像相似度无法可靠地返回正确器件的图表,因为扭矩曲线图像中不包含可见的器件名称。当工程师指定某个具体器件时,该工具只保留来自该器件已索引内容的结果,它通过从每条结果的 S3 URI 中解析出器件文件夹来识别。由于该过滤在工具内部运行,因此无需在索引中使用自定义元数据即可工作。
- 记录图像路径上的每次回退 – 图像路径在出错时返回
None,然后回退到文本检索。这种回退本身是合理的,但它意味着 AgentCore 运行时执行角色上缺少s3vectors:QueryVectors权限时不会引发错误。以图查询功能会毫无预警地停止工作,然后模型会以看似很高的置信度报出错误的器件。这个问题在开发过程中很容易被忽略,因为本地开发者凭证的权限通常比运行时角色更宽泛。现在,只要该路径发生回退,工具就会显式记录一条包含存储桶、索引和区域的S3 Vectors image query FAILED警告。请对检索路径中的每一个静默回退都进行监测,因为硬性失败远比悄无声息的失败更容易诊断。
通过固定的专家链生成正式文档
聊天使用动态路由,因为自由提问所需哪些专家无法事先确定。集成影响评估的工作方式则不同。当工程师为参考器件和候选器件的组合请求影响评估时,所需的执行顺序已经确定,因此服务会以固定的顺序组合相同的专家工厂函数,并使用专门构建的综合提示词。
# 1. Knowledge Specialist --- ICD/datasheet interface detail for both parts
knowledge_text = str(knowledge(knowledge_prompt))

# 2. Evaluation Specialist --- structured field delta + qualification check
evaluation_text = str(evaluation(evaluation_prompt))

# Deterministic structured delta for exact summary stats
comparison = compare_parts(reference_id, candidate_id)

# 3. Supervisor --- synthesize into the six-section IIA document
markdown = str(supervisor(synthesis_prompt))
生成的文档涵盖接口变更、机械集成、电气集成、热集成、认证差异和供应链影响。叙述性章节需要 LLM 综合,因为引脚定义和协议细节必须从 ICD 文本中提取。摘要统计信息(匹配项、差异项、总字段数)直接从 compare_parts 输出计算得出,因此叙述旁显示的数字是精确的。
通过 AgentCore Gateway 用实时网络数据支撑生命周期声明
目录数据会过时,因此知识专家的 web_search_eol 工具通过带有 Web Search 连接器的 AgentCore Gateway 检查当前的停产通知、供应商公告和交货周期。该 Gateway 将连接器暴露为一个受治理的 Model Context Protocol (MCP) 端点。由于 Gateway 还处理托管知识库检索,你可以在一处统一为外部和内部数据访问附加策略和可观测性。
部署到 AgentCore 运行时
在生产环境中,您将智能体打包为 ARM64 容器,推送到 Amazon Elastic Container Registry (Amazon ECR),然后由 AgentCore runtime 以无服务器方式托管它,并提供会话隔离和自动扩缩。GitHub 存储库中的 Notebook 03 以参考配方的形式详细介绍了此部署过程,涵盖 Dockerfile、构建和推送命令、执行角色权限以及 Cedar 策略。该 notebook 展示了这些步骤但并未实际运行。它的 Dockerfile 打包了超出示例范围的应用程序代码,因此在构建之前请根据您自己的应用程序布局进行调整。下图展示了从智能体代码到托管的 AgentCore runtime 端点的部署路径。
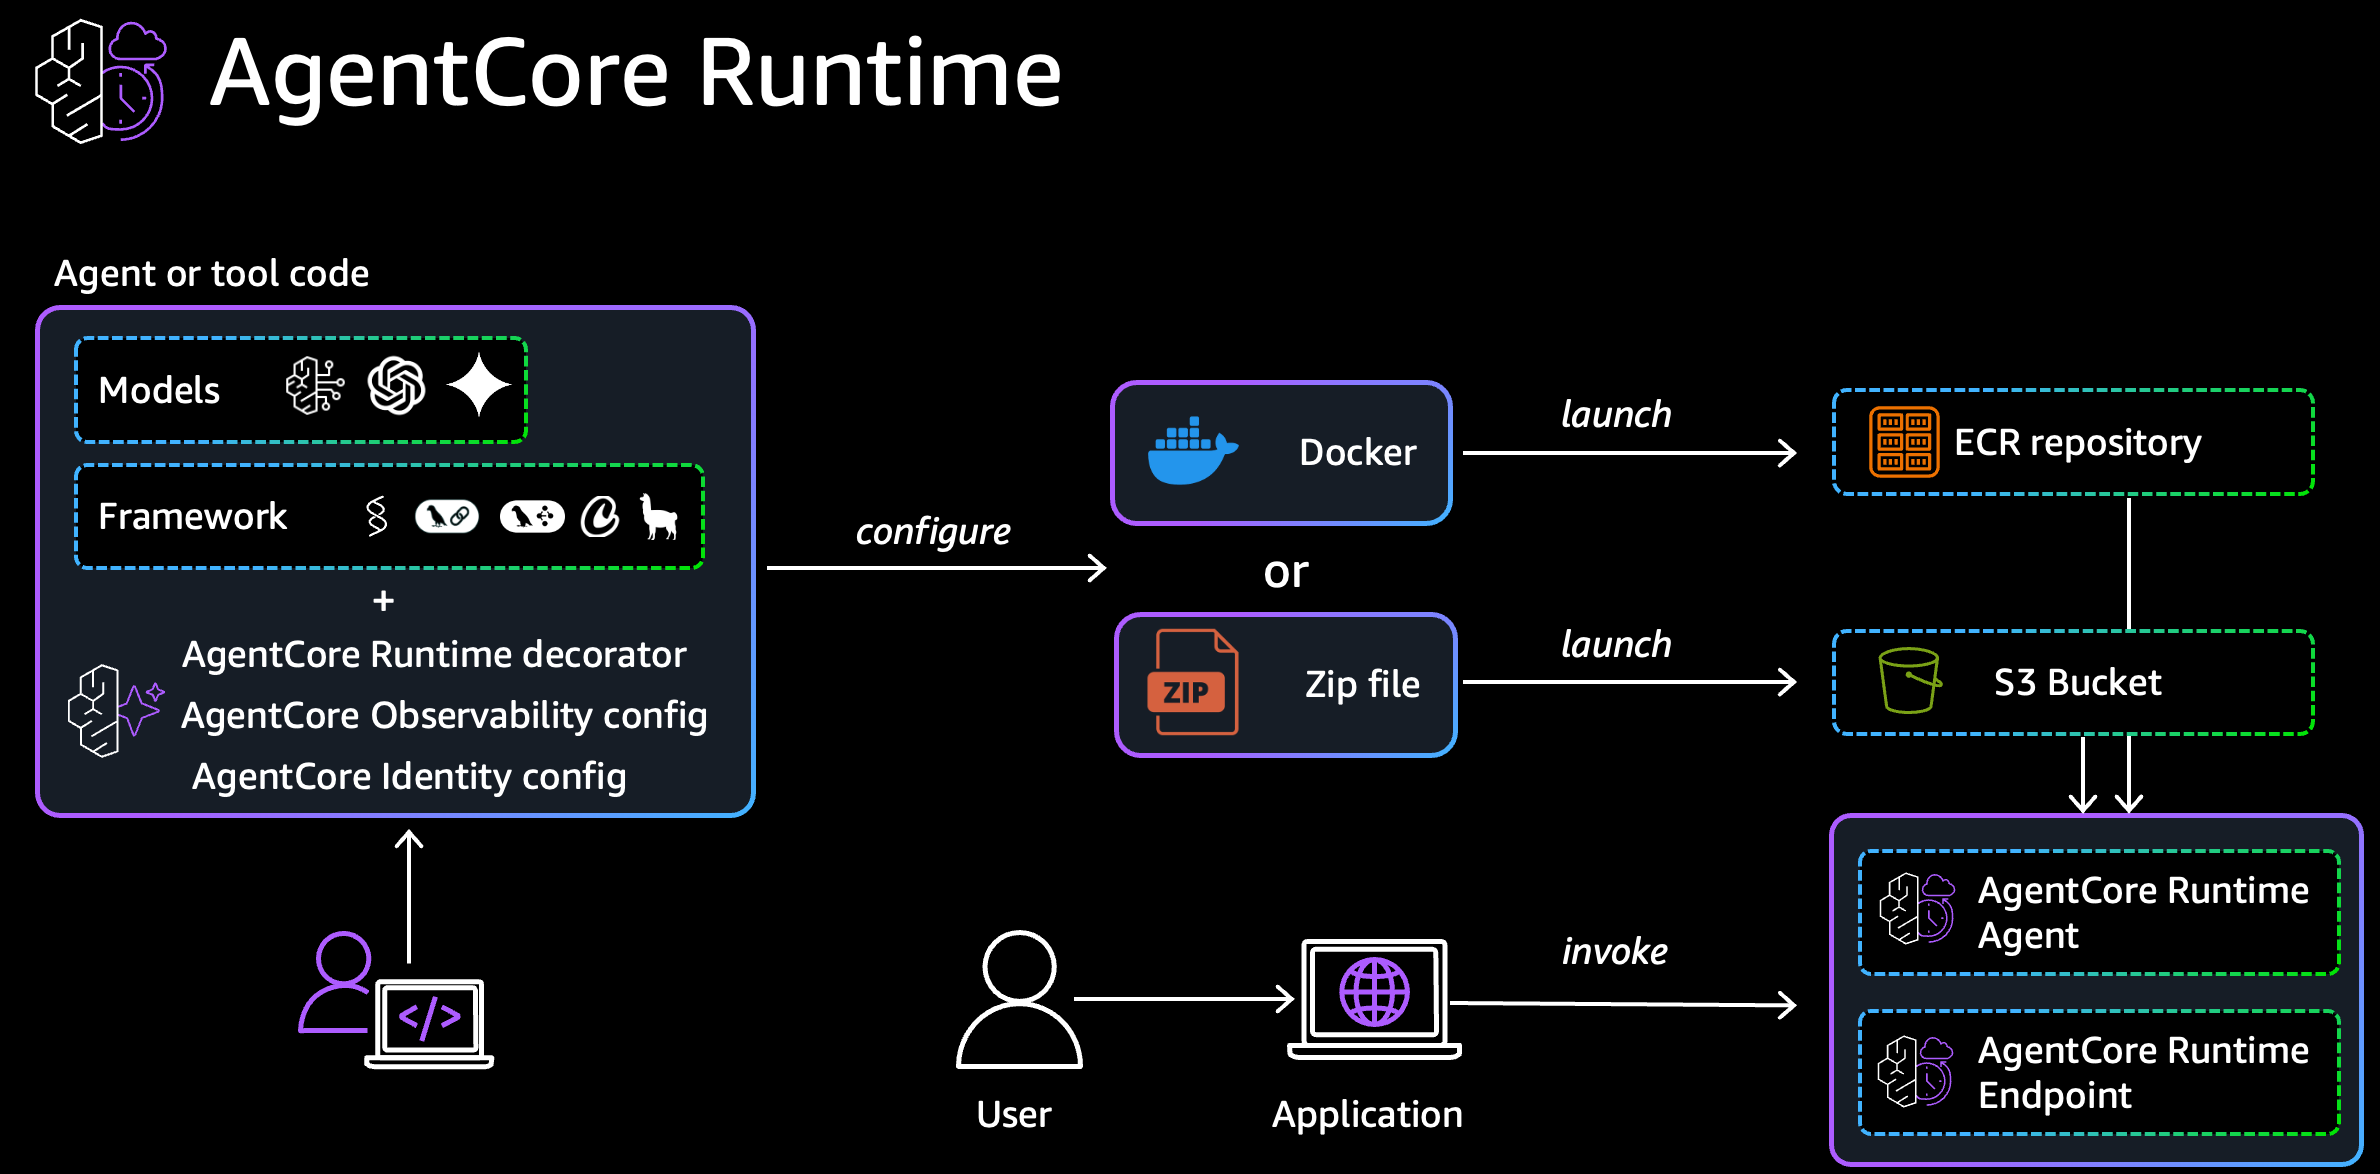
图 4:从智能体代码到托管的 AgentCore runtime 端点的部署路径
export TAG=mei-$(date +%Y%m%d-%H%M%S)
export ACCOUNT=<your-account-id>
export ECR=${ACCOUNT}.dkr.ecr.us-east-1.amazonaws.com/mfg-engineering-intelligence

# Build the container for ARM64 (required by AgentCore Runtime)
docker buildx build --platform linux/arm64 -f agentcore/Dockerfile \
  -t mfg-engineering-intelligence:${TAG} --load .

# Push the immutable tag to Amazon ECR
aws ecr get-login-password --region us-east-1 \
  | docker login --username AWS --password-stdin ${ACCOUNT}.dkr.ecr.us-east-1.amazonaws.com
docker tag mfg-engineering-intelligence:${TAG} ${ECR}:${TAG}
docker push ${ECR}:${TAG}
为每个镜像赋予一个不可变标签。已经在移动的 :latest 标签后面解析出摘要的 runtime,在您推送新镜像后会继续使用旧镜像。提示词、路由和工具的更改都需要新镜像和新的 runtime 版本才能生效。
runtime 角色在镜像即查询的路径中需要 bedrock:InvokeModel、bedrock:Retrieve、bedrock-agentcore:InvokeGateway 和 s3vectors:QueryVectors。Notebook 03 中显示的 Cedar 策略编码了人在回路的规则,要求在生成备忘录之前先进行评估,并在每次替换决策时写入审计日志条目。目前应用程序在其自身逻辑中强制执行这些规则,下一步是将该策略附加到 Cedar 授权引擎上。
Amazon Nova Multimodal Embeddings 现已在 AWS GovCloud (US) 上线,这对于受数据驻留、ITAR 和 FedRAMP 要求约束(这些要求规定了工作负载可以在哪里运行)的航空航天和国防项目至关重要。本文所依赖的多模态检索和视觉相似性功能可以在 AWS GovCloud (US) 边界内使用。Amazon Nova Multimodal Embeddings 和 Amazon Bedrock AgentCore 功能的可用性因 AWS 区域而异,因此在规划部署之前请查看 AWS Services by Region。
评估助手
我们通过两种方式衡量质量:一是通过 AgentCore Evaluations(Amazon Bedrock AgentCore 的一项功能)进行持续的在线评分,二是针对精选的查询集进行离线验证。
AgentCore 在线评估
Amazon Bedrock AgentCore Evaluations 自 2026 年 3 月起正式发布,使用 LLM-as-a-judge 技术对智能体轨迹进行评分。它读取 Strands 智能体已经发出的 OpenTelemetry 轨迹,因此经过插桩的智能体无需更改应用程序即可进行评估。该服务提供两种模式。在线评估持续采样生产环境中的实时会话,而按需评估则运行适合持续集成和持续交付 (CI/CD) 流水线的程序化测试。
我们使用在线评估,并将结果发布到 Amazon CloudWatch 以用于仪表板和警报。GitHub 存储库中的 Notebook 05 会创建一个在线评估配置,并向已部署的 runtime 发送测试查询以生成用于评分的会话。
config = eval_client.create_online_config(
    config_name=CONFIG_NAME,
    agent_id=RUNTIME_ID,
    sampling_rate=SAMPLING_RATE,
    evaluator_list=[
        "Builtin.GoalSuccessRate",
        "Builtin.Correctness",
        "Builtin.Helpfulness",
        "Builtin.Faithfulness",
        "Builtin.ResponseRelevance",
        "Builtin.ToolSelectionAccuracy",
        "Builtin.ToolParameterAccuracy",
    ],
    auto_create_execution_role=True,
    enable_on_create=True,
)
该服务附带 13 个内置评估器,同时支持以提示词定义或托管为 AWS Lambda 函数的自定义评估器。我们启用了 7 个,涵盖所有三个评分级别:
| 级别 | 评估器 | 评分内容 |
| 会话 | Goal Success Rate | 对话是否端到端地实现了用户的目标? |
| 轨迹 | Correctness | 信息在事实层面是否准确? |
| 轨迹 | Helpfulness | 回复是否有用且有价值? |
| 轨迹 | Faithfulness | 回复是否忠实于检索到的上下文? |
| Trace | 响应相关性 | 响应是否回应了用户的实际查询? |
| 工具调用 | 工具选择准确性 | 智能体是否选对了工具? |
| 工具调用 | 工具参数准确性 | 智能体是否正确提取了参数? |
精选查询集包含跨六个类别的 36 个查询:目录发现(8)、知识与 ICD 检索(8)、多专家链(6)、确定性评估(5)、文本到视觉检索(5),以及人机协同安全拒绝(4),后者断言智能体会拒绝推荐或批准。每个查询都带有预期的目录部件 ID,安全查询除外——其预期结果是拒绝。
export AGENTCORE_RUNTIME_ARN=arn:aws:bedrock-agentcore:us-east-1:ACCOUNT:runtime/YOUR_RUNTIME
jupyter lab 05_evaluation.ipynb
结果
AgentCore 持续对线上会话进行采样,因此每个评估器的分数是一个动态聚合值,会随着流量累积和智能体变更而变化。以下数字是合成数据集运行的一个快照。可将它们用作设置 CloudWatch 告警阈值的基线,并预期你自己运行得到的数字会有所不同。
| 级别 | 评估器 | 分数(30 天平均值) |
| Session | 目标成功率 | 0.892 |
| Trace | 正确性 | 0.968 |
| Trace | 有用性 | 0.956 |
| Trace | 忠实度 | 0.981 |
| Trace | 响应相关性 | 0.968 |
| 工具调用 | 工具选择准确性 | 0.861 |
| 工具调用 | 工具参数准确性 | 0.980 |
所有 trace 级别的质量指标得分均达到或超过 0.95,工具参数提取接近完美,为 0.980。两次评估运行之间最显著的改进是工具选择准确性,从 0.809 提升至 0.861。三项变更带来了这一提升:整合为单一托管知识库、修复了图像作为查询路径上一个导致静默回退到文本搜索的缺失权限,以及收紧了规划器的路由以避免串联不必要的专家。
目标成功率较低,为 0.892,这是由查询集的设计方式造成的。查询集包含要求智能体推荐或批准替代方案的安全类别提示。智能体正确地拒绝了,但评估器将正确的拒绝计为未达目标。这是我们预期的结果,因为在人机协同系统中,智能体不得自行批准替代方案。
将该模式适配到你自己的目录
这份代码是一个可复用的模式,适用于反应轮之外的其他部件类别。更换领域需要三处变更:替换部件数据(每个部件包含一个 specs.json、描述、ICD、数据表页面和照片)、编辑需求 schema 以定义你所在类别的关键规格和公差规则,并将知识库指向你的 S3 语料库。智能体、工具和评分引擎保持不变。由于 mei_core 中的确定性工具是普通的 Python 函数,PLM 或 ERP 集成可以直接调用 score_substitution_fit,无需智能体参与。
清理
为避免持续产生费用,请删除你创建的资源:
- 删除 AgentCore 运行时智能体及其 Amazon ECR 仓库。
- 删除 AgentCore Gateway 及其 Web Search 和知识库目标。
- 删除 在线评估配置以及你创建的 CloudWatch 告警。
- 删除 托管知识库和 S3 Vectors 索引。
- 删除存放部件语料库的 S3 存储桶。
结论
在这篇文章中,我们展示了如何构建一个多智能体工程助手,用自动化证据组装取代人工的零部件替代研究。该架构将 Amazon Nova Multimodal Embeddings(负责视觉相似度评分和纯文本系统容易遗漏的图表检索)与 Amazon Bedrock AgentCore(提供运行时托管、网关管控的检索与网络搜索以及质量评估等生产级脚手架)相结合。有三个设计选择最为关键:确定性的代码生成每一次通过/不通过判定;每项任务都运行在能胜任它的三个模型层级中最小的那一个;并且只有工程师才能批准替代方案。
要开始使用,请克隆这个 GitHub 仓库,用您自己的 AWS 账户运行笔记本,并替换为您自己的零部件目录和需求模式。想深入了解检索基础,请阅读 Manufacturing intelligence with Amazon Nova Multimodal Embeddings 和 A practical guide to Amazon Nova Multimodal Embeddings。关于生产级智能体模式,请参阅 Amazon Bedrock AgentCore 文档和 Strands Agents SDK。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com