在 Amazon SageMaker AI 上用 llama.cpp 部署决策模型
Deploy decision models with llama.cpp on Amazon SageMaker AI
AWS 介绍了在 Amazon SageMaker AI 上使用 llama.cpp 部署决策模型的两种路径:通过 AWS DLC 提供 OpenAI 兼容的 chat completions,以及通过 SemIf(原 OpenJev)子镜像直接返回声明选项的概率,无需解码答案 token。
在请求路由、智能体动作选择或策略结果分配等应用中,往往需要对固定的选项集合输出分数,而不是生成自由文本。通过 llama.cpp 和 Amazon SageMaker AI 部署这些决策模型,为您提供了在 CPU 或 GPU 基础设施上服务量化模型的托管路径。
本文是关于用于生成式 AI 推理的专用 AWS Deep Learning Containers(DLC)系列的延续。之前的文章涵盖了 WhisperX、vLLM-Omni – Part 1 和 vLLM-Omni – Part 2。
在本文中,您首先使用 AWS DLC for llama.cpp 通过 SageMaker AI InvokeEndpoint 提供 OpenAI 兼容的聊天补全服务。然后,您将在同一运行时中扩展 SemIf(原名 OpenJev),它无需解码答案 token 即可返回各声明选项的概率。随附的 代码示例 包含 CPU 和 GPU 部署选项。
解决方案概览
图 1 展示了基于同一打包模型的两种部署路径。文本生成路径使用 AWS DLC for llama.cpp,并通过 OpenAI 兼容 API 返回生成的响应。结构化决策路径则构建一个子镜像,将默认服务器替换为 SemIf 适配器,并返回各声明选项的概率。
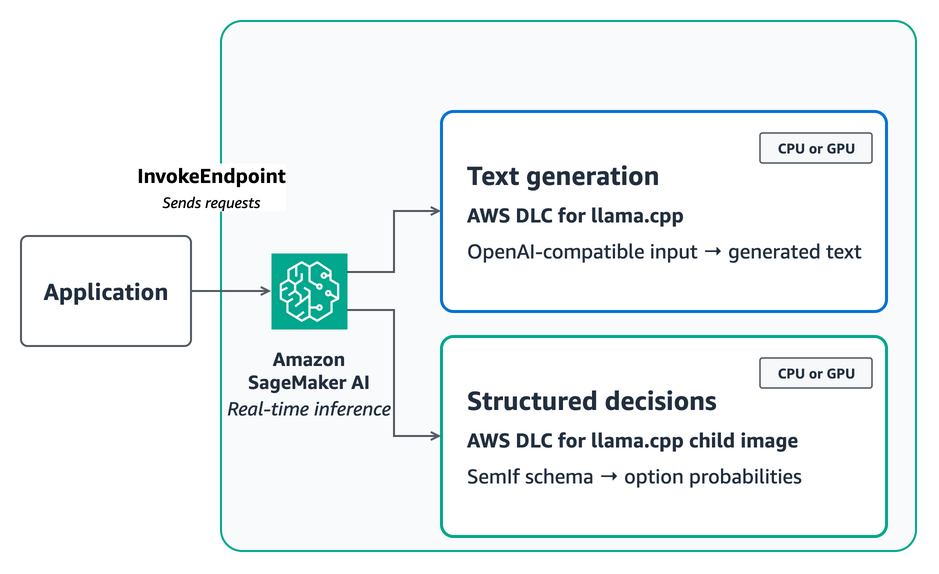
图 1:根据工作负载的 API 和延迟需求,在 CPU 或 GPU 上运行 AWS DLC for llama.cpp 或 SemIf 子镜像
对于标准路径,将模型打包为 model.tar.gz 存放在 Amazon Simple Storage Service (Amazon S3) 中,并直接引用已发布的 DLC 镜像。容器会查找 /opt/ml/model 下的第一个 .gguf 文件,将 POST /invocations 映射到 /v1/chat/completions 处的 llama-server,并将 SM_LLAMA_CPP_* 环境变量传递给 llama.cpp 参数。
llama-server HTTP API 并不暴露 SemIf 所使用的最终位置 logits 和状态操作。因此,结构化决策路径使用 AWS CodeBuild 构建子镜像并将其存储在 Amazon Elastic Container Registry (Amazon ECR) 中。该子镜像保留 DLC 编译好的 CPU 或 CUDA 库,同时将其入口点替换为兼容 SageMaker 的适配器。
了解输入和输出架构
AWS DLC for llama.cpp 接受 OpenAI Chat Completions 架构。发送一个包含 role 和 content 的 messages 数组,以及 max_tokens 和 stream 等生成控制参数:
{
  "messages": [
    {
      "role": "user",
      "content": "A customer cannot receive a password reset email. Reply with the best support queue."
    }
  ],
  "max_tokens": 64,
  "stream": false
}
响应使用 OpenAI 兼容的 choices 数组。从 choices[0].message.content 中读取生成的文本。
SemIf 使用受限的决策架构而非聊天消息。请求包含调用方定义的 ID、非结构化状态、一个问题以及一个有序的允许选项列表:
{
  "decision": {
    "id": "support-route",
    "state": "The customer cannot receive a password reset email.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access support."},
      {"id": "billing", "description": "Billing support."}
    ]
  }
}
响应按相同顺序返回 option_ids、probabilities 和原始 option_logits,以及提示词、计时和固定的模型元数据。借助稳定的选项 ID,您的应用无需解析生成的文本即可应用阈值、回退和策略检查。
SemIf 属于更广泛的一类决策模型,即从非结构化状态中对应用定义的结果进行评分。其他实现包括 Jev(TypeSafe 的决策模型及 /v1/systemone API);Kev(为兼容 TypeSafe API 而设计的模型服务器);以及 Strands Decider 2B(一款专为智能体工作流构建、输出经过校准的模型)。
选择合适的决策工作流
当您的应用程序在请求时定义允许的选项,并需要模型解释非结构化上下文时,可使用此模式。示例包括将案例路由到队列、从已知集合中提取一个值、分配事件优先级、检查策略结果,或选择智能体操作。请将授权和确定性的业务规则保留在模型之外,并在将模型概率视为运营置信度之前对其进行验证。
当您需要通过 InvokeEndpoint 获得 OpenAI 兼容的聊天补全时,请使用标准的 SageMaker AI 文本生成路径。SageMaker AI 镜像将 POST /invocations 映射到 llama-server /v1/chat/completions 端点。仅当您的应用程序需要此接口无法提供的行为(例如 SemIf 的直接 logits 和状态访问)时,才构建子镜像。
移除答案 token 生成并不会移除模型推理。在 SemIf 读取最终 logits 之前,模型仍会处理完整的状态、问题和选项描述。请保持提示聚焦,并在生产使用前使用您应用程序中带标签的决策来评估所选模型。
针对您的延迟和质量目标进行调优
以下基准测试适用于 SemIf 扩展,而非文本生成端点。模型大小、量化、提示长度、运行时和 CPU 线程数都会影响每次决策。为了量化这些权衡,我们将同样的 231 个公开的 JevBench 任务串行发送到一个 CPU 端点和一个 GPU 端点。
| 配置 | 用于 llama.cpp 的 AWS DLC | 有效响应 | 准确率 | 客户端 p50 | 客户端 p95 |
Qwen3.5-4B Q4_K_M、ml.c6i.8xlarge、32 线程 |
llama-cpp:server-sagemaker-cpu-v1 | 231/231 | 179/231 (77.5%) | 1.715 秒 | 19.291 秒 |
Qwen3.5-4B Q4_K_M、ml.g6e.xlarge、完全 GPU 卸载 |
llama-cpp:server-sagemaker-cuda-v1 | 231/231 | 180/231 (77.9%) | 0.352 秒 | 0.599 秒 |
与 CPU 配置相比,GPU 端点在 p50 上快了 4.9 倍,在 p95 上快了 32.2 倍。该示例使用 SageMaker AI 实例池功能按优先级顺序列出兼容的 GPU 实例类型,因此当第一偏好不可用时,SageMaker 可以选择替代方案。该池的顺序为 g6e、g6、g5,然后是 g4dn。SageMaker 选择了 ml.g6e.xlarge,并且启动日志确认 llama.cpp 将全部 34 个模型层卸载到了 NVIDIA L40S。CPU 和 GPU 镜像使用了不同的 llama.cpp 构建,并在六个困难任务上产生了不同的预测。请将这一答案的准确率差异视为运行时差异,而不是 GPU 卸载能提升模型质量的证据。
更小的模型降低了中位数延迟,但 2B 和 0.8B 候选模型的准确率分别为 66.7% 和 58.4%。因此,该示例保留 4B Q4_K_M 模型作为其质量优先的默认选择。这些测量包含网络延迟,并非服务保证。
请针对您自己的决策对完整的模型和基础设施配置进行基准测试。对于不敏感于延迟、可容忍数秒响应时间的后台、离线或低吞吐量工作负载,请使用 CPU。对于交互式决策、长提示或具有严格尾延迟目标的工作负载,请使用 GPU。保持状态和选项描述简洁,将共享相同状态的决策合并为一个请求,并扩展端点实例以应对并发。共享状态评分会复用共同的提示前缀,而适配器会返回可重试的 HTTP 503 响应,而不是在其有状态的 llama.cpp 上下文周围允许无界队列。
先决条件
您需要:
- 一个 AWS 账户以及位于部署所用 AWS 区域中的 S3 存储桶。
- Python 3.10 或更高版本、Git,以及 AWS 命令行界面(AWS CLI)。
- 用于可选 SemIf 扩展的专用 CodeBuild 服务角色。
- 一个 SageMaker AI 可以代入的 AWS Identity and Access Management (IAM) 角色。
- SageMaker AI、Amazon ECR、Amazon S3、CodeBuild、IAM 传递角色(pass-role)操作以及 Amazon CloudWatch Logs 的权限。
- 兼容的 x86 CPU 或 NVIDIA GPU SageMaker 实时终端节点的配额。
文本生成示例使用 CPU DLC 和固定的 CPU 实例。SemIf 扩展对于非延迟敏感的工作负载默认使用 CPU,并提供带有序实例池的可选 CUDA 镜像。在创建终端节点之前,请查看 SageMaker AI 定价。
部署决策模型并用 SemIf 进行扩展
按照以下步骤部署标准文本生成终端节点,然后构建可选的 SemIf 扩展以在 CPU 或 GPU 上进行结构化决策。
- Clone the code sample and install its dependencies.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/03-features/semif-decision-model python3 -m venv .venv . .venv/bin/activate python3 -m pip install -r deploy/requirements.txt - Set the deployment values for your account.
export AWS_REGION="<your-region>" export ARTIFACT_BUCKET=amzn-s3-demo-semif-artifacts export CODEBUILD_ROLE_ARN=arn:aws:iam::111122223333:role/semif-codebuild-role export SAGEMAKER_ROLE_ARN=arn:aws:iam::111122223333:role/semif-sagemaker-role export STANDARD_ENDPOINT_NAME=llamacpp-gguf export SEMIF_ENDPOINT_NAME=semif-decision-workflows - Package the pinned GGUF model and tokenizer with CodeBuild.
python deploy/prepare_model_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --model-s3-uri "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz"
等待返回的构建 ID 达到
SUCCEEDED。构建过程会在model-manifest.json中记录源代码修订版本和校验和,如果 GGUF 校验和与验证值不一致则会停止。 - Deploy the GGUF model with the AWS DLC for llama.cpp.
从 AWS DLC for llama.cpp 文档中解析一个摘要固定的
server-sagemaker-cpu-v1镜像,然后创建 SageMaker AI 模型、终端节点配置和终端节点:export STANDARD_IMAGE_URI="<published-llama-cpp-cpu-image>@sha256:<digest>" python deploy/deploy_standard_endpoint.py \ --region "$AWS_REGION" \ --image-uri "$STANDARD_IMAGE_URI" \ --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \ --role-arn "$SAGEMAKER_ROLE_ARN" \ --instance-type ml.c6i.2xlarge \ --name "$STANDARD_ENDPOINT_NAME"选择
server-sagemaker-cpu-v1或server-sagemaker-cuda-v1镜像,而不是对应的 EC2 镜像。SageMaker AI 镜像实现了/ping和/invocations容器契约,并将调用载荷映射到聊天补全。本演练通过 Amazon S3 中的 SageMaker AI 模型制品提供 GGUF 模型。或者,当终端节点具有网络出口时,你也可以配置
SM_LLAMA_CPP_HF_REPO和SM_LLAMA_CPP_HF_FILE以从 Hugging Face 下载 GGUF 文件。此路径不需要 Dockerfile 或 ECR 存储库。等待终端节点进入
InService状态,然后发送一个兼容 OpenAI 的聊天请求:python deploy/invoke_standard_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$STANDARD_ENDPOINT_NAME" - Build the optional SemIf child image and resolve its immutable digest.
CPU 版本:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN"
GPU 版本请改为构建 CUDA 子镜像:
python deploy/prepare_build.py \
  --region "$AWS_REGION" \
  --bucket "$ARTIFACT_BUCKET" \
  --codebuild-role-arn "$CODEBUILD_ROLE_ARN" \
  --dockerfile Dockerfile.gpu \
  --image-tag "gpu-$(date +%Y%m%d%H%M%S)"
构建成功后,构造不可变的镜像 URI:
ECR_REPOSITORY_URI=$(aws ecr describe-repositories \
  --region "$AWS_REGION" \
  --repository-names semif-llamacpp-dlc \
  --query 'repositories[0].repositoryUri' \
  --output text)
IMAGE_DIGEST=$(aws ecr describe-images \
  --region "$AWS_REGION" \
  --repository-name semif-llamacpp-dlc \
  --query 'sort_by(imageDetails,&imagePushedAt)[-1].imageDigest' \
  --output text)
export IMAGE_URI="${ECR_REPOSITORY_URI}@${IMAGE_DIGEST}"
部署脚本会拒绝可变的镜像标签。
- Deploy the SemIf endpoint.
CPU 配置使用固定的实例类型:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-type ml.c6i.8xlarge \
  --threads 32 \
  --name "$SEMIF_ENDPOINT_NAME"
等待返回的终端节点名称进入
InService状态。此路径会设置n_gpu_layers=0。适配器将评分围绕单个有状态的 llama.cpp 上下文进行串行化,因此在单个容器内部不要假设存在并行评分,而应在测量你的工作负载后再通过终端节点实例进行横向扩展。对于 GPU 镜像,提供有序实例池并请求完整模型卸载:
python deploy/deploy_endpoint.py \
  --region "$AWS_REGION" \
  --image-uri "$IMAGE_URI" \
  --model-data-url "s3://$ARTIFACT_BUCKET/semif-llamacpp/model.tar.gz" \
  --role-arn "$SAGEMAKER_ROLE_ARN" \
  --instance-pool ml.g6e.xlarge \
  --instance-pool ml.g6.2xlarge \
  --instance-pool ml.g5.2xlarge \
  --instance-pool ml.g4dn.2xlarge \
  --gpu-layers=-1 \
  --provision-timeout 1200 \
  --name "$SEMIF_ENDPOINT_NAME"
实例池是有序的放置回退选项,而不是推理负载均衡。SageMaker 会为该变体选择一个可用的类型。在 SageMaker AI 逐一尝试实例池期间,终端节点的创建可能需要更长时间。请检查启动日志中选定的 GPU,以及确认所有模型层均已卸载的消息。
- Invoke the SemIf endpoint with the example decision.
该请求为每个允许的选项声明了稳定的 ID:
{
  "decision": {
    "id": "support-route",
    "state": "Customer asks to reset a forgotten password and says the reset email never arrived.",
    "question": "Which queue should handle this request?",
    "options": [
      {"id": "account_access", "description": "Account access and authentication support."},
      {"id": "billing", "description": "Billing and payment support."},
      {"id": "sales", "description": "Sales and product evaluation."}
    ]
  }
}
python deploy/invoke_endpoint.py \ --region "$AWS_REGION" \ --endpoint-name "$SEMIF_ENDPOINT_NAME"响应会保留选项顺序,并包含条件概率、原始 logits、token 和提示元数据,以及固定的模型标识:
{
  "result": {
    "id": "support-route",
    "option_ids": ["account_access", "billing", "sales"],
    "probabilities": [0.99996, 0.00003, 0.00001],
    "option_logits": [28.47, 17.92, 17.04],
    "prompt_sha256": "016267542103ab91422c425d2234ec7e1b9aef77f9d3e481b96db2de7cca470a",
    "readout": "quantized last-position logits restricted to declared answer slots; no generated tokens"
  }
}
请应用应用层级的阈值和回退机制。不要将模型决策用作授权的替代品。
清理
删除 SageMaker AI 终端节点、终端节点配置和模型:
python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$STANDARD_ENDPOINT_NAME"

python deploy/cleanup_endpoint.py \
  --region "$AWS_REGION" \
  --name "$SEMIF_ENDPOINT_NAME"
该脚本只会删除那些显式命名的 SageMaker AI 资源。当你不再需要它们时,请删除 CodeBuild 项目、ECR 存储库、Amazon S3 中的模型和源对象、日志以及专用的 IAM 角色。
结论
适用于 llama.cpp 的 AWS DLC 为您在 SageMaker AI 上的 CPU 和 GPU 实例中服务决策模型提供了托管基础。它可以从 SageMaker AI 模型工件或配置好的 Hugging Face 仓库加载 GGUF 模型,然后通过 InvokeEndpoint 提供 OpenAI 兼容的聊天补全服务,无需自定义容器。当您的应用需要直接访问 logits 和模型状态操作时,可以使用 SemIf 适配器扩展 DLC。对于不敏感于延迟的工作负载请选择 CPU,而当提示词预填充和尾部延迟会影响应用体验时请选择 GPU。
请查看代码示例、适用于 llama.cpp 的 AWS DLC 文档以及 SageMaker AI 自定义推理容器契约,以便为您的 workload 调整部署。
关于作者
来源:AWS Machine Learning Blog · aws.amazon.com