Amazon SageMaker AI 支持 SOCI 索引镜像,训练容器启动从分钟级降到秒级
Announcing SOCI-indexed images for faster SageMaker AI jobs
AWS 为 SageMaker AI 训练和处理任务推出 Seekable OCI(SOCI)索引镜像,通过懒加载只先取启动容器所需文件,其余在后台流式加载。实测 1.8–35.4 GB 镜像的下载从最长 7 分 17 秒降至 3–11 秒(约 8x–46x),GPU 空转时间最多减少 90%,首个 epoch 多花 3–16 秒但整体每任务提前 1–6 分钟完成。
你的深度学习容器镜像每多下载一分钟,就多计费一分钟,也让你的团队多等待一分钟。容器镜像下载是纯粹的开销:只是计费的工作时间,却没有任何模型进展。对于现代深度学习镜像,这项开销在每一个作业上都要耗费好几分钟。今天,我们很高兴地宣布 Amazon SageMaker AI 训练作业和 Amazon SageMaker AI 处理作业支持 Seekable OCI(SOCI)索引,它将完整的容器镜像下载从每个作业的关键路径中移除。
通过 SOCI 索引,SageMaker AI 会对你的容器镜像进行延迟加载。它只获取启动容器所需的文件,并在后台随着代码运行流式加载其余部分,因此你的作业在几秒内即可启动,而不是几分钟。你可以通过指向一个预先建立索引的 AWS Deep Learning Container(DLC),或为自己的镜像添加索引来采用它。这两种方式都不需要更改你的作业定义、入口点或数据通道。其结果是作业启动更快、作业成本更低,并且可以把更多时间用于构建模型,而不是等待基础设施。
使用 SOCI 索引的镜像可以在几秒内启动 Amazon SageMaker AI 训练容器,且对训练性能没有影响。正如我们在 我们测量了什么 一节中所展示的,在我们的基准测试中,这使镜像拉取期间的 GPU 空闲时间最多减少了 90%。
本文介绍如何采用 SOCI 索引:它是什么、我们测得的结果,以及如何在你自己的作业中启用它。
面临的挑战
SageMaker AI 训练作业和处理作业运行在存储于 Amazon Elastic Container Registry(Amazon ECR)中的容器镜像内。在作业执行你的代码之前,该服务会将整个镜像下载到实例,解压并将每个层写入磁盘。
对于小镜像,这只需几秒钟。但深度学习镜像通常超过 10 GB 甚至更大。这次下载会给每个作业增加数分钟,并且作为作业时间由你付费。其影响恰恰在迭代速度最关键的环节最为显著:数百个作业的超参数调优扫描、快速实验以及短时处理作业——在这些场景中,镜像下载可能占据总运行时间的大部分。
SOCI 索引的工作原理
Seekable OCI(SOCI) 是一项对容器镜像进行延迟加载的开源技术。运行时无需在启动前下载整个镜像,而是使用 SOCI 索引只获取立即启动容器所需的文件,然后在后台随着代码访问其余文件而进行流式加载。
SOCI 索引是映射镜像内每个文件的元数据。你将它作为与原始镜像关联的符合 OCI 规范的工件存储在 Amazon ECR 中。由于索引是一个独立的工件,你的镜像摘要和任何现有签名仍然有效。
SageMaker AI 会自动检查索引
当你创建训练作业或处理作业时,SageMaker AI 会检查你指定的镜像是否具有 SOCI 索引,并据此进行相应处理:
| 场景 | 会发生什么 |
| 镜像包含 SOCI 索引 | SageMaker AI 对镜像进行延迟加载,并在完整下载完成之前启动你的容器 |
| 镜像没有 SOCI 索引 | 标准下载,行为无变化 |
| 索引无法读取,或延迟加载未成功 | 作业回退到标准下载并继续运行 |
因为任务在需要时总会回退到标准下载方式,所以添加 SOCI 索引绝不会妨碍你的任务运行。你只会获得更快的启动速度,绝不会冒破坏现有工作流程的风险。
我们的测量方式
我们在真实的 SageMaker AI 训练任务上以两种方式拉取相同的容器镜像:标准下载和基于 SOCI 索引的延迟加载。然后我们用两种方式运行完整的训练任务,以测量对训练速度的影响。
测试环境
- 八张镜像,压缩后 1.8–35.4 GB。
- GPU 和 CPU 实例 ml.g4dn、ml.g5、ml.g6、ml.g6e、ml.g7、ml.g7e、ml.p4d、ml.p5 和 ml.m7i,从 xlarge 到 48xlarge,位于美国西部(俄勒冈)区域(us-west-2)和美国东部(弗吉尼亚北部)区域(us-east-1)。
- 下载时间从开始拉取镜像起测量,直到容器准备就绪可以运行。所有数据均为多次重复运行的中位数。
结果 1:无论镜像大小如何,下载时间都从分钟级降至秒级
| 镜像大小(压缩后) | 标准下载 | 延迟加载 | 提升幅度 |
| 1.8 GB | 48 秒 | 3-11 秒 | 约 8 倍 |
| 13.2 GB | 3 分 42 秒 | 约 6 秒 | 约 34 倍 |
| 35.4 GB | 7 分 17 秒 | 3-11 秒 | 约 38 倍 |
下图对比了从 1.8 GB 到 35.4 GB 的八种镜像大小下,标准 Docker 拉取与 SOCI 延迟加载的容器镜像下载时间。
每种镜像大小显示两根柱条。Docker 下载时间柱条(蓝色)随镜像大小稳步增长,从 1.8 GB 时的 48 秒到 35.4 GB 时的 7 分 17 秒。
每组柱条上方的加速标签显示了 Docker 时间与 SOCI 时间之比。加速比范围从最小镜像的约 10 倍到最大镜像的超过 35 倍。
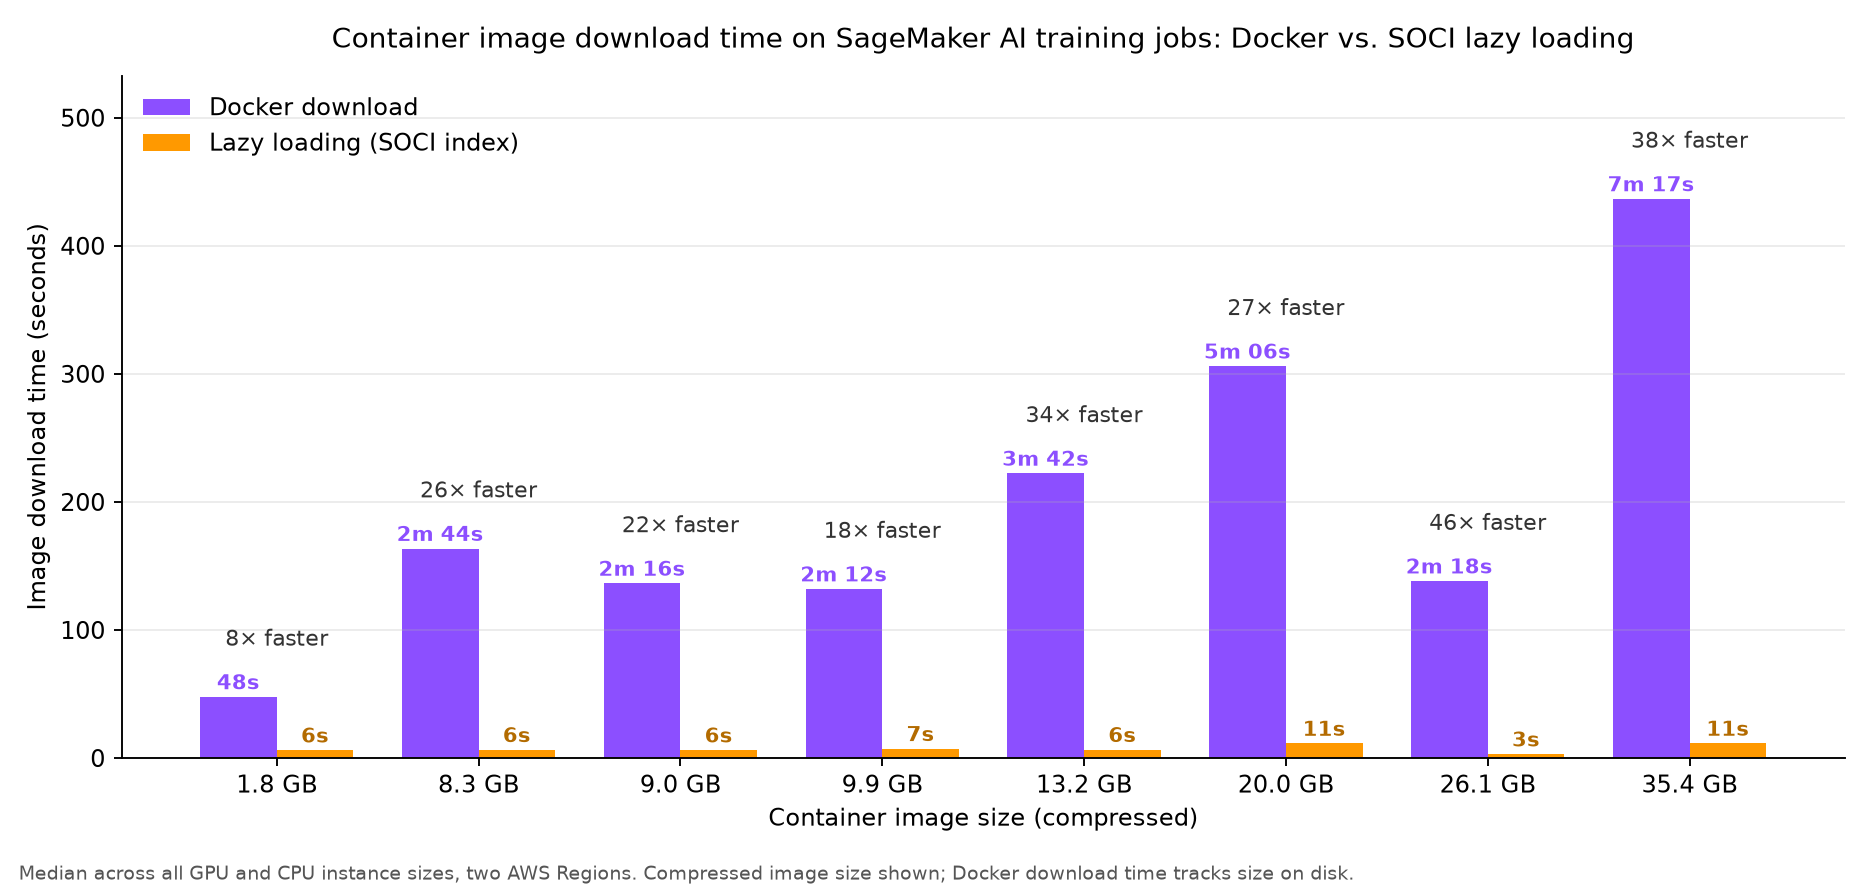
图 1:八种镜像大小下容器镜像下载时间,标准 Docker 拉取与 SOCI 延迟加载的对比
标准下载时间随镜像大小增长,因为每个文件都需要解压并写入。而延迟加载无论大小始终保持在 3–11 秒,提升达 8 至 46 倍。镜像越大,节省的时间越多。
结果 2:在每种实例类型和规格上都能节省时间
在 13 种实例类型/规格组合上运行 13.2 GB 镜像,标准下载时间从 3 分 16 秒到 4 分 20 秒不等,而延迟加载保持在 6-8 秒。这在每种配置上都快了约 34 倍。你无需更改实例类型或规格即可受益。
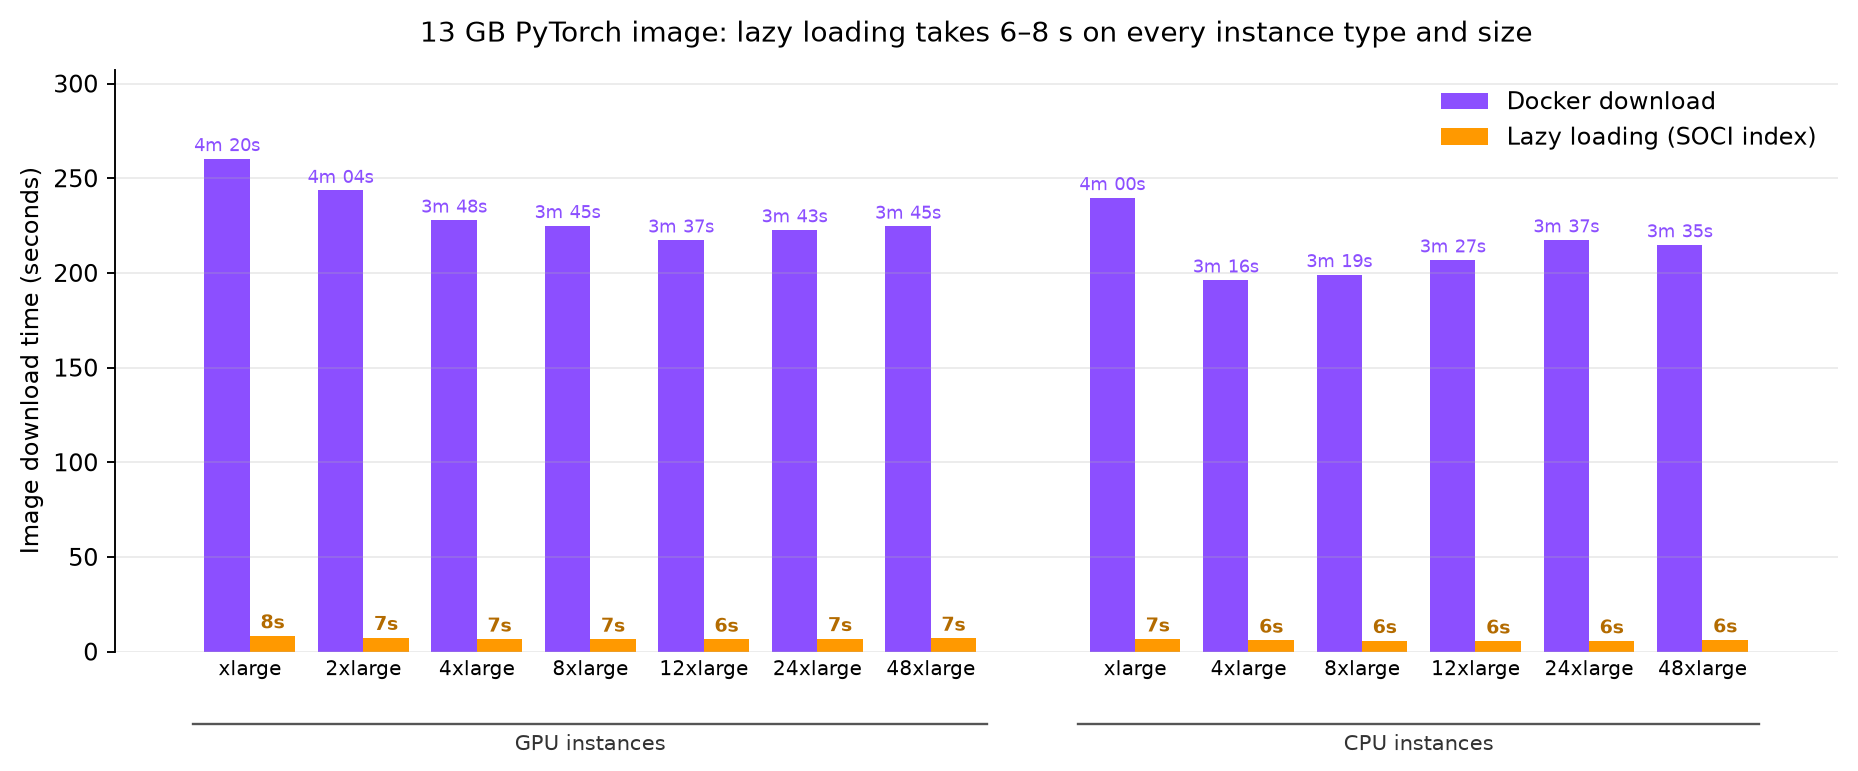
图 2:13.2 GB 镜像在 13 种实例类型和规格组合上的下载时间
结果 3:除首轮(epoch)开销外,训练性能不受影响
我们分别从 Docker 拉取的镜像和基于 SOCI 索引的镜像运行两类完整训练任务,并比较每个 epoch:
- Image classification on ResNet-50 on Imagenette (9,469 images)
- 容器镜像:PyTorch(13.2 GB DLC)和 TensorFlow(9.9 GB DLC)
- 实例:ml.p5.48xlarge、ml.p4d.24xlarge、ml.g7e.48xlarge、ml.g7.48xlarge、ml.g6e.12xlarge、ml.g6e.24xlarge 和 ml.g6e.48xlarge。
- Large language model (LLM) fine-tuning: full-parameter supervised fine-tuning (SFT) of Qwen2.5-0.5B on alpaca-cleaned (51,760 examples) with the Hugging Face Trainer.
- 容器镜像:9.4 GB Hugging Face PyTorch DLC。
- 实例:ml.p5.48xlarge、ml.p4d.24xlarge、ml.g6.48xlarge。
下图将任务启动时间分解为镜像下载时间和首个训练 epoch 时间,对比标准 Docker 拉取与基于 SOCI 索引的镜像在两种工作负载的 GPU 和 CPU 配置下的表现。
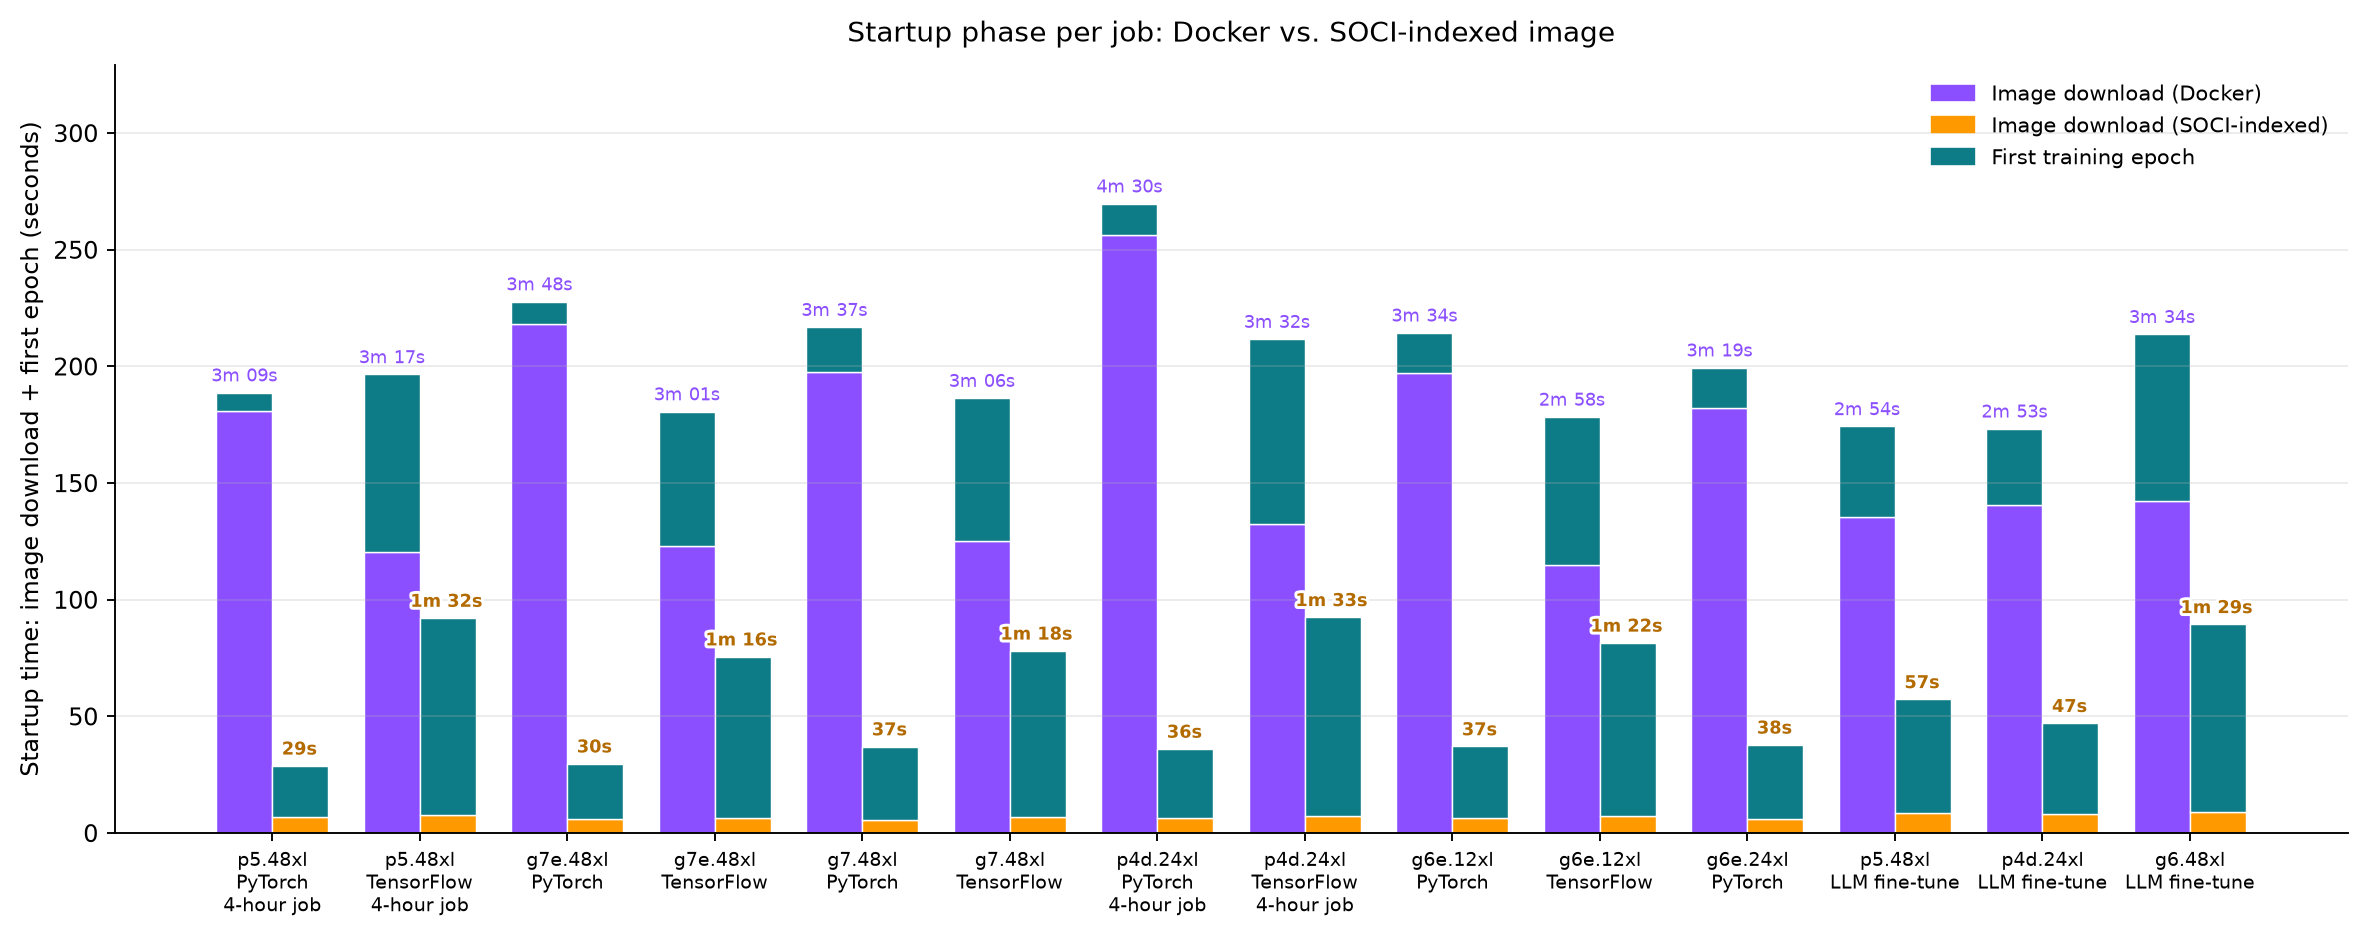
图 3:任务启动时间分解为镜像下载时间和首个训练 epoch 时间,标准 Docker 拉取与基于 SOCI 索引的镜像的对比
- 从第二个 epoch 开始,在每种实例上,两种工作负载的单个 epoch 耗时都相同(在多次运行的波动范围内)。
- 从懒加载镜像启动时,第一个 epoch 会多花 3–16 秒,因为框架首次接触的文件需要即时获取。这个首个 epoch 的开销在每个实例规格上都相同。
- 净效果:每个作业提前 1–6 分钟完成。即下载节省的时间减去一次性的首个 epoch 开销,这是每个作业固定的节省量。
在自己的工作负载上测试
这些数字来自前面描述的两个工作负载。首个 epoch 的开销取决于你的镜像以及代码在启动时会接触哪些内容:
- 当第一个训练步骤只需要镜像的一小部分,其余部分在训练过程中流式传入时,懒加载更划算。
- 如果你的入口点在训练开始前就读取了镜像的大部分内容(例如扫描、校验或预加载其内容),那么首个 epoch 将等待与完整拉取几乎相同的字节数。净改进会很小。
- Front-loaded starts still came out ahead in our tests:
- torch.compile 和一个即时(JIT)构建的 CUDA 扩展给首个 epoch 增加了 7–15 秒(净节省仍为 3 分 25 秒–3 分 56 秒)
- 镜像中内置的 6 GB 模型在加载时流式传输权重,增加了 2–3.5 分钟,但在已建立索引的镜像上,整个作业仍提前 2–2.5 分钟完成。
开始使用
你可以通过两种方式采用 SOCI 索引:使用预建索引的 AWS Deep Learning Container,或为自己的自定义镜像创建索引。
选项 1:使用预建索引的 AWS Deep Learning Container
AWS 为多个流行的 Deep Learning Container 发布了带 SOCI 索引的变体,通过镜像标签上的 -soci 后缀来标识:
763104351884.dkr.ecr.us-east-1.amazonaws.com/pytorch-training:2.9-gpu-py312-cu130-ubuntu22.04-sagemaker-v1-sociPyTorch Training、TensorFlow Training、vLLM 和 SGLang 均提供预建索引的变体,部分框架还包括 arm64 变体。要采用懒加载,只需将作业定义中的镜像标签更新为 -soci 变体。完整列表可在 AWS Deep Learning Containers Gallery 中浏览。
注意: 如果你以 DLC 基础镜像构建自己的镜像,必须为最终镜像创建 SOCI 索引。基础镜像的索引不会继承到派生镜像。
选项 2:为自己的镜像创建 SOCI 索引
要为自定义镜像建立索引,你需要一台 Linux 主机(例如运行 Amazon Linux 2023 的 Amazon Elastic Compute Cloud (Amazon EC2) 实例),并安装 containerd、SOCI snapshotter,以及 Finch 或 nerdctl。
- Set your environment variables.
ACCOUNT_ID="111122223333" REGION="us-east-1" REPOSITORY_NAME="my-training-image" ORIGINAL_IMAGE_TAG="v1.0" SOCI_IMAGE_TAG="v1.0-soci" REGISTRY="$ACCOUNT_ID.dkr.ecr.$REGION.amazonaws.com" - Install the required tools.
sudo dnf install -y containerd fuse soci-snapshotter runfinch-finch sudo systemctl start soci-snapshotter sudo systemctl restart containerd - Authenticate to Amazon ECR.
aws ecr get-login-password --region "$REGION" \ | sudo nerdctl login -u AWS --password-stdin "$REGISTRY" - Pull your original image.
sudo nerdctl pull "$REGISTRY/$REPOSITORY_NAME:$ORIGINAL_IMAGE_TAG" - Create the SOCI-indexed image.
sudo nerdctl image convert --soci \ "$REGISTRY/$REPOSITORY_NAME:$ORIGINAL_IMAGE_TAG" \ "$REGISTRY/$REPOSITORY_NAME:$SOCI_IMAGE_TAG" - Push the indexed image.
sudo nerdctl push --platform linux/amd64 \
  "$REGISTRY/$REPOSITORY_NAME:$SOCI_IMAGE_TAG"
这会在你的仓库中创建两个工件:SOCI 索引,以及一个将镜像与索引关联的符合 OCI 规范的镜像索引清单。你的原始镜像及其摘要保持不变。
在 CI/CD 中自动化索引创建
要在每次推送时自动生成索引,请部署 CFN ECR SOCI Index Builder。它使用 Amazon EventBridge 规则来检测 Amazon ECR 镜像推送事件并构建索引。无需对构建流水线做任何更改。
在 SageMaker AI 作业中使用已建立索引的镜像
引用带 SOCI 索引的镜像的方式与其他镜像完全相同。无需任何 API 更改,只有标签不同。
训练示例(SageMaker Python SDK)
from sagemaker.train import ModelTrainer
from sagemaker.train.configs import Compute

trainer = ModelTrainer(
    training_image="111122223333.dkr.ecr.us-east-1.amazonaws.com/my-training-image:v1.0-soci",
    role="arn:aws:iam::111122223333:role/SageMakerExecutionRole",
    compute=Compute(
        instance_type="ml.g5.12xlarge",
        instance_count=2,
    ),
)

trainer.train()
验证你的镜像包含 SOCI 索引
启动之前,确认你的标签解析到一个已建立索引的镜像:
aws ecr batch-get-image \
  --repository-name "$REPOSITORY_NAME" \
  --image-ids imageTag="$SOCI_IMAGE_TAG" \
  --accepted-media-types \
  "application/vnd.oci.image.index.v1+json" \
  --query 'images[0].imageManifest' --output text \
  | jq '.manifests[] | {mediaType, artifactType}'
在你的平台清单旁边,查找 artifactType 以 application/vnd.amazon.soci.index. 开头的子清单。如果不存在,则该标签并未指向已建立索引的镜像。
注意事项
- 仅适用于 Amazon ECR 私有存储库。来自其他镜像仓库的镜像,或通过私有 Docker 仓库拉取的镜像(TrainingRepositoryAccessMode 设置为 Vpc),不符合延迟加载的条件。
- 提升效果随镜像大小而变化。小于约 4 GB 的镜像提升相对较小。
- 检查是否存在依赖 Docker 的假设。带有 SOCI 索引的镜像运行在基于 containerd 的运行时上。请检查入口点和设置脚本中是否有调用 Docker CLI、读取 /var/run/docker.sock 或从 cgroup 路径派生标识符的代码。SageMaker AI 为向后兼容挂载了一个 /.dockerenv 标记文件,但请避免新增对它的依赖。
- SOCI 索引功能已在所有 AWS 区域适用于 SageMaker AI 作业。
结论
借助 SOCI 索引,你可以最大限度地缩短 SageMaker AI 训练和处理作业的容器镜像下载时间。为你的镜像添加 SOCI 索引,或切换到已预建索引的 AWS Deep Learning Container。无论哪种方式,你都能将启动时间从几分钟缩短到几秒,降低作业总成本,并加快机器学习(ML)迭代周期。而且你现有的作业定义、API 调用和数据管道完全无需改变。
要了解关于 Amazon SageMaker AI 的更多信息并开始使用 SOCI 索引,请探索以下资源:
- 选择带有 SOCI 索引的 Deep Learning Container。浏览 Deep Learning Containers Gallery,并在你的镜像标签后追加 -soci。有关特定框架的指南,请参阅 SOCI index for AWS Deep Learning Containers。
- 为你自己的自定义镜像建立索引。按照 SageMaker AI Developer Guide 中的分步演练操作,或参阅 SOCI snapshotter getting-started guide 了解高级选项。
- 在 CI/CD 管道中自动建立索引。部署 CFN ECR SOCI Index Builder,在每次推送镜像时自动生成索引。无需对管道进行任何更改。
- 使用 Finch 在本地测试。在提交作业之前,使用 Finch lazy-loading walkthrough 在基于 containerd 的运行时上验证你的镜像。
- 深入了解这项技术。阅读 AWS Machine Learning Blog 上的 Reducing container cold start times using SOCI index on DLAMI and DLC 查看基准测试,或在 AWS Containers Blog 上探索 Under the hood: Lazy loading container images with Seekable OCI and AWS Fargate,详细了解延迟加载机制。
更快的容器启动只需一个镜像标签的距离。在你的下一个 SageMaker AI 作业中试用一下,看看效果如何。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com