AWS 在 vLLM 中实现双向 KV 缓存传输,多轮智能体工作负载 TTFT 最多降低 3.3x
Improve TTFT for multi-turn agentic workloads with bi-directional KV transfer in vLLM
AWS 在 vLLM 中引入双向 KV 缓存传输,让 P-D 分离部署中的 prefill 节点可复用 decode 节点保留的 KV 块,减少多轮对话中的重复预填充计算。
多轮智能体(agentic)工作负载会在智能体进行推理、调用工具并整合先前结果的过程中不断积累上下文。每开始新的一轮,客户端都会重新发送完整的对话历史,包括系统指令、之前的提示词、工具结果和模型响应,导致不断增长的上下文被反复处理。在Prefill-decode(P-D)分离架构中,每个请求会被拆分到专用节点上处理:prefill 节点处理提示词并构建其键值(KV)缓存,然后 decode 节点检索这些 KV 块并生成响应。
然而,传统的分离式服务只在单一方向传输 KV 缓存:从 prefill 节点到 decode 节点。这种单向流动给多轮工作负载带来了两个低效问题。首先,在生成响应后,decode 节点会同时保留提示词和新生成 token 的 KV 缓存条目。在处理下一轮时,prefill 节点无法检索这些条目,因此必须为之前的响应 token 重新计算 KV 投影。其次,decode 节点维护着会话状态,而 prefill 节点不维护,这增加了 prefill 节点上活跃会话的缓存被逐出的概率。一旦缓存完全未命中,prefill 节点必须为整个对话历史重新计算 KV 投影,包括系统指令、之前的用户请求、工具结果和模型生成的响应。随着对话不断增长,这些冗余工作会消耗更多的加速器容量,并增加首 token 生成时间(TTFT)。
在构建对话助手和智能体应用时,更长的交互历史会增加延迟,并通过重复的 prefill 计算消耗加速器容量。在这篇文章中,我们将展示双向 KV 缓存传输如何让 prefill 和 decode 节点跨轮次复用先前计算的上下文,从而提高加速器利用率,并帮助应用在对话不断增长时保持响应迅速的 TTFT。
在使用 Amazon Elastic Compute Cloud(Amazon EC2)P5en 实例的 1P1D 部署上进行的多轮基准测试中,双向 KV 传输将 Qwen3-32B 的 TTFT 降低了最多 1.6 倍,将 zai-org/GLM-5-FP8 的 TTFT 降低了最多 3.3 倍(参见性能数据部分)。结果因工作负载和配置而异。这些实例通过 AWS Elastic Fabric Adapter(AWS EFA)互连,这是 AWS 中跨服务器使用的低延迟远程直接内存访问(RDMA)网络。在支持的实例类型上,AWS EFA 支持 GPUDirect RDMA 和 Neuron Direct RDMA,可以直接在 prefill 和 decode 节点上的 GPU 或 AWS Trainium 设备内存之间移动 KV 块。
我们最初在通过 EFA 互连的 AWS Trainium 实例集群上构建并验证了该功能,并将其贡献给 vLLM 作为一项与加速器无关的能力。本文展示的结果来自配备 EFA 的 Amazon EC2 P5en GPU 集群,表明这些优势同样适用于 GPU。本文将介绍双向 KV 传输架构、路由器元数据流、KV 块保留与重计算控制、性能结果,以及如何复现该基准测试。
双向 KV 传输
双向 KV 传输是一种机制:在对话的后续轮次中,解码节点将先前计算好的 KV 返回给预填充节点。这避免了在预填充节点上重新计算共享上下文,并由可配置的 KV 重算阈值控制。它缓解了前文所述的两种计算冗余场景。要使其工作,KV 必须在产生它的那一轮之后仍然存活,并沿相反方向传输,由具备 KV 缓存感知能力的路由器协调。
面向双向传输的 NIXL KV 连接器增强
我们扩展了 NVIDIA Inference Xfer Library (NIXL) 的 KV 连接器,让预填充节点能够消费远程 KV 块,类似于解码节点已经消费预填充节点提供的 KV 块的方式。这并非一项简单的改动,因为这两种节点类型在架构上有所不同:预填充节点为新提示词 token 计算 KV 表示,并能提供完整的提示词 KV 块。解码节点缺乏(或不具备高效地)生成完整 KV 表示的能力,只能提供先前缓存的 KV 块。因此,预填充节点和解码节点仍然各自保留着自己计算远程和本地 KV 块元数据的角色与逻辑。不过,实际的 KV 传输机制(NIXL READ)在 P->D 和 D->P 两个方向上是共通的。
下图首先以蓝色显示了现有流程。路由器将请求发送到预填充节点,预填充节点计算提示词 KV 并返回其块元数据,然后路由器将请求和元数据转发给解码节点,以进行标准的 P→D NIXL READ。编号的红色路径展示了双向 KV 传输的新增内容:(1) 解码节点在生成后保留符合条件的 KV 块,(2) 在流式响应中返回它们的元数据,(3) 路由器缓存该元数据以用于下一次预填充请求。然后预填充节点 (4) 在应用本地缓存匹配后检查远程可复用的 KV,(5) 当可复用 token 数量达到阈值时排入异步接收队列,(6) 在计算剩余后缀之前执行 D→P NIXL READ。
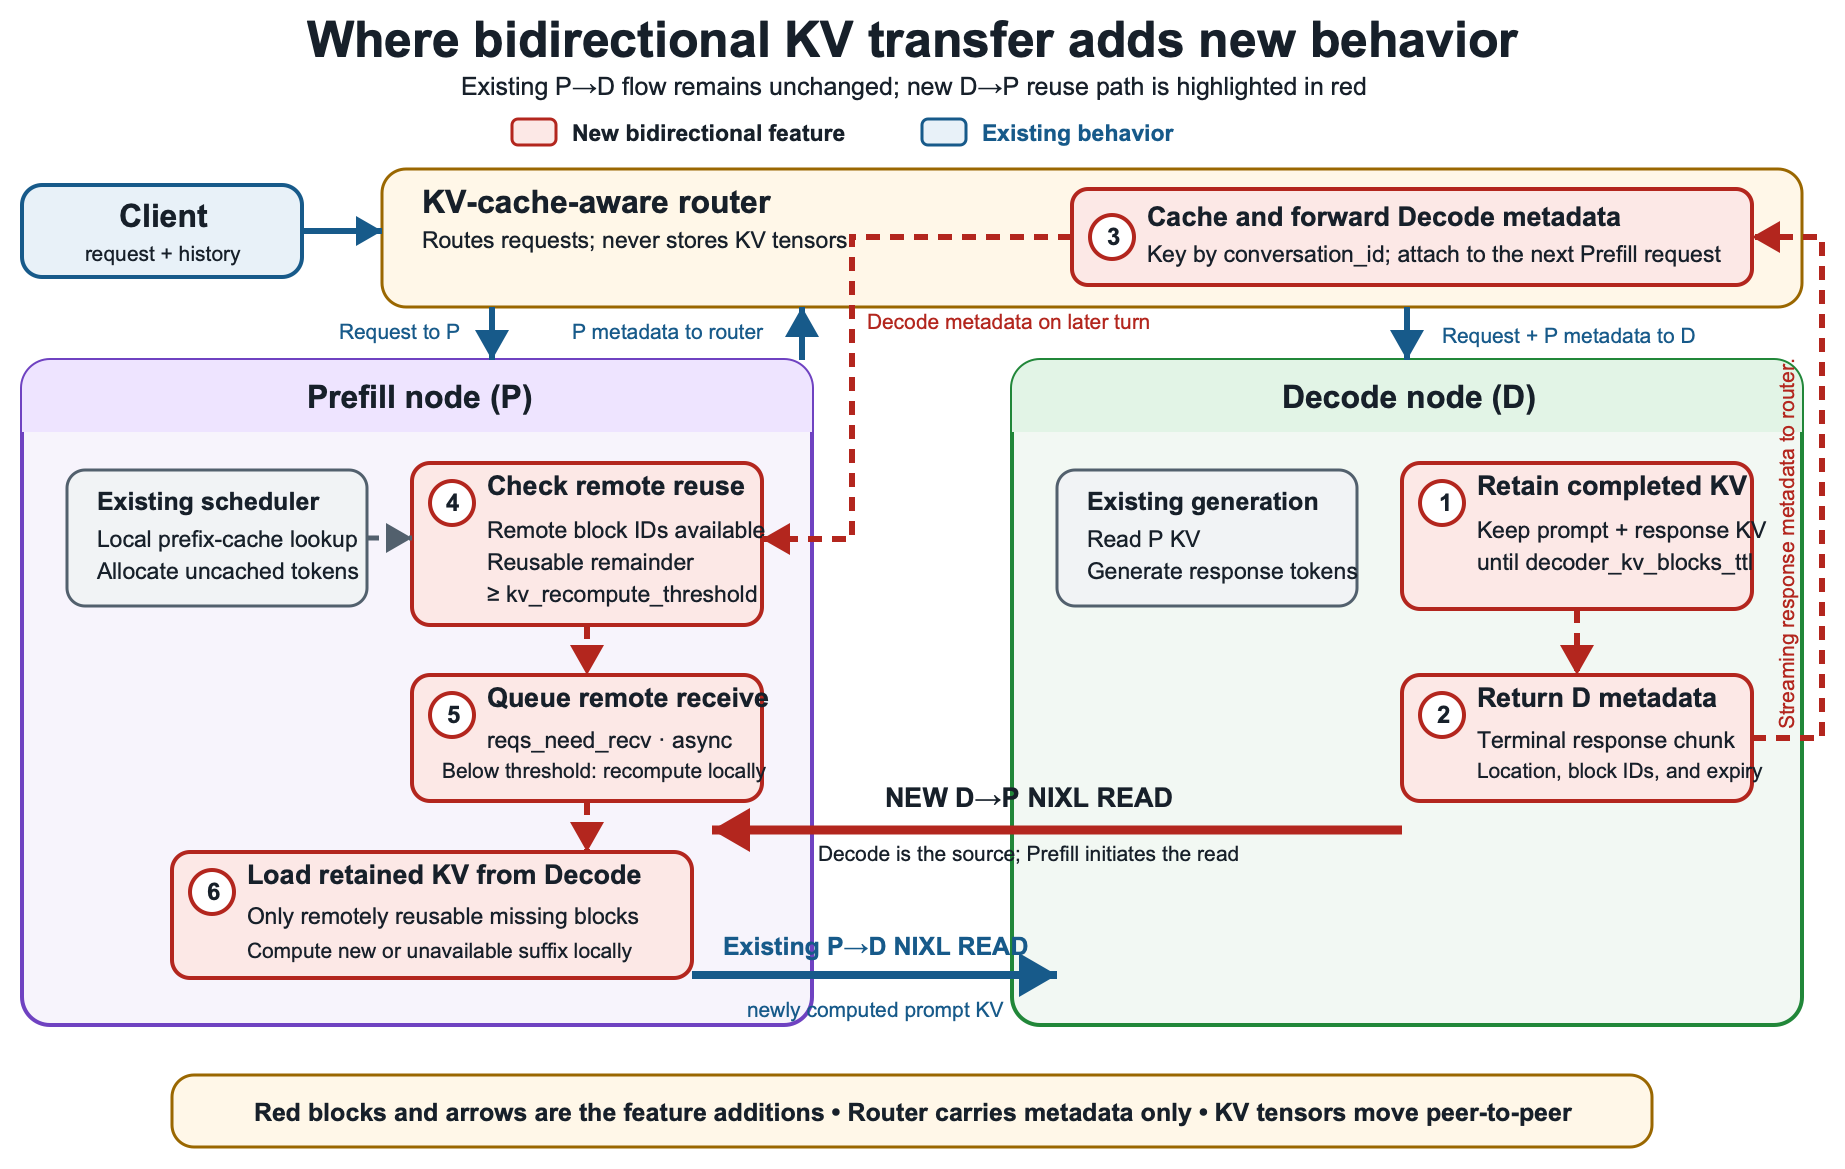
图 1:标准的预填充到解码流程(蓝色)以及双向 KV 传输的新增内容(红色)
KV 缓存感知路由器
vLLM 在连接器侧提供了对双向 KV 传输的支持,而跨对话轮次协调 KV 复用则需要一个具备 KV 缓存感知能力的路由器。vLLM GitHub 提供了一个实现本文所述流程的代理示例,可以将其适配到你的环境中。
KV 缓存感知路由器是一个轻量级、有状态的控制面组件,位于客户端、预填充节点和解码节点之间。它维护一个从客户端提供的 conversation_id 到解码节点的 kv_transfer_params 的内存映射。路由器只存储块位置元数据,而不存储 KV 张量,并从响应流中获取该元数据,而不是单独查询解码节点。
下图展示了路由器如何跨对话轮次管理 KV 元数据。在第一轮,缓存查找未命中,请求遵循标准的 P→D 流程。随后路由器从响应流中保存解码节点的元数据。在后续轮次中,路由器使用 conversation_id 检索该元数据,使预填充节点能够复用解码节点的 KV。然后它在生成之后刷新元数据,以备下一轮使用。
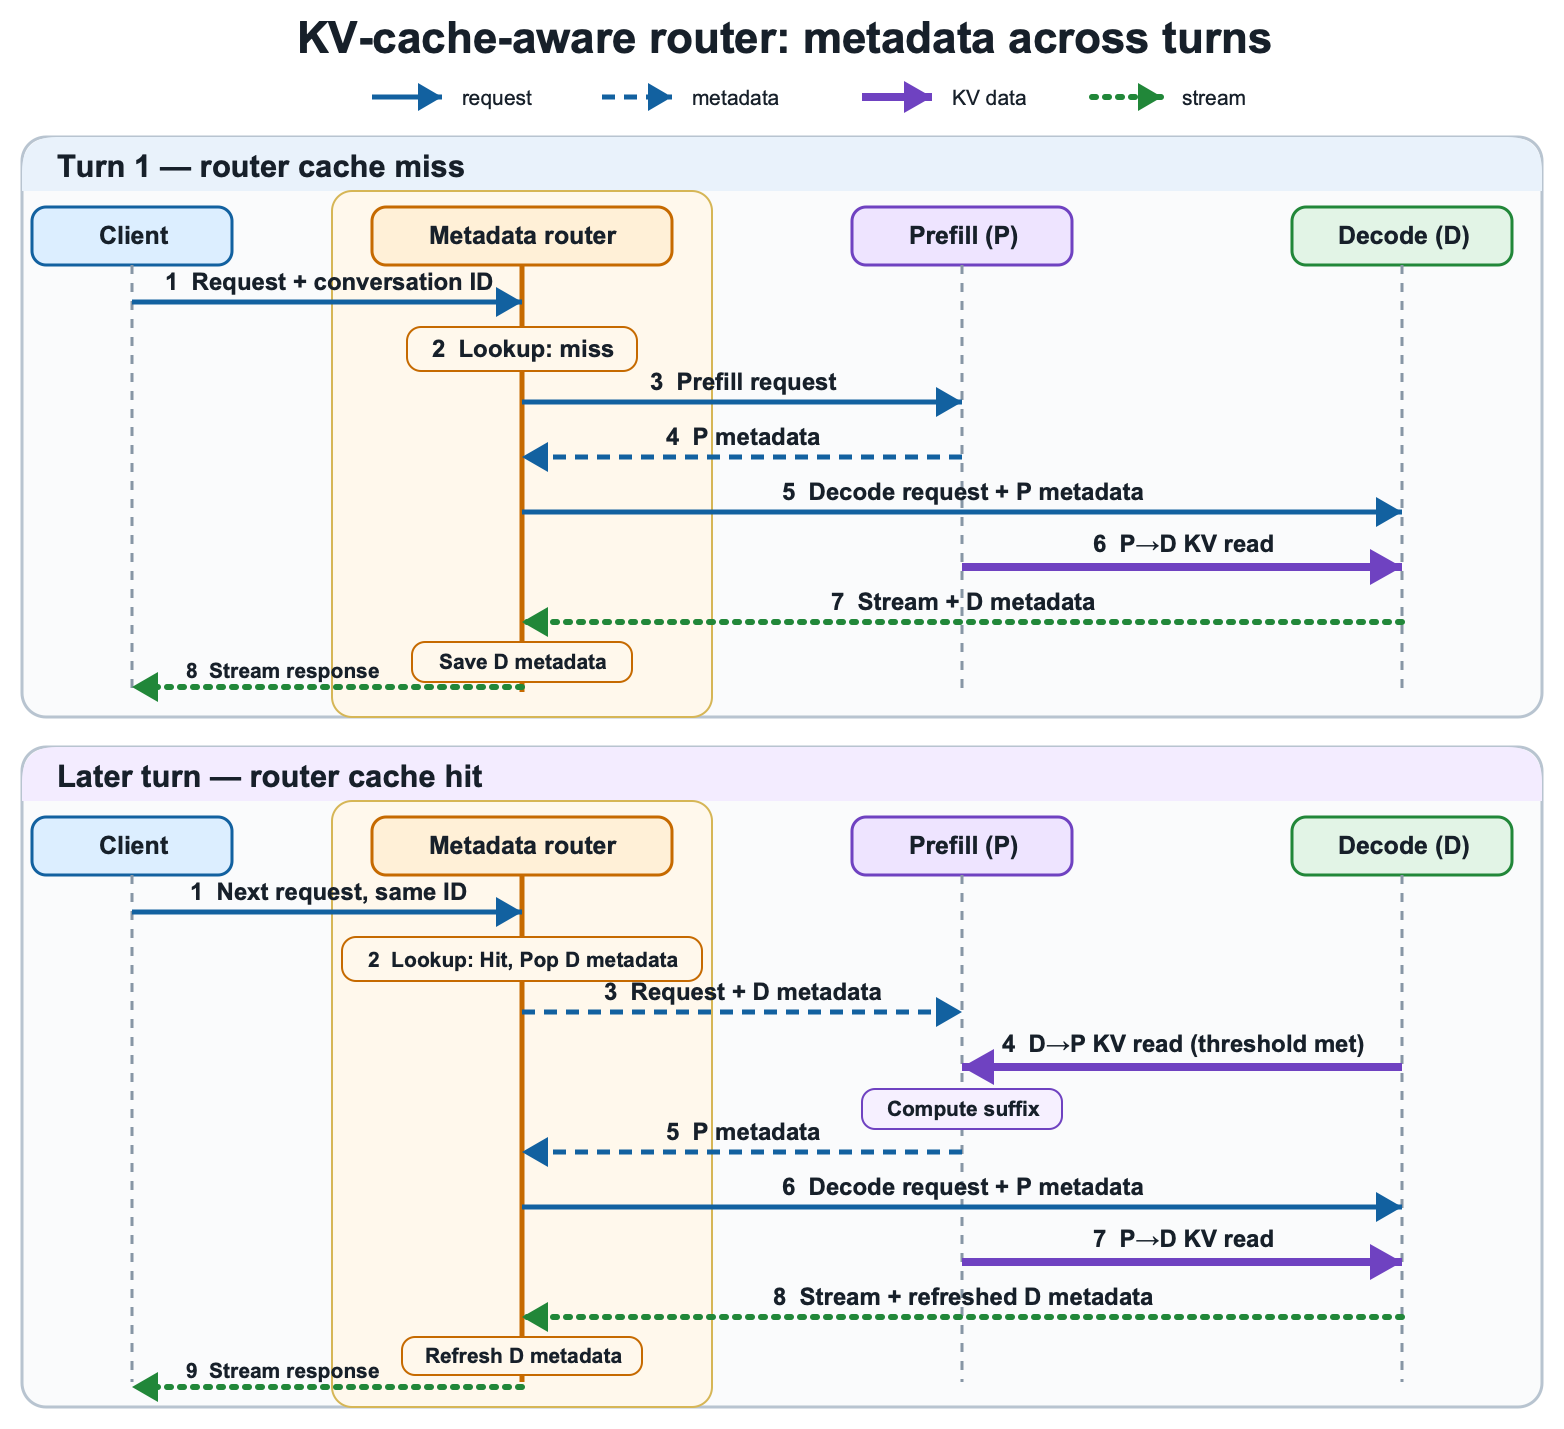
图 2:KV 缓存感知路由器跨对话轮次的元数据流
块保留 TTL
通常情况下,decode 实例会在生成完成后立即释放请求的块。在双向 KV 传输模式下,它会在一段可配置的生命周期内(decoder_kv_blocks_ttl,默认 480 秒)保留这些块,并发布它们的位置和过期时间。这样,会话的 KV——包括提示词前缀和生成的响应——在下一轮对话时仍然可用。对于在生存时间(TTL)到期之前到达的一轮对话,prefill 节点会复用 KV;而更晚到达的则会回退到普通的 prefill。由于这个 TTL 是固定的且不会续期,请根据预期的对话轮次间隔来调整它,以在 KV 复用与加速器内存占用之间取得平衡。一个自然的后续改进是将基于心跳续期的租约扩展到 decode 侧。这样,decode 实例就可以在会话进入空闲状态时立即回收块,而不是等到固定计时器结束。
KV 重算阈值
KV 复用并不总是比本地重算更快。对于较短的可复用前缀,互连和协调开销可能超过重新计算这些 token 所需的时间。kv_recompute_threshold 设置(默认 64 个 token)用于控制这一决策。当待计算的 token 数低于阈值时,prefill 节点会进行重算;当达到或超过阈值时,则从 decode 节点拉取 KV。部署时可以根据模型计算时间、KV 大小和互连性能来调整这个值。
性能数据
在评估中,我们在 1P1D 部署上使用 Qwen3-32B 和 GLM-5-FP8 模型,采用通过 EFA 互连的 Amazon EC2 P5en 实例。为了模拟 prefill 节点已驱逐其本地缓存、或路由器选择了另一个没有该会话 KV 块的 prefill 节点的场景,我们通过 --no-enable-prefix-caching 禁用了 prefill 节点上的前缀缓存。
在这两个模型上,开启双向 KV 传输都能减少多轮对话中的 prefill 计算,而且收益通常随提示词长度增长而增大。在功能关闭时,prefill 实例每一轮都要重新计算整个增长后的上下文,因此 TTFT 陡峭上升:Qwen3-32B 从 2k 时的 158 毫秒攀升到 24k 时的 778 毫秒,GLM-5-FP8 从 2k 时的 500 毫秒攀升到 20k 时的 2,334 毫秒。开启该功能后,decode 实例保留的 KV 会被复用而不是重算,使 TTFT 曲线平缓得多:Qwen3-32B 在相同范围内仅从 122 毫秒上升到 460 毫秒(在最长提示词下约降低 1.6 倍),而 GLM-5-FP8 从 358 毫秒上升到 702 毫秒,在长提示词下比重算路径最多低 3.3 倍。prefill 时长的分解说明了原因。
双向传输会增加少量 KV 传输时间(Qwen3-32B 约为 30 毫秒到 130 毫秒;GLM-5-FP8 约为 29 毫秒到 110 毫秒),但它省去的 prefill 计算远超这些 KV 传输时间。因此,开启传输后的总 prefill 时长(Qwen3-32B:128 毫秒到 414 毫秒;GLM-5-FP8:316 毫秒到 541 毫秒)始终远低于仅重算路径(Qwen3-32B:153 毫秒到 744 毫秒;GLM-5-FP8:500 毫秒到 2,331 毫秒)。更大的 GLM-5-FP8 模型表现出更大的绝对和相对差距,因为其更高的单 token 重算时间使 KV 复用在模型和上下文规模扩大时的收益更加显著。
Qwen3-32B
下图绘制了 Qwen3-32B 的 TTFT 随提示词长度变化的曲线,对比开启与关闭双向 KV 传输的情况。
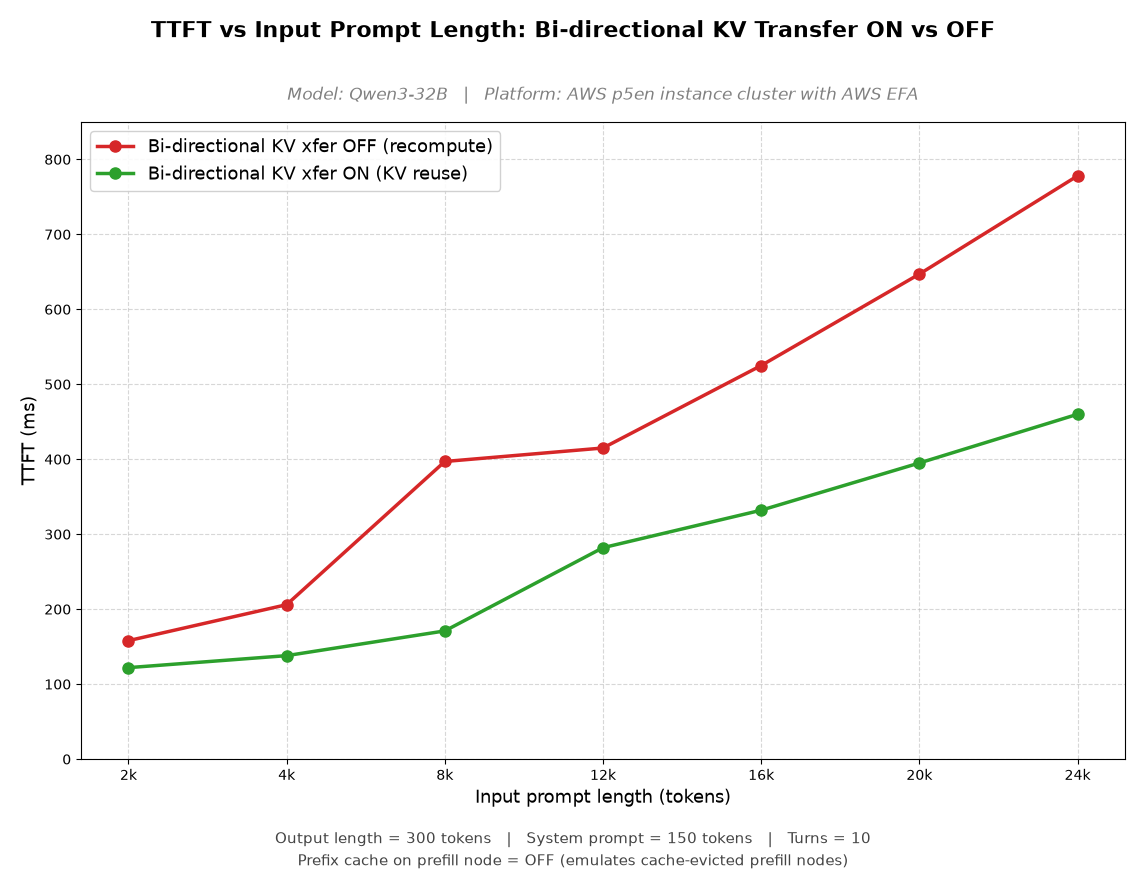
图 3:开启与关闭双向 KV 传输时 Qwen3-32B 的 TTFT 与提示词长度的关系
下一张图表将相同运行的 prefill 时长分解为重算和 KV 传输两个部分。
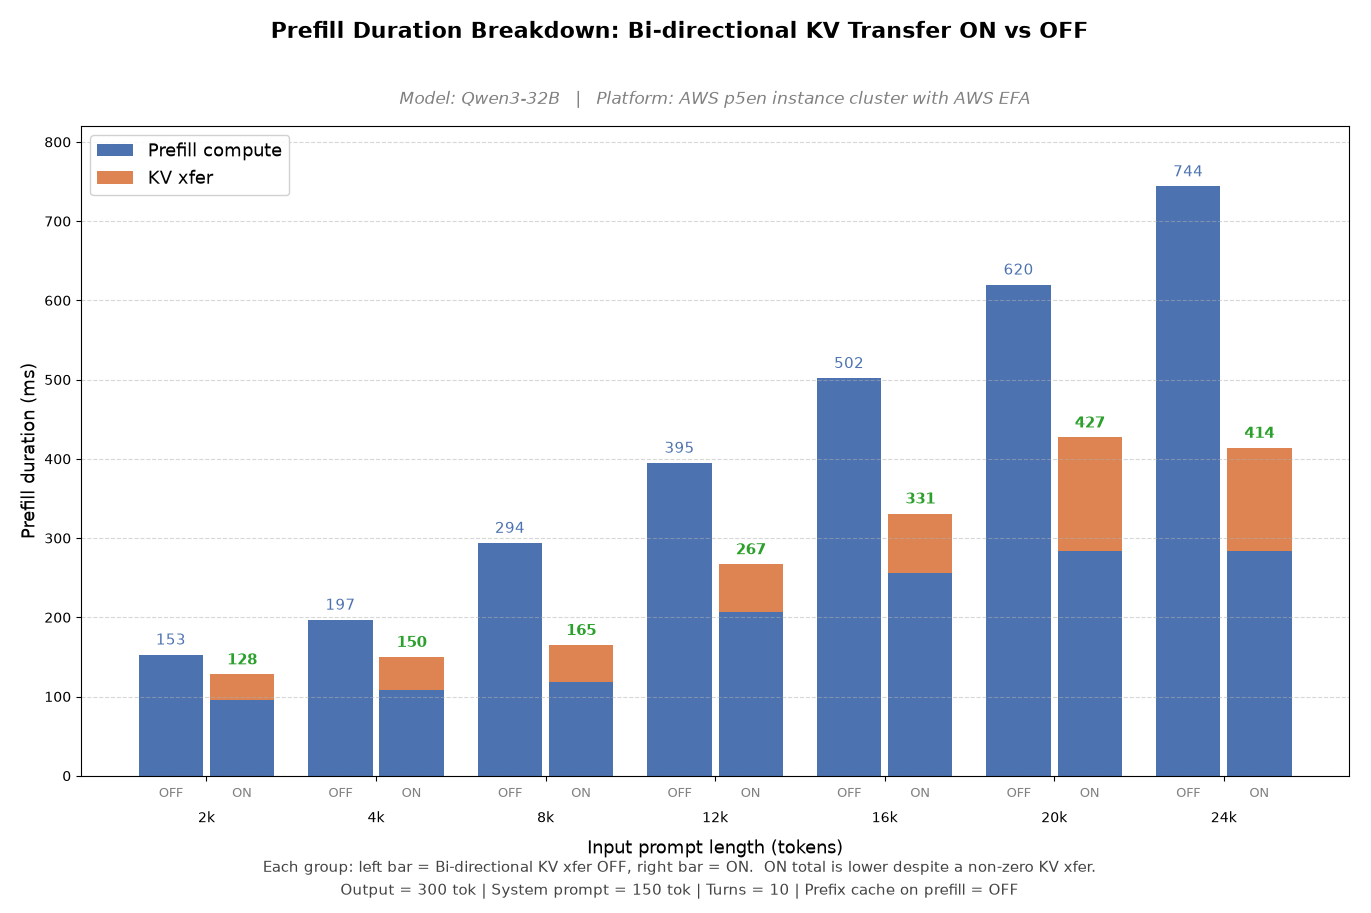
图 4:Qwen3-32B 的 prefill 时长分解为重算和 KV 传输两个部分
综合来看,这些图表显示:开启该功能时 TTFT 几乎保持平稳,而关闭路径则随着上下文增长陡峭攀升,因为少量的 KV 传输时间远小于它所省去的重新计算量。
zai-org/GLM-5-FP8
下图展示的是 GLM-5-FP8 的同样两组视图。第一张图绘制了开启与关闭该功能时 TTFT 随提示长度的变化。
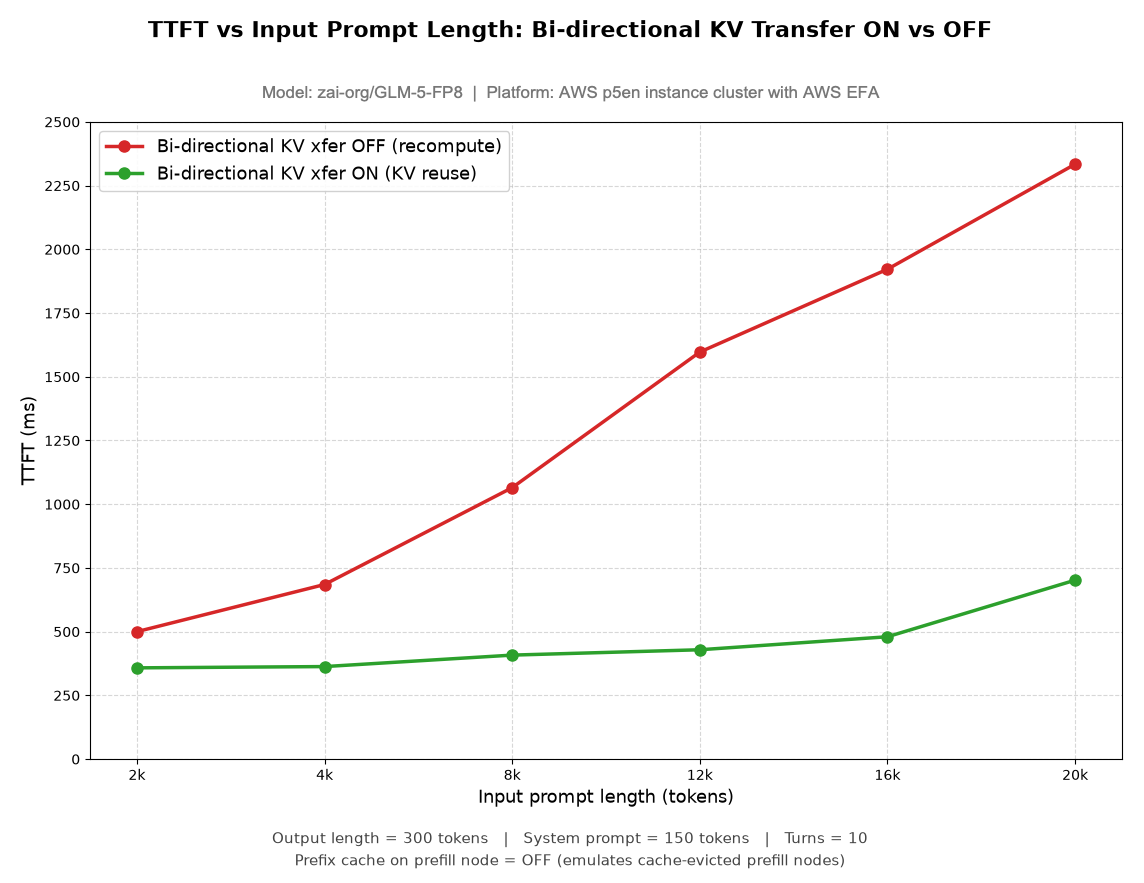
图 5:zai-org/GLM-5-FP8 在开启与关闭 KV 复用时的 TTFT
第二张图将预填充耗时拆分为重新计算和 KV 传输两个部分。
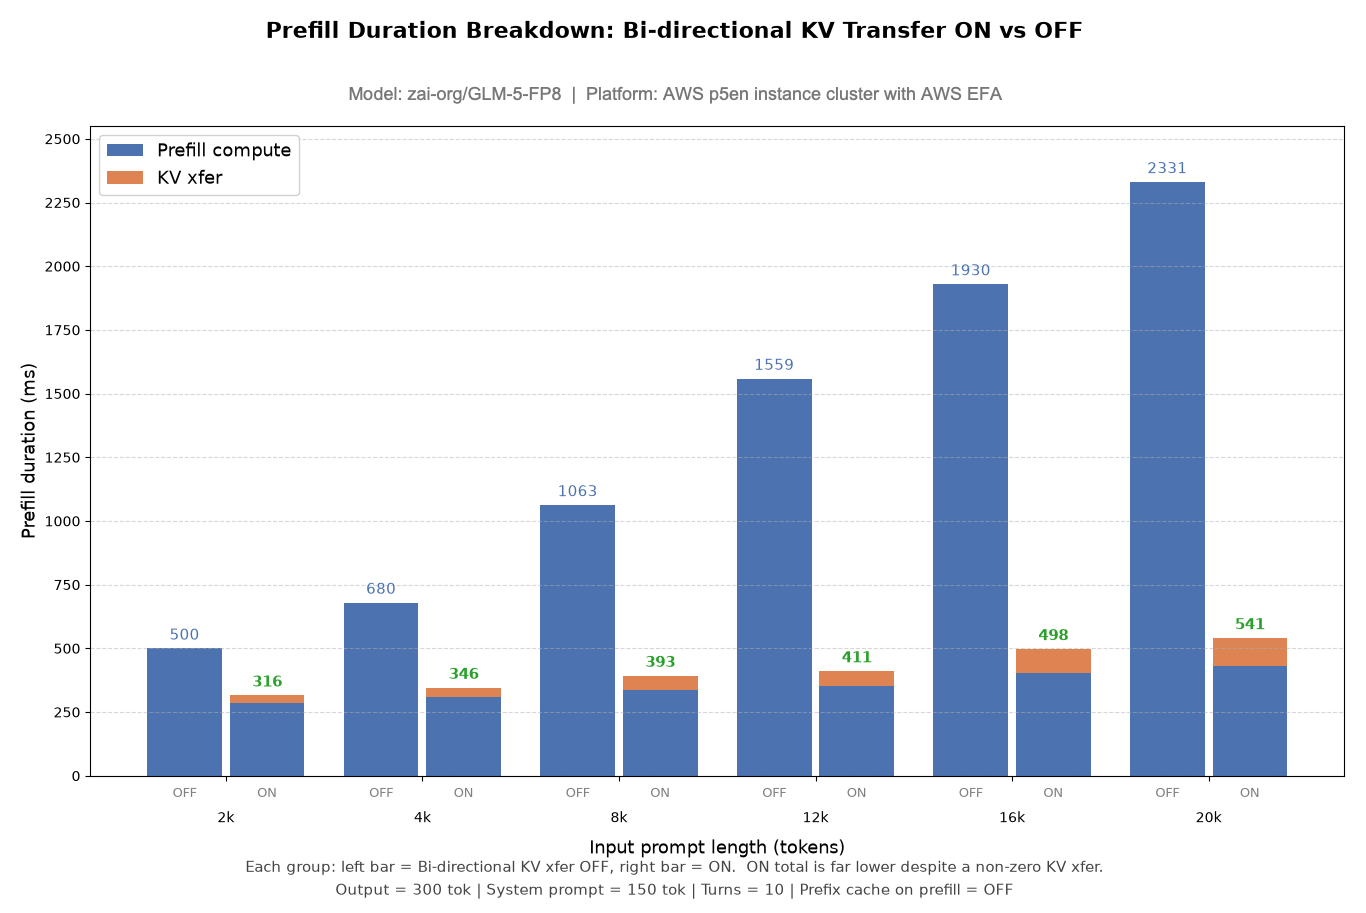
图 6:zai-org/GLM-5-FP8 预填充耗时分解
GLM-5-FP8 的差距比 Qwen3-32B 大得多,在长提示下 TTFT 最多可降低约 3.3 倍,因为其更高的每 token 重新计算时间使得 KV 复用随着上下文长度增长而收益更大。
如何运行基准测试
要使用带 EFA 的 Amazon EC2 P5en 实例重现我们的 1P1D 基准测试配置(一个预填充节点和一个解码节点),请按照 Reproducing our results guide 中的分步说明操作。该指南涵盖环境搭建、启动 vLLM 预填充和解码服务器、运行基准测试以及收集结果。该功能也可以在其他受支持的配置上运行,但性能结果会因硬件、模型、工作负载和网络配置而异。
结论
在这篇文章中,我们展示了双向 KV 缓存传输如何在智能体的对话历史增长时降低 TTFT。在 P-D 分离部署中,该功能让预填充节点跨轮次复用解码节点保留的 KV 块,从而减少重复计算。可配置的块保留和重新计算阈值决定了何时进行复用。在使用通过 EFA 连接的 Amazon EC2 P5en 实例的 1P1D 部署中,在所测试的最长提示长度下,我们观察到 Qwen3-32B 的 TTFT 降低 1.6 倍,zai-org/GLM-5-FP8 降低 3.3 倍。结果取决于工作负载和部署配置。要在你的环境中实现这一功能,请使用 vLLM v0.21.0 或更高版本并配合 NixlConnector,在预填充和解码服务器上都启用 bidirectional_kv_xfer,使用感知 KV 缓存的路由器,并遵循 GitHub reproduction guide。
致谢
我们感谢 vLLM 社区在维护此功能方面提供的支持。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com