如何在 Amazon Bedrock AgentCore Evaluations 中使用决策模型
Use decision models with Amazon Bedrock AgentCore Evaluations
Amazon Bedrock AgentCore Evaluations 支持通过 code-based evaluator 接入决策模型,为智能体评估提供可校准的概率输出。
在评估智能体时,你提出的有些问题范围狭窄且可重复。这个回复是否符合政策?这个工具调用是否安全到可以批准?这个答案是否与检索到的上下文相符?决策模型恰好回答这类问题。它们接收一个结构化状态和一组固定的允许答案,并返回这些答案上的校准概率,而不是那种每次运行置信度都在漂移的自由格式文本。这使得它们非常适合智能体评估中的打分环节——在那里你想要一个可以设阈值并值得信赖的标签和数字。
Amazon Bedrock AgentCore Evaluations 是 Amazon Bedrock AgentCore 的一项功能,可在智能体的整个生命周期内对其进行评分:开发期间按需评分、对存储的会话进行批量评分,以及针对生产流量进行在线评分。除了 15 个内置评估器之外,AgentCore Evaluations 还支持自定义评估器,你可以将其定义为 LLM-as-a-judge 或基于代码的评估器。自定义 LLM-as-a-judge 评估器使用 Amazon Bedrock 中的模型应用你的指令和评分标准。基于代码的评估器在 AWS Lambda 函数中运行你自己的逻辑,该逻辑可以调用你选择的外部系统、模型或 API,包括决策模型。
决策模型适合那些答案集合固定、有见识的人一眼就能判断的问题,例如智能体是否拒绝了某个请求,或者某个回复是否切题。在你自己的流量上验证过某个问题之后,决策模型对于该决策或评分可能就足够了,你还可以将同样的方法扩展到你政策中特定的有害性或刻板印象类别。由于两种后端都可以在单个请求中对同一状态回答多个问题,你可以将它们用作筛选层而非替代品:在各项指标上运行通过/失败信号,以选出需要内置评估器进行更深入评估的轮次,这些评估器的解释能帮助你调查问题出在哪里。
本文展示如何通过基于代码的评估器将两个决策模型后端接入 AgentCore Evaluations。第一个是 Jev,这是 TypeSafe 托管的决策模型。第二个是 Strands Decider 2B,这是一个你可以自行运行的开源决策模型。读完本文,你将了解如何把 AgentCore 评估器的输入转换为决策模型请求,以及如何把模型的概率转换回 AgentCore 评估结果。不过首先,什么时候应该使用自定义 LLM-as-a-judge 评估器,什么时候决策模型更合适?下一节将剖析什么是决策模型以及其中的权衡。
决策模型
决策模型是一种小型专用模型,经过训练可以从一组固定的选项中进行选择并返回校准的置信度分数,而不是生成自由格式的文本。通用大语言模型(LLM)评估器会输出一个带有理由的分数,而决策模型则输出预定义答案上的概率分布。这为你提供了一个可以直接设阈值、聚合并以编程方式处理的置信度度量。这使得决策模型非常适合那些判断可以表述为在一组固定选项中做选择的评估任务:“这个回复是否有依据?”或“智能体是否完成了用户的目标?”
当你不仅需要一个二元判断,还需要一个校准良好的置信度分数与标签一同输出时,决策模型最有用。当你希望一致地执行特定的评分规则(rubric),而不依赖通用 LLM 来解读它时,决策模型也是合适的选择。
TypeSafe 托管的决策模型 Jev 和 Strands Agents 团队推出的开源 20 亿参数决策模型 Strands Decider 都支持三种类型的问题。noul 问题提出一个是/否问题,并返回一个介于 0(否)和 1(是)之间的概率。choice 问题询问最多 255 个选项中哪个适用,返回可能性最高的选项、完整的分布以及置信度。score 问题询问 2 到 10 个有序等级中哪个适用,返回一个按概率加权的分数、各等级的分布以及置信度。许多评估规则都符合这些类型之一。“回复中的每条事实是否都得到了工具结果的支持?”是一个是/否问题,而“按照四级评分规则,这条回复的帮助程度如何?”是一个评分问题。
决策模型与 LLM 即评审者(LLM-as-a-judge)的对比
AgentCore 目前的内置评估器使用通用 LLM 根据评分规则评估智能体响应并解释其判断。当评估需要关联证据、识别缺失信息,或深入分析响应——也就是解释与分数同样有用的场景——这种方式非常有价值。决策模型并非 LLM 评估器的替代品,而是基于代码的评估器框架使之成为可能的一种补充。请将它们用于范围狭窄、定义明确的检查,与内置评估器更广泛的评估配合使用。
解决方案概述
为了展示这些评估器类型如何协同工作,本文构建了一个端到端的 HR 助手智能体示例,它由确定性的基于代码的检查、内置的 LLM 即评审者评估器,以及由 Jev 或 Strands Decider 2B 支持的决策模型评估器进行评估。
该智能体使用 Strands Agents 构建,并部署到 AgentCore runtime(Amazon Bedrock AgentCore 的一项功能)上。它使用五个返回固定模拟数据的工具来回答员工的问题,这些数据包括带薪休假(PTO)余额、PTO 申请、HR 政策、福利和工资单。我们在这个代码示例中使用固定数据,以便直观地验证 LLM 即评审者和决策模型的评估器行为。当你还拥有真实标注(ground truth)时,就能确认每个评估器是否捕获了正确的失败。这个代码示例可帮助你搭建一个框架,针对自己的用例测试决策模型与 LLM 即评审者的对比效果。
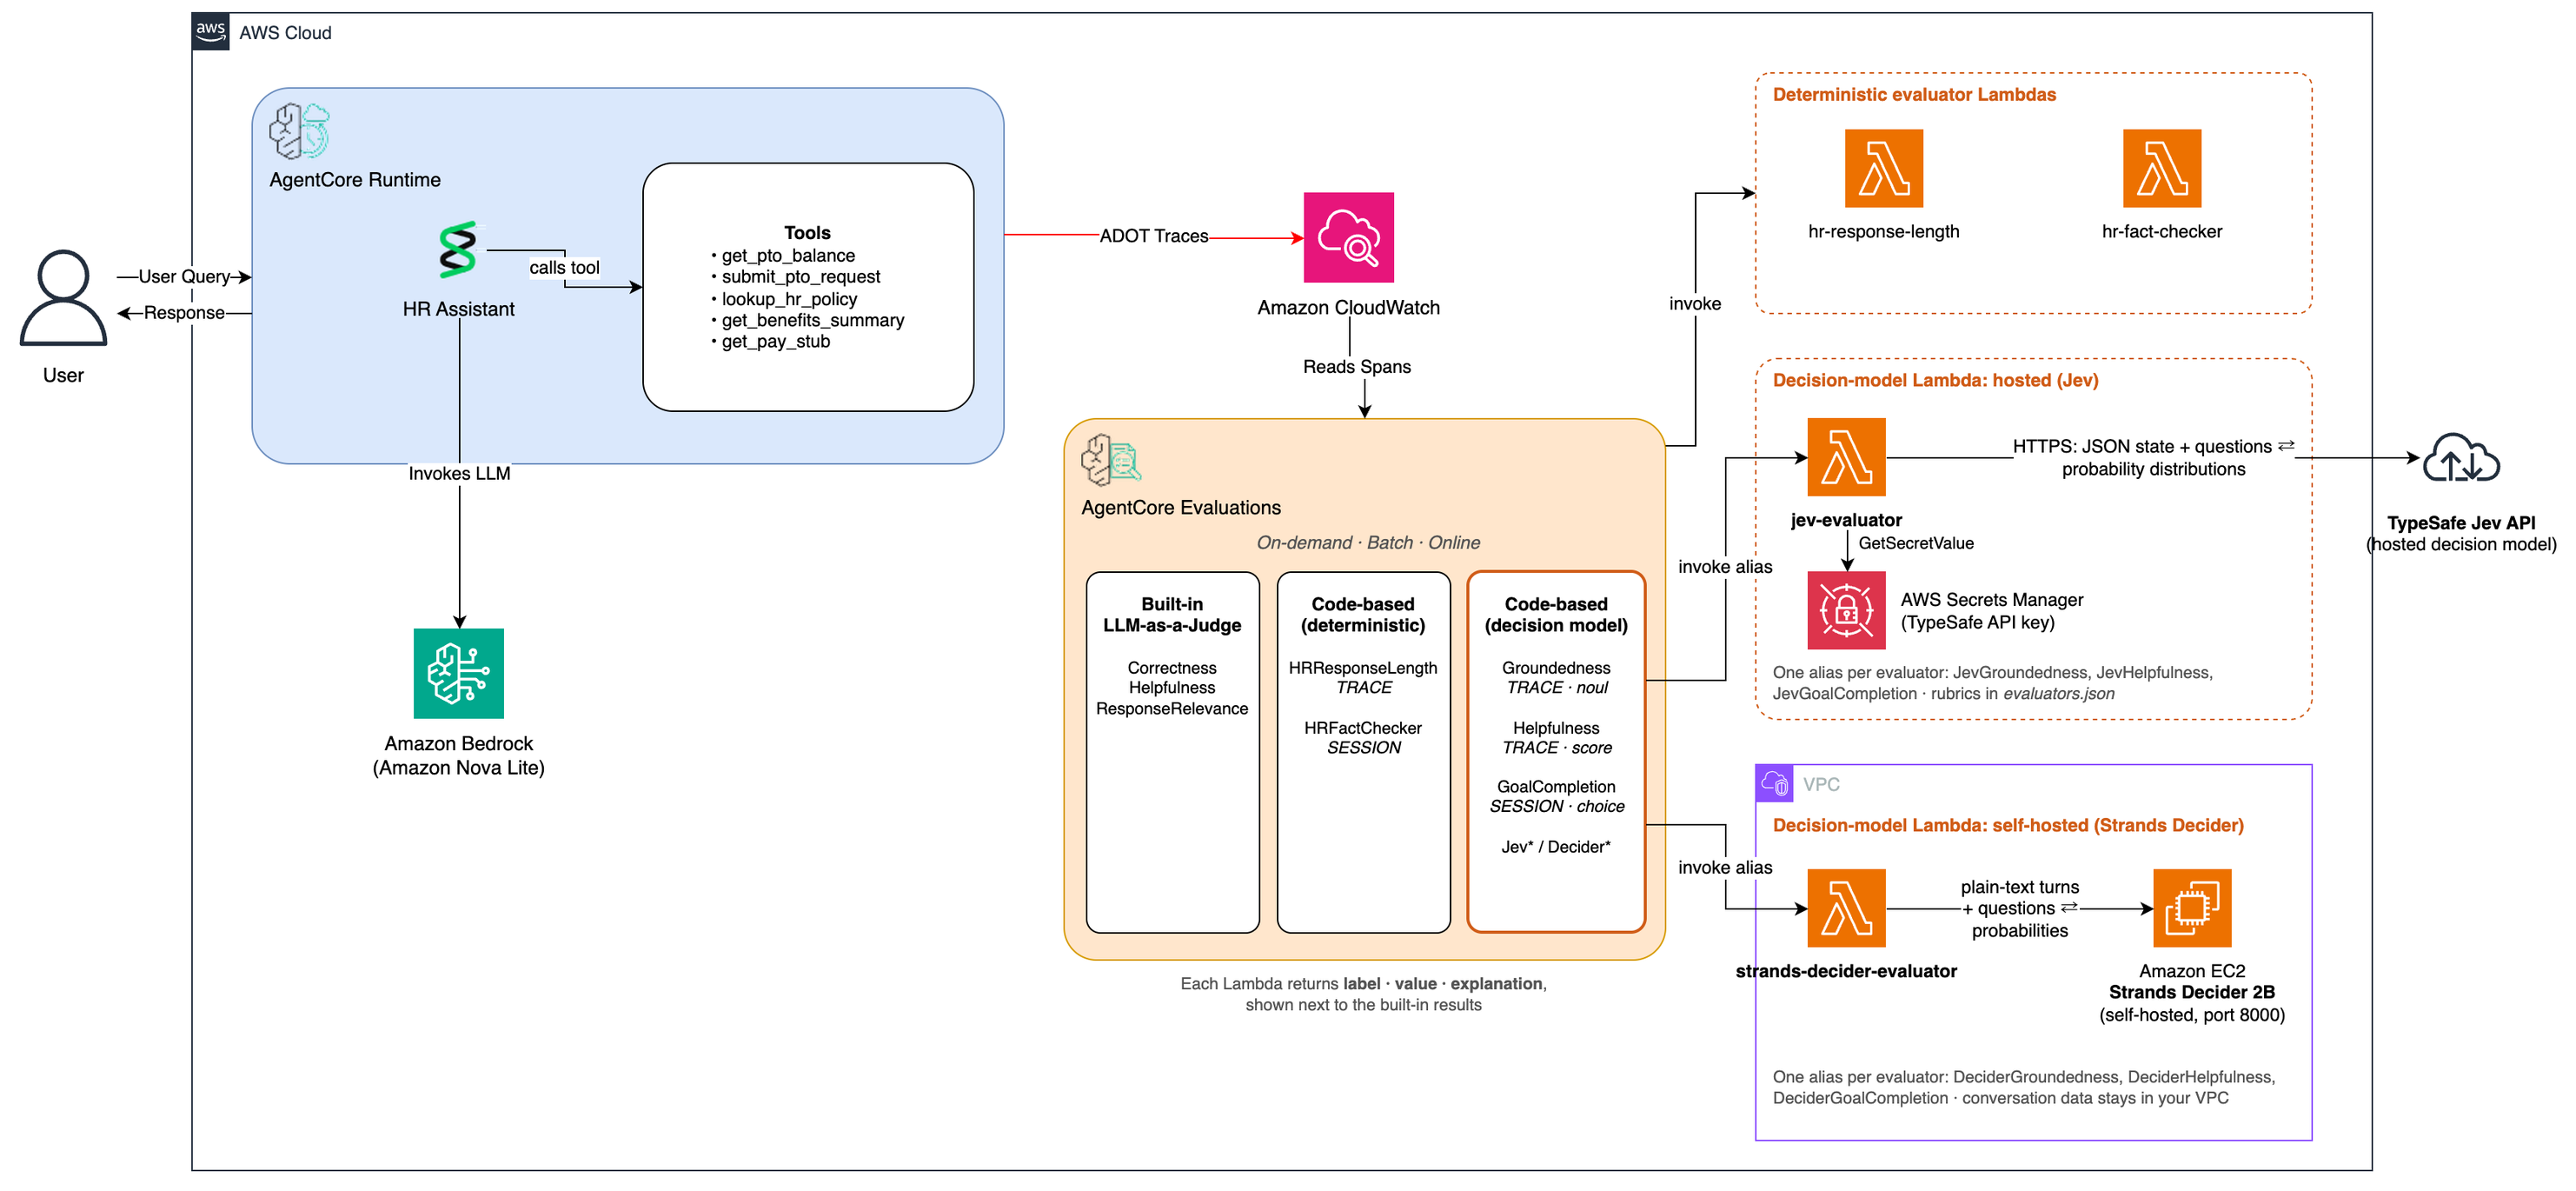
图 1:由基于代码的检查、内置评估器,以及由 Jev 或 Strands Decider 支持的决策模型评估器进行评估的 HR 助手端到端架构
前提条件
要部署该示例,你需要满足以下条件:
- 一个位于 AgentCore Evaluations 可用区域的 AWS 账户。该示例默认使用美国西部(俄勒冈)区域。
- 账户中已启用Amazon CloudWatch Transaction Search。
- 拥有Amazon Bedrock 中某个基础模型的访问权限。
- Python 3.12 或更高版本、AWS 命令行界面(AWS CLI)以及 Docker。
- Jev 需要 TypeSafe API 密钥。访问详情请查看 typesafe.ai。
- Strands Decider 需要一台运行 Strands Decider 服务器的主机。测试时可以在本地运行,也可以在虚拟私有云(VPC)内的 Amazon Elastic Compute Cloud(Amazon EC2)上运行,以便 Lambda 函数能够访问它。
实际操作演示
您可以在 AgentCore samples GitHub 仓库中找到完整的代码示例。两个 Python 脚本处理所有事情:
../utils/deploy.py将 HR Assistant 部署到 AgentCore runtime。evaluate.py部署评估器、调用智能体,并运行评估模式。
不带任何标志运行 evaluate.py 会执行五个步骤:
- 创建 Lambda 执行角色(
AgentCoreLambdaEvaluatorRole)。 - 打包并部署两个确定性 Lambda 评估器:
hr-response-length(一个轨迹级评估器,检查智能体的响应是否保持在长度边界内)和hr-fact-checker(一个会话级评估器,使用正则表达式对照已知的模拟数据校验 HR 事实)。 - 通过控制平面将两者注册为 AgentCore 基于代码的评估器。
- 使用
EvaluationClient和OnDemandEvaluationDatasetRunner在五个带标签的场景中运行按需评估,将基于代码的评估器与Builtin.Correctness、Builtin.Helpfulness和Builtin.ResponseRelevance结合起来。 - 创建一个在线评估配置,以 100% 的采样率对实时会话持续打分。
至此,您已经拥有一个包含确定性检查和 LLM-as-a-judge 打分的可用评估流水线。决策模型评估器是可选的。您可以通过标志添加它们,它们会与基础评估器一起运行,而无需对现有流程做任何更改。使用标志 --with-jev --jev-secret-arn <ARN> 会部署 jev-evaluator 并注册三个评估器:JevGroundedness、JevHelpfulness 和 JevGoalCompletion。使用标志 --with-decider 会部署 strands-decider-evaluator 并注册同样由 Strands Decider 2B 支持的三个评估器。添加 --decider-ec2 可自动预置 Amazon EC2 实例、安全组、IAM 角色和 Lambda VPC 配置,无需手动执行控制台操作。
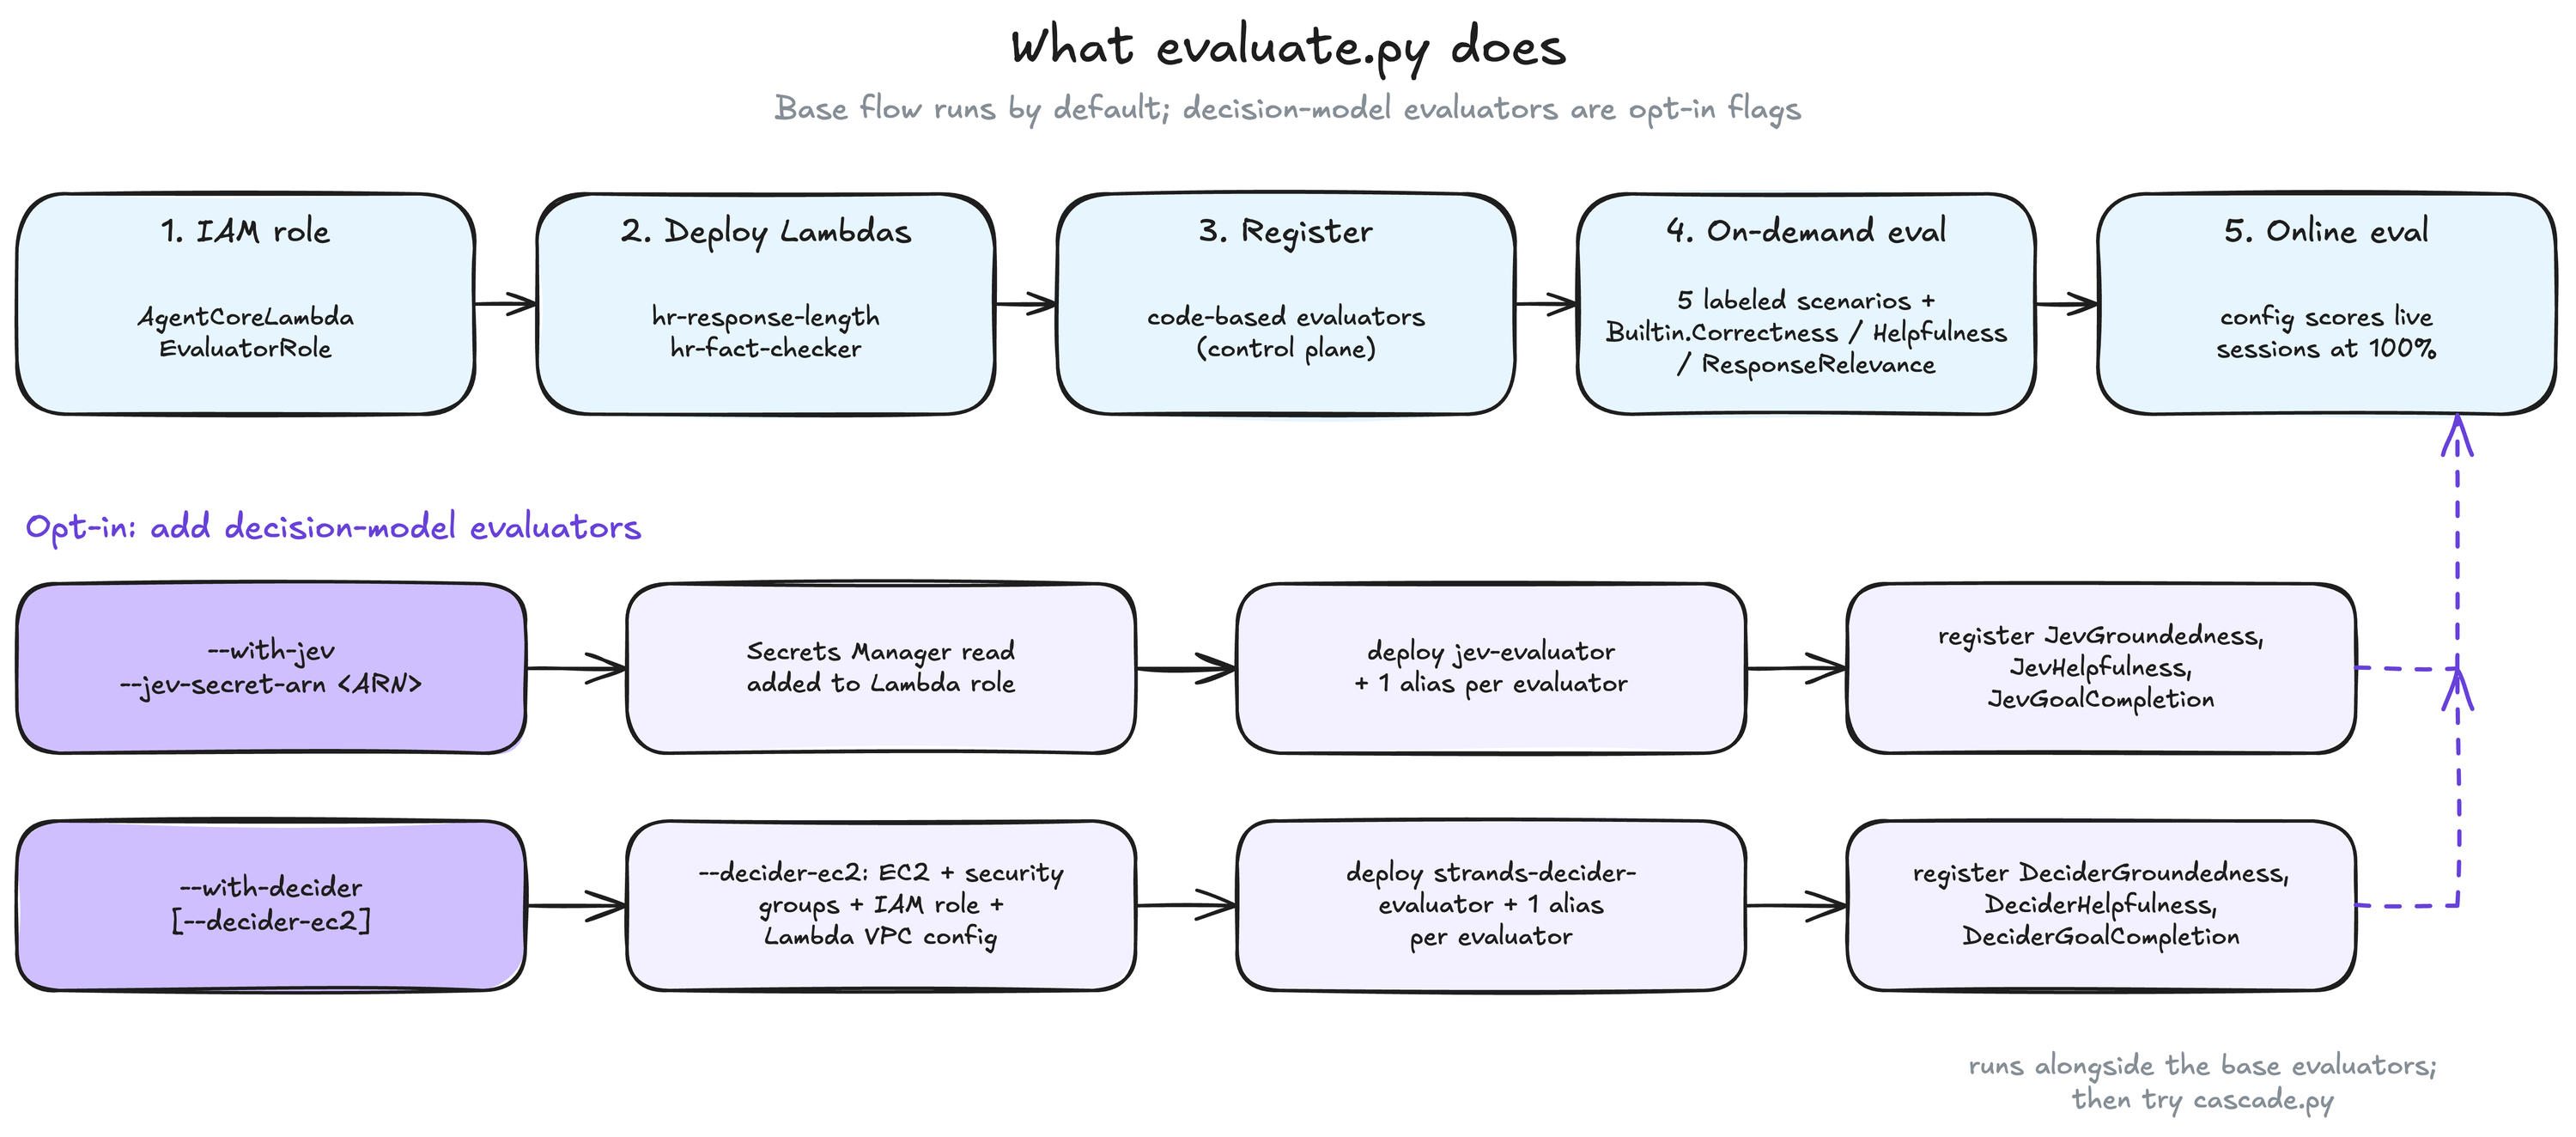
图 2:evaluate.py 部署的评估流水线,从确定性检查到内置评估器和决策模型评估器
每个决策模型后端提供三个评估器:
| 评估器 | 级别 | 问题类型 | 标签 | 值 |
| JevGroundedness / DeciderGroundedness | TRACE | noul |
Grounded 或 Ungrounded | P(grounded) |
| JevHelpfulness / DeciderHelpfulness | TRACE | score(4 级) |
最可能的级别 | 预期级别,缩放至 0–1 |
| JevGoalCompletion / DeciderGoalCompletion | SESSION | choice(三选一) |
最可能的选项 | 概率加权值 |
使用决策模型构建评估器
使用标志 --with-jev 和 --with-decider 会创建一个自定义的基于代码的评估器,您可以完全控制想要作为评估器运行的代码。我们创建 AWS Lambda 函数,在其中调用决策模型并返回标签或数值。该 Lambda 函数会被注册为 AgentCore Evaluations 中的基于代码的评估器。
注册为评估器的 Lambda 会接收智能体的 OpenTelemetry span。spans.py 模块会对 OpenTelemetry 内容可能出现的各种形态进行规范化,然后适当地格式化以调用决策模型。对于轨迹级评估,只发送目标轮次和简短的历史记录;而对于会话级评估,则包含完整对话。
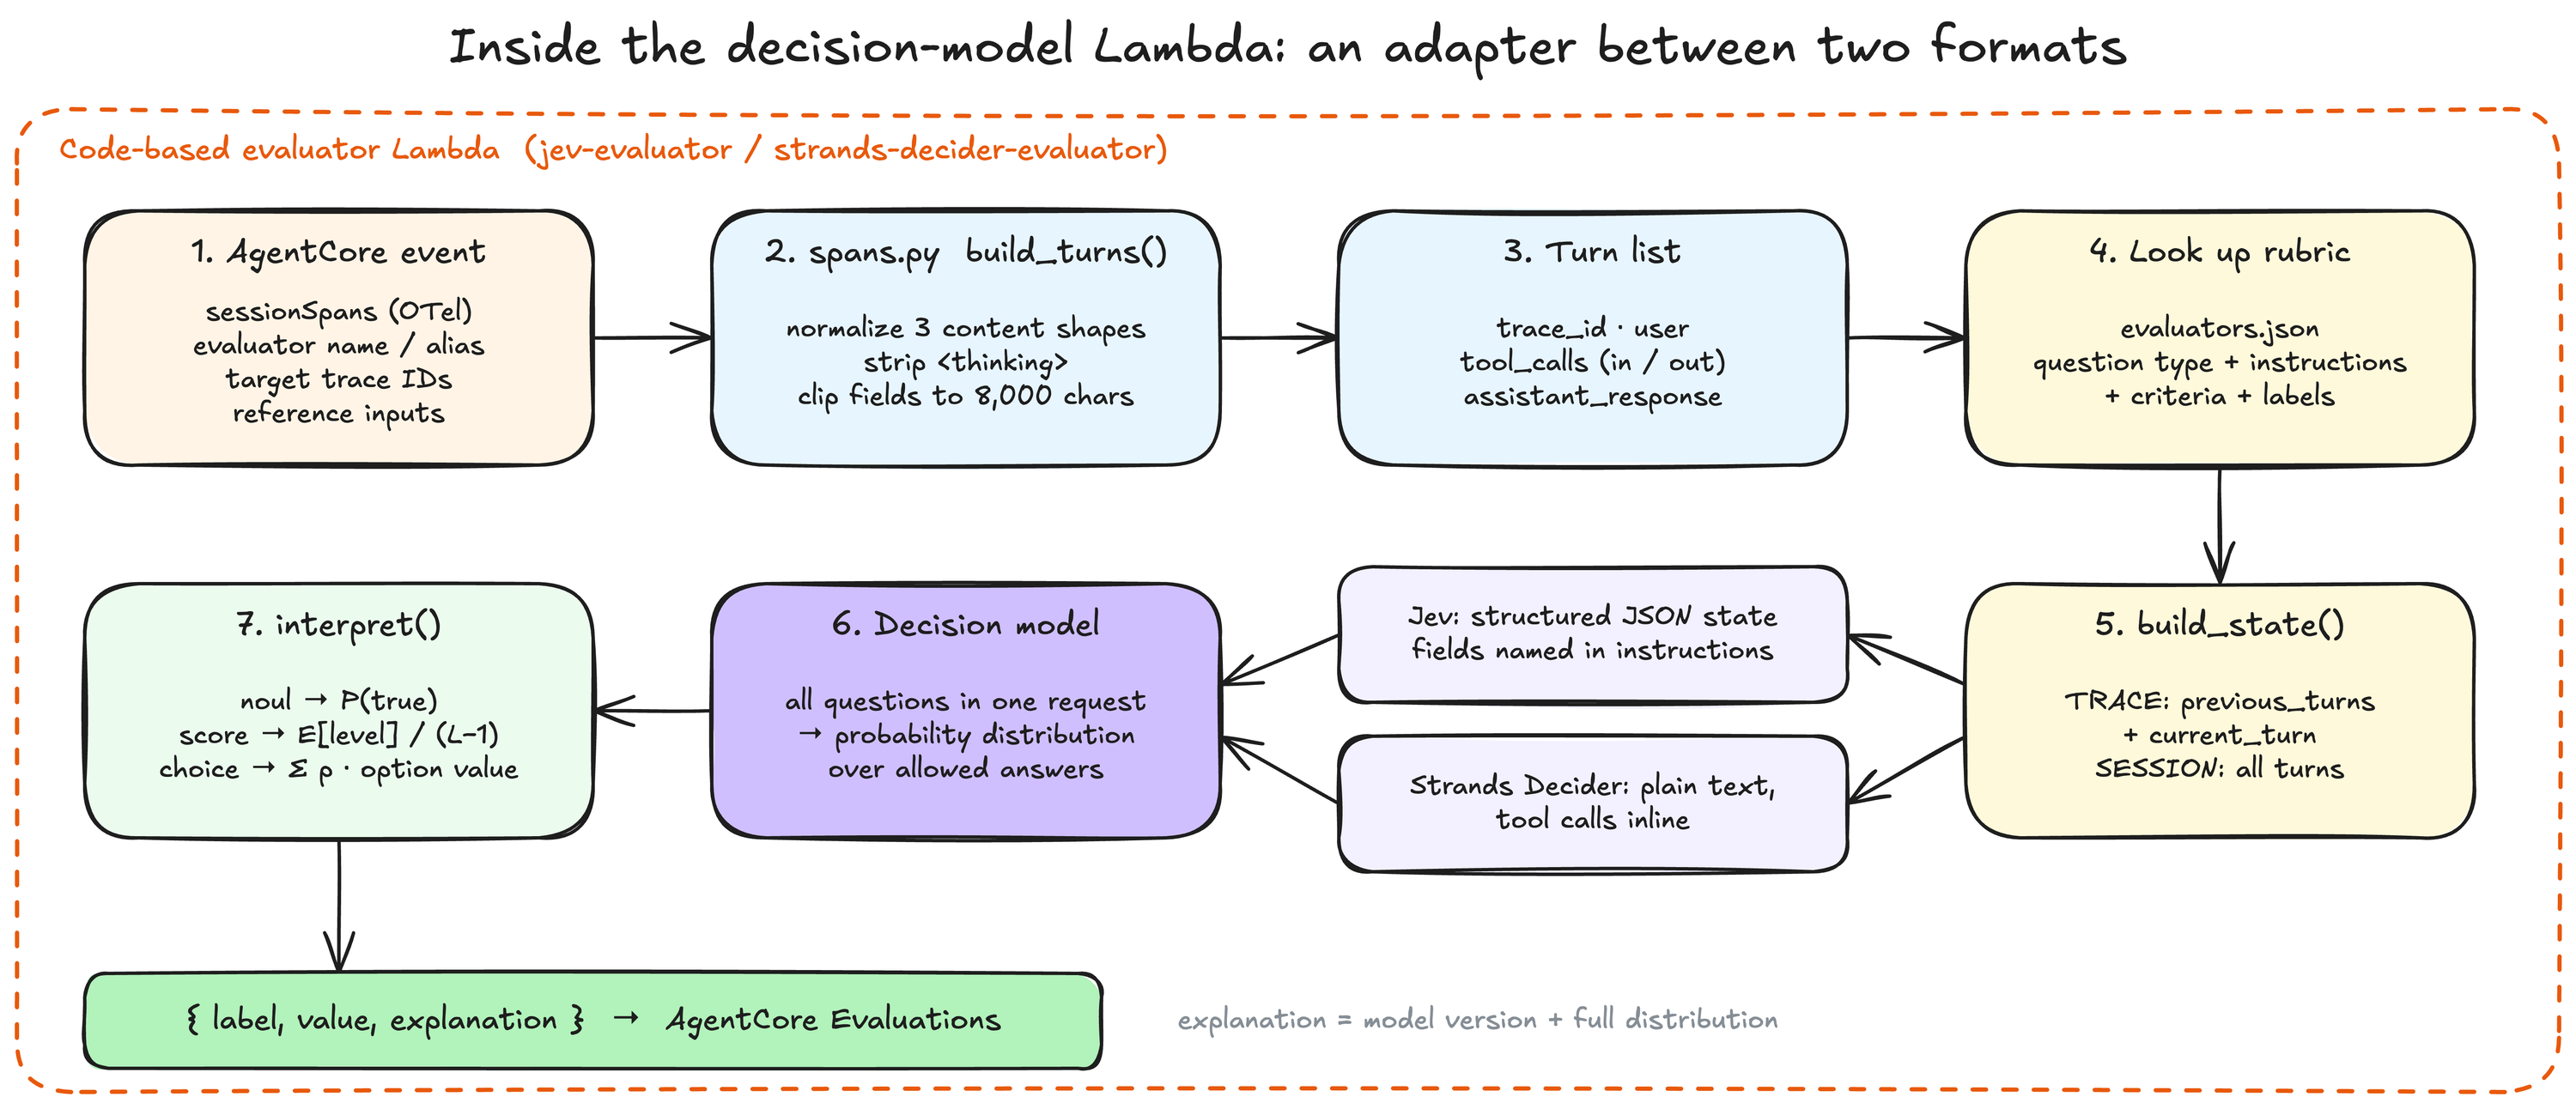
图 3:基于代码的评估器 Lambda 如何将 OpenTelemetry span 适配给决策模型,并将结果映射回 AgentCore
适配器将模型的概率分布转换为 AgentCore 评估所期望的结果。对于 noul 问题,true 的概率成为值,最可能的答案成为标签。对于 score 问题,值是概率加权的预期级别,缩放到 [0, 1]。对于 choice 问题,值是预定义选项值的加权平均值。
在您自己的流量上验证决策模型评估器
当你把评分标准改写为决策模型问题时,你实际上创建的是一个新的度量方式,而不是对旧方式的复制。改写后的评分标准往往比原本预期的更严格或更宽松,而且在你用真实会话去检验之前,你不会察觉到这种漂移。在用决策模型评估器来把关发布之前,请像验证任何新度量方式一样验证它——用你自己流量的带标注样本。本节的目标是带你完整走一遍这个验证流程,让你最终得到一个可以放心设置阈值的评估器。
该流程包含五个步骤。
第 1 步。构建带标注的样本。从你的智能体流量中抽取一组已存储的会话,要充分覆盖你关心的失败情况和边缘情况。只覆盖正常路径(happy path)的样本无法告诉你评估器会在哪里出问题。
第 2 步。获取人工参考标注。让三名独立标注员针对你的问题所度量的属性对每一轮进行打分,并以多数票作为参考标签。记录哪些轮次是一致通过、哪些轮次存在分歧。一致通过的轮次是清晰明确的案例,而存在分歧的轮次才是有价值的,因为它们能在模型接触评分标准之前就揭示评分标准本身的模糊之处。
第 3 步。在相同的输入上运行两个评估器。在单次批量评估中,让决策模型评估器和对应的内置评估器在这些相同的会话上运行。对完全相同的输入打分,才能使比较公平对等。
第 4 步。从三个视角解读结果。有了多数票标签以及简单与困难案例的划分,你就可以回答三个问题,判断评估器是否已准备就绪。
- 一致率:它与你的标注员一致吗?测量每个评估器与多数票标签一致的频率,并按问题逐一测量,因为某个问题的准确率说明不了另一个问题的情况。然后将数据按简单(一致通过)和困难(投票分歧)案例分别统计。一个只在困难案例上出错、表现得很像你的人工标注员的评估器,恰恰是你想要的结果。
- 校准:置信度分数有意义吗?按评估器报告的概率对轮次分组,并比较每组与标签的一致程度。置信度越高,准确率也应该越高。然后检查简单案例是否始终比困难案例获得更高的置信度。如果是,说明模型的不确定性在真实地反映模糊性,你就可以利用这些分组为每个评估器选取决策阈值,而不是默认使用 0.5。
- 分歧分析:它们在哪里、为什么不同?找出两个评估器彼此不一致的轮次,检查它们是否正是你的标注员认为模糊的那些轮次。逐条阅读它们。大多数分歧都可以追溯到问题的措辞,而修改问题措辞即可解决。当错误集中在困难案例中时,问题出在评分标准而非模型本身。
第 5 步。任何变化发生时重新运行检查。把这当作一个可重复的检查,而不是一次性的关卡。每当你重新措辞某个问题或切换到新的模型版本时,都要重新运行。每个结果的说明中都会记录生成它的模型版本,因此你知道某个分数来自哪个版本。
为你的智能体挑选最佳的评估器组合
在 AgentCore Evaluations 中,内置评估器仍然是广泛评估策略的基础。它们根据评分标准及其支持上下文对响应进行评估,并解释判断结果,以便开发者调查问题出在哪里。对于 HR Assistant,忠实度评估可以识别出与工具结果相矛盾的陈述,而有用性评估可以指出智能体回答了余额问题却没有完成所请求的操作。
忠实度、有用性和正确性评估可能需要关联证据、识别缺失信息或推导解决方案。预印本论文 JEV-as-a-Judge: Accept When Confident, Escalate When Unsure 将这种相关区别描述为“阅读与推导”。狭窄的决策模型检查可以标记需要关注的对话轮次,而内置评估器则提供审查该轮次所需的更广泛评估和推理。当你把决策模型当作门控而非替代品时,它们才能发挥最大作用。级联模式的工作方式如下:首先,在每个会话的每一轮上运行一个快速、经过校准的决策模型,以获得廉价的通过/失败信号;然后仅对信号低于阈值的会话调用完整的 LLM 评估器。
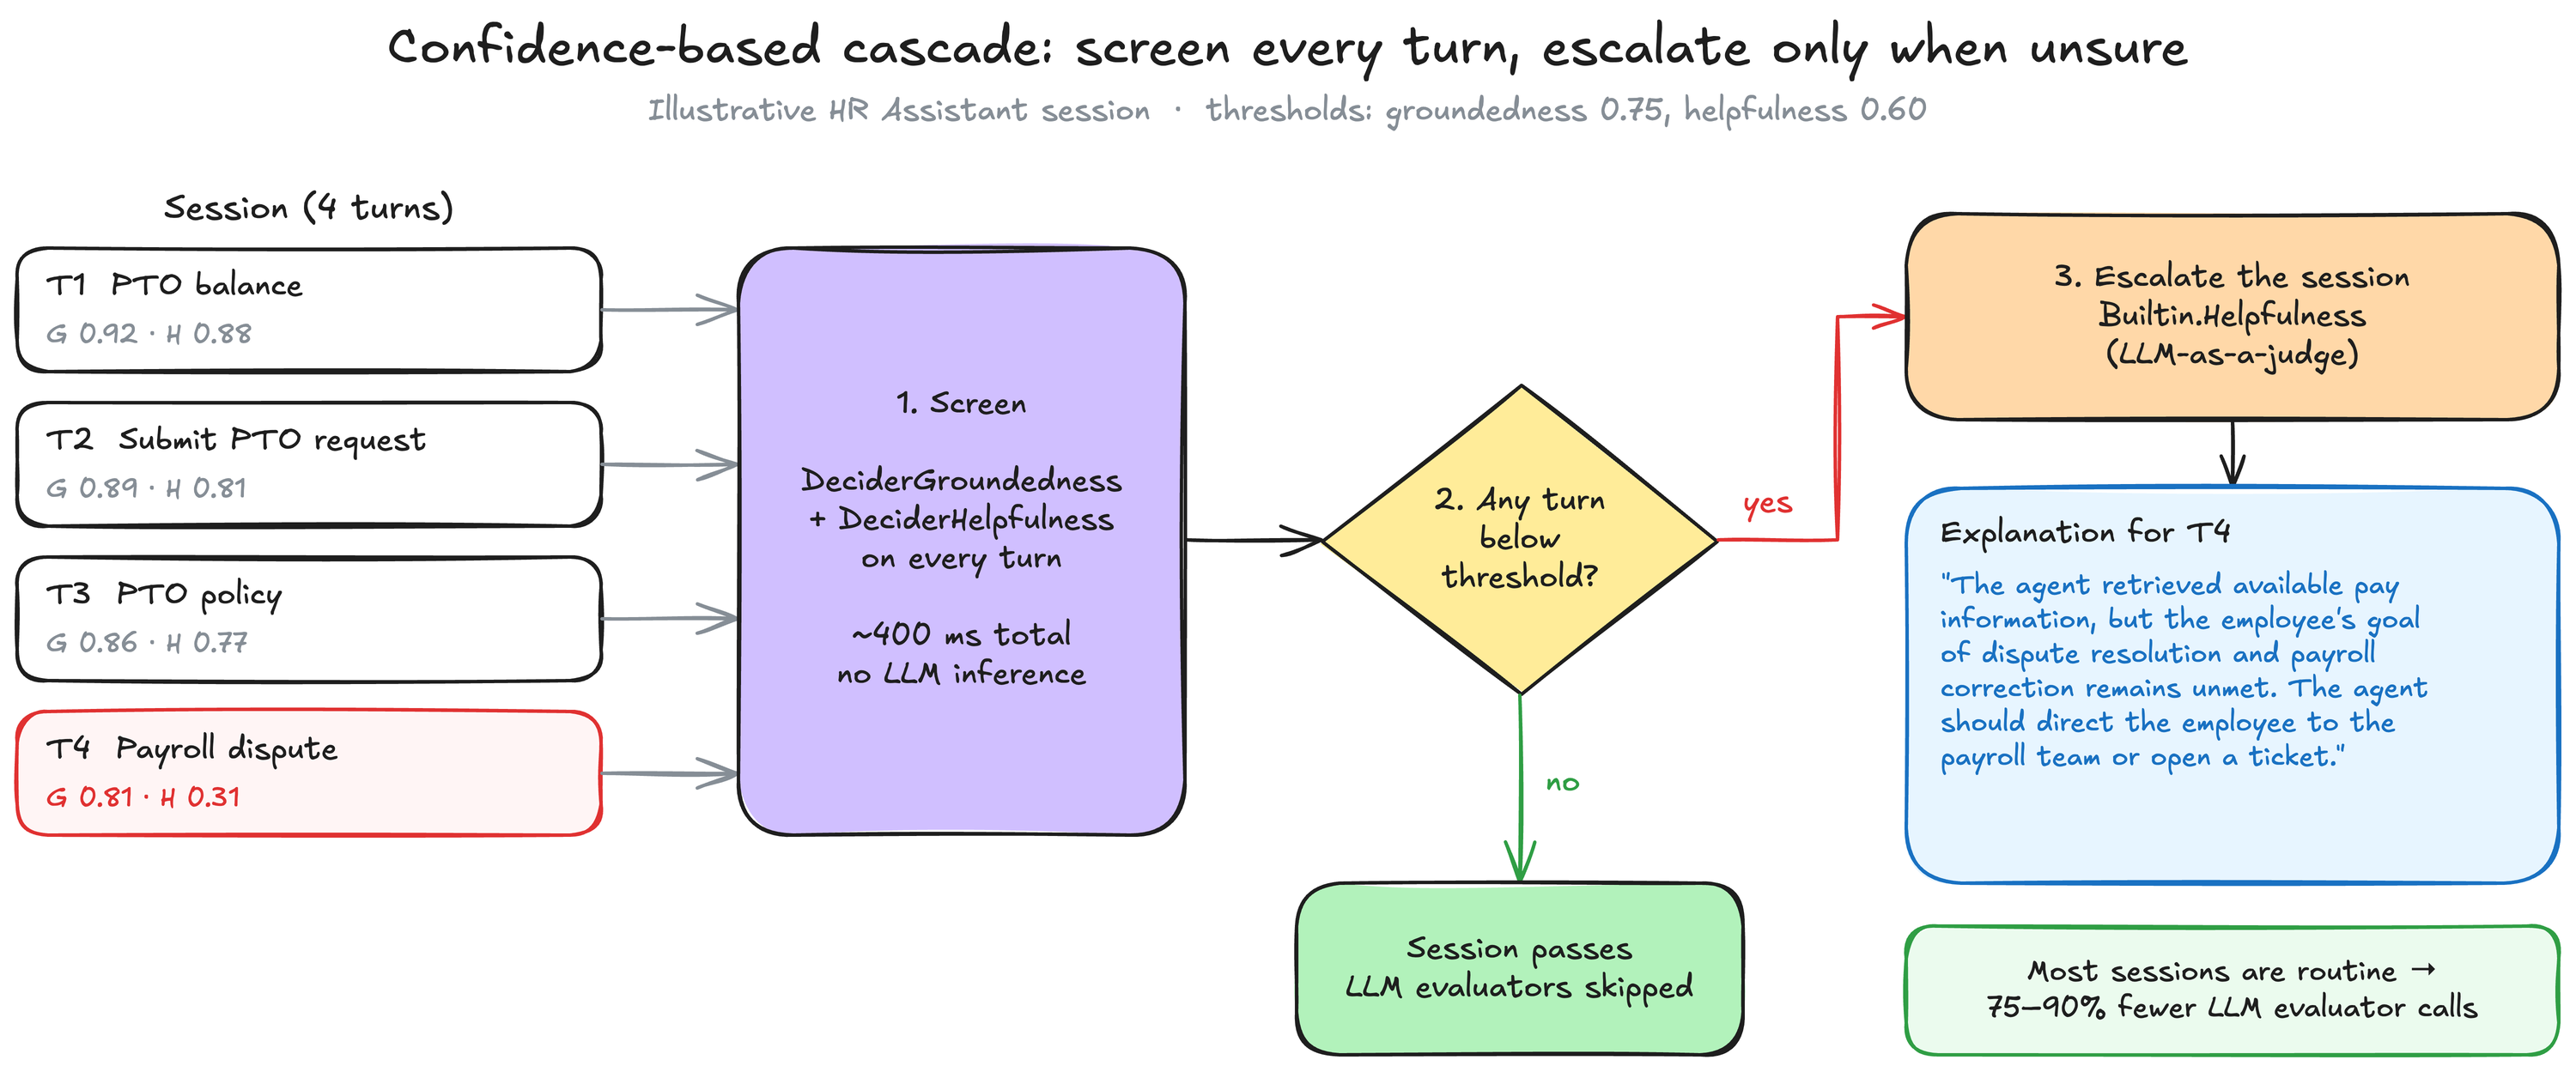
图 4:级联模式,由经过校准的决策模型筛选每一轮,仅将低置信度的轮次升级到内置评估器
| 评估标准 | LLM 作为评审 | 决策模型作为评审 |
| 输出 | 评分 + 解释 | 校准后的概率 |
| 延迟 | 2–10 秒 | ~数百毫秒(网络) |
| 可定制性 | 有限(固定的提示词模板) | 问题定义 |
| 最适用于 | 定性细微差别、解释 | 校准后的判断 |
我们推荐以下配置:
- 为你所依赖的内置评估器配置在线评估,作为衡量所有智能体质量的标准。
- 在同一配置中添加决策模型评估器,用于特定领域的“是/否”和选择题,并为所有可以精确计算的内容添加基于代码的确定性评估器。
- 每周或按照适合你发布周期的计划,查询决策模型检查失败或得分接近阈值的会话的在线结果,并使用内置评估器对这些会话运行批量评估以获取解释。
- 以内置评估器以及你已对照标注数据验证过的决策模型评估器作为发布门控,并跟踪两者的一致频率。
清理
为避免持续产生费用,请运行 cleanup.py,它会删除托管在 AgentCore runtime 上的智能体、评估器和评估配置、注册为评估器的 AWS Lambda 函数、托管 Strands Decider 模型的 EC2 实例、AWS Secrets Manager 密钥以及 CloudWatch 上关联的日志组。
结论
在这篇文章中,你使用基于代码的评估器将两个决策模型 Jev 和 Strands Decider 连接到 AgentCore Evaluations,随附的代码示例为你提供了一个框架,用于测试这些模型并了解它们作为评估器在哪些方面增加价值。内置评估器仍是你的基线。决策模型增加了狭窄的、经过验证的检查,并带有可设置阈值并据此采取行动的确定性度量。切实可行的前进路径是,在你已经在运行的内置评估器之外添加决策模型检查,在自己的流量上测量它们与参考标签一致的频率,并且只有在你信任它们之后才扩大覆盖范围。
要开始使用,请查阅 Amazon Bedrock AgentCore Evaluations 文档,使用 基于代码的评估器 集成自定义评估器,并深入了解 Strands Decider 模型。通过从 Amazon Bedrock AgentCore 示例仓库 部署示例评估器,开始使用代码示例。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com