AWS 演示用 LiteLLM + NVIDIA NeMo Switchyard 在 Amazon Bedrock 上路由 coding agent 请求
Route coding agent requests to the right model on Amazon Bedrock with NVIDIA NeMo Switchyard
NVIDIA NeMo Switchyard 是一个开源库,可让 AI 智能体按请求选择处理模型,路由效果应以「每个已解决任务的成本」来评估。
Claude Code 和 OpenAI Codex CLI 这类编程智能体以任务为单位工作。开发者提出一个修改需求,智能体读取文件、编辑代码、运行测试,直到工作完成。一个任务可能只需要几次模型调用,也可能需要几十次。开发者付费的对象是任务,而不是单次调用。
单看每 token 的价格并不能告诉你完成整个任务需要花多少钱。总成本取决于模型需要多少轮对话、每一轮要重放多少历史记录,以及任务需要重试多少次、或者根本无法完成。你为每一次尝试付费,包括那些永远无法完成的任务的尝试。因此,当你在多个模型之间路由编程智能体的请求时,应该用“每个已解决任务的成本”来评判路由效果:即运行总成本除以测试通过运行的数量。
NVIDIA NeMo Switchyard 是一个开源库,可帮助 AI 智能体选择由哪个模型处理每个请求。你可以定义它可使用的模型以及遵循的策略。其 LiteLLM 集成支持两种策略。阶段路由(Stage routing)会读取请求历史中最近的工具活动及结果,然后从两个候选模型中选择一个。随机路由(Random routing)从已配置的模型中挑选(可带权重),用于流量切分和 A/B 对比。另一个值得探索的选择是 LiteLLM,它最近也发布了原生内置的 Switchyard 阶段路由器,作为一种自动路由(auto-router)策略。
在这篇文章中,你将使用 AWS Cloud Development Kit (AWS CDK) 在你的 AWS 账户中部署 LiteLLM(一个面向大语言模型 (LLM) 的开源网关)以及 Switchyard 路由插件。LiteLLM 调用 Amazon Bedrock 上的模型。然后,你可以使用该示例的基准测试运行器,测量路由模型组和单模型基线组各自“每个已解决任务的成本”,从而针对你自己的工作负载评估路由效果。
注意:该示例从 crates.io 安装
switchyard-server0.3.0 并运行已发布的 LiteLLM v1.102.0 镜像。NVIDIA 将switchyard-server0.3.0 定位为演示和评估组件,其配置可能随版本更迭而变化。本示例使用实验性的 Switchyard LiteLLM 集成,其配置和 API 可能随版本更迭而变化。这是示例代码,仅供非生产用途。在部署之前,请与你的安全和法务团队合作,以满足你所在组织的安全、监管和合规要求。请在非生产账户中部署该示例并进行测试,之后再依赖它。
解决方案概览
图 1 展示了该解决方案的架构。LiteLLM 和 Switchyard 插件运行在 AWS Fargate 上 Amazon Elastic Container Service (Amazon ECS) 的一个容器镜像中,位于私有子网内。
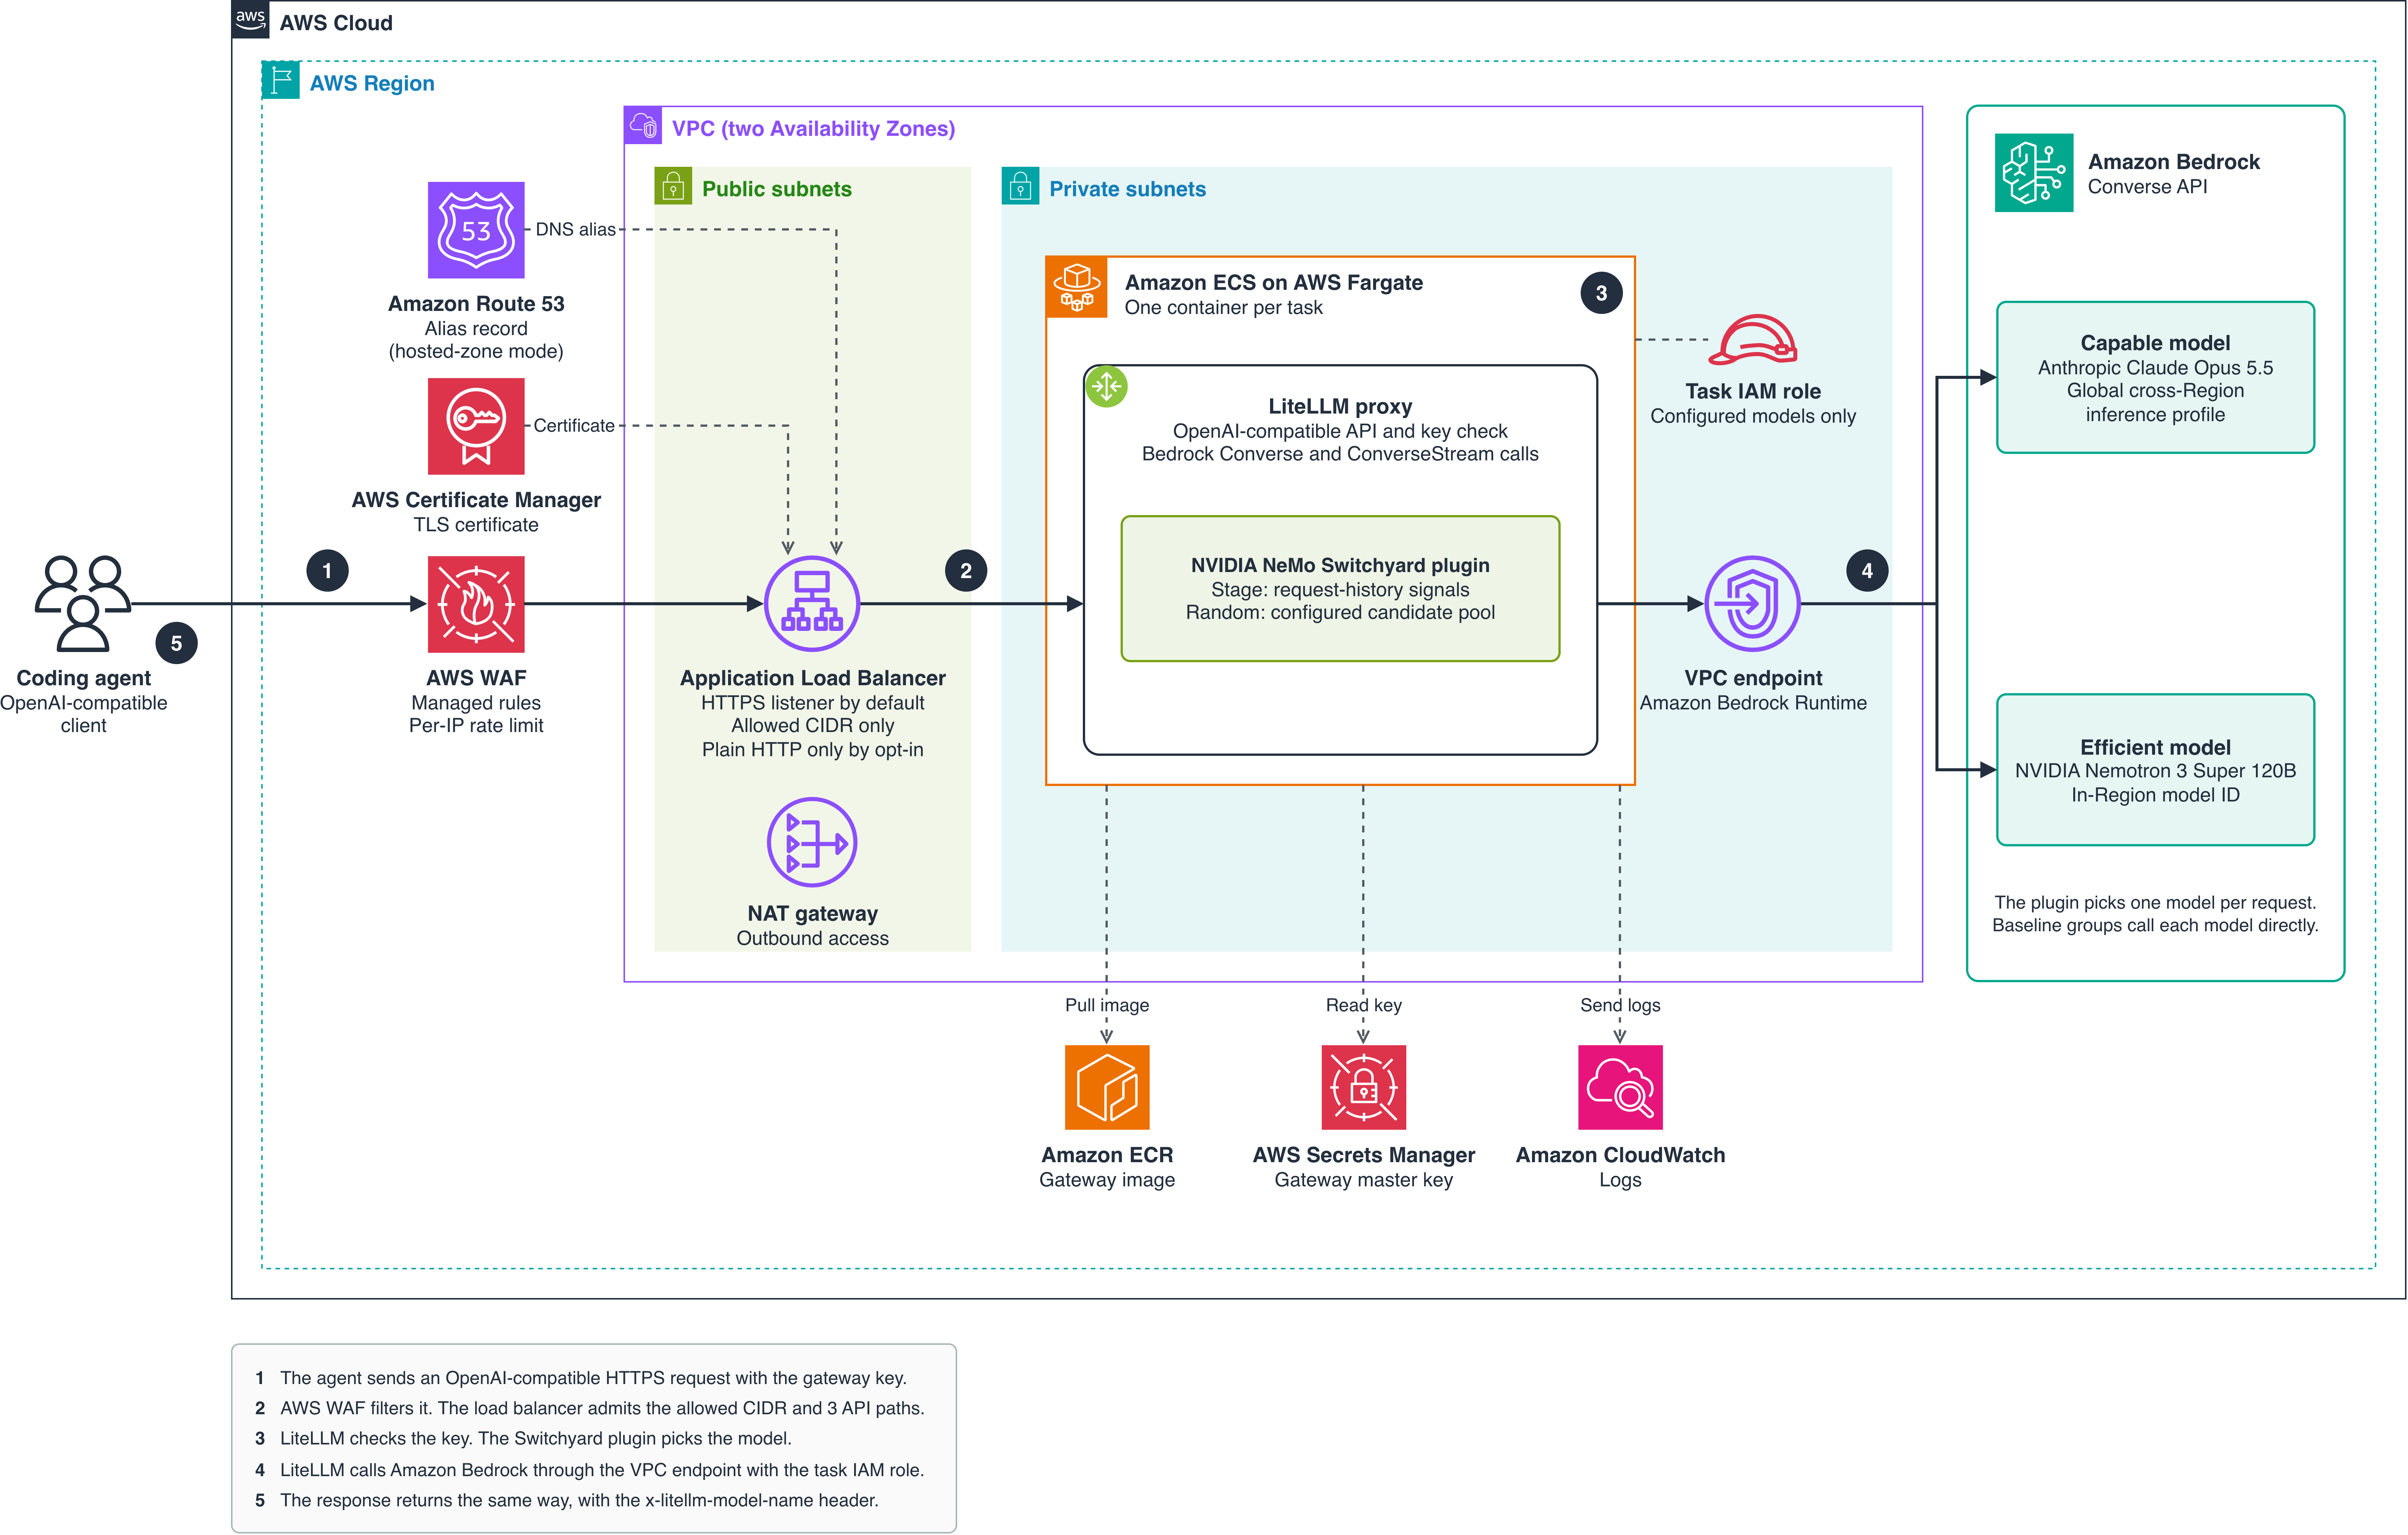
图 1:解决方案架构
请求经过以下步骤流转。编号与图中的标注一致。
- 编程智能体发送一个 OpenAI 兼容的请求,其中 model 字段设置为
switchyard(即由 Switchyard 路由的 LiteLLM 模型组),并在Authorization请求头中携带共享网关密钥。端点是通过 HTTPS 访问你的主机名,负载均衡器上配有 AWS Certificate Manager (ACM) 证书,且只有你允许的 IPv4 CIDR 范围可以访问它。借助 Amazon Route 53 中的托管区域,Route 53 将该主机名解析到负载均衡器。 - AWS WAF 使用 IP 信誉、已知恶意输入和基于 IP 的速率限制规则来过滤请求。Application Load Balancer 只将
/v1/chat/completions、/v1/models和/health/liveliness转发到私有子网中的 ECS 任务,并对所有其他路径返回 404。 - 该任务运行一个容器:带有内置 Switchyard 插件的 LiteLLM。LiteLLM 验证网关密钥并调用插件来选择模型。Stage 策略在能力强的模型与成本更低的效率型模型之间进行选择。它会读取请求历史中的工具调用活动和结果,因此智能体必须发送完整的对话历史。Random 策略从加权池中随机选择。这两种策略都不调用评审模型。
- LiteLLM 通过 Amazon Bedrock
Converse或ConverseStreamAPI 调用所选模型,并使用任务的 AWS Identity and Access Management (IAM) 角色获取凭证。调用经由 Amazon Virtual Private Cloud (Amazon VPC) 中的 Amazon Bedrock Runtime 接口端点进行,因此推理流量始终留在 AWS 网络内。 - 响应或令牌流经由 LiteLLM 和负载均衡器返回。
x-litellm-model-name响应头标明应答的模型。响应体的model字段保持为switchyard。
LiteLLM 在容器内监听 4000 端口,并作为负载均衡器的目标,任务的安全组只允许负载均衡器访问。路径白名单使 LiteLLM 的管理界面、API 文档和密钥管理路由无法访问。Amazon Elastic Container Registry (Amazon ECR) 存放网关镜像。AWS Secrets Manager 生成网关密钥背后的机密,容器在启动时添加 sk- 前缀。任务定义通过 LITELLM_CONFIG_TEXT 和 SWITCHYARD_CONFIG_TEXT 传入配置文件,启动脚本在启动 LiteLLM 之前将它们写入 /tmp。日志发送到一个 Amazon CloudWatch 日志组 /<stack name>/litellm,保留 30 天,并由 Container Insights 收集指标。该 VPC 跨越两个可用区,由一个 NAT 网关为镜像拉取和其他 AWS 服务提供出站访问。
该插件支持 Stage 路由(需要恰好两个候选模型)和 Random 路由(需要至少两个候选模型,并按权重分流流量以进行 A/B 测试)。基于分类器的策略(如 Task 和 Composite 路由)需要中间模型调用,而此集成不支持这些调用。完整目录请参见 Switchyard 路由概览。
前提条件
要完成本演练,你需要满足以下条件:
- 一个具备 Amazon Bedrock 访问权限的非生产 AWS 账户,可访问 Claude Opus 5.5 和 NVIDIA Nemotron 3 Super 120B。这对模型已在 US East (N. Virginia) 区域完成测试。对于其他 AWS 区域,请查看 各模型的区域可用性 以及工具调用支持情况。
- AWS Command Line Interface (AWS CLI) v2,需配置好凭证并指定明确的 AWS 区域,且所在账户和区域已为 AWS CDK 完成引导(bootstrap)。
- Node.js 20 或更高版本、npm、带 BuildKit 的 Docker,以及 Python 3.11 或更高版本。
- 一个你拥有的主机名,其域名需有公有 Route 53 托管区域,或在部署区域拥有对应的 ACM 证书。简短的纯 HTTP 测试则两者都不需要。
演练
你将定义模型组、配置 Stage、部署并测试网关,然后衡量成本。首先克隆示例仓库:
git clone https://github.com/aws-samples/sample-route-coding-agent-requests-Amazon-Bedrock-nemo-switchyard.git
cd sample-route-coding-agent-requests-Amazon-Bedrock-nemo-switchyard
步骤 1:在 LiteLLM 中定义模型组
LiteLLM 模型组是一个公开模型名称,背后挂载一个或多个部署。示例将其配置保存在 profiles/ 下的部署配置文件中。每个配置文件将 litellm.yaml(定义模型和网关设置)与 switchyard.toml(控制 Switchyard 如何选择模型)配对。profiles/stage/litellm.yaml 的以下摘录定义了路由的 switchyard 组、两个单模型基线组以及插件注册:
model_list:
  - model_name: switchyard
    litellm_params:
      model: bedrock/converse/global.anthropic.claude-opus-5-5
      aws_region_name: os.environ/AWS_REGION
  - model_name: switchyard
    litellm_params:
      model: bedrock/converse/nvidia.nemotron-super-3-120b
      aws_region_name: os.environ/AWS_REGION
  # One-model baseline groups, same model strings as the routed candidates.
  - model_name: claude-opus-5-5
    litellm_params:
      model: bedrock/converse/global.anthropic.claude-opus-5-5
      aws_region_name: os.environ/AWS_REGION
  - model_name: nemotron-super-3-120b
    litellm_params:
      model: bedrock/converse/nvidia.nemotron-super-3-120b
      aws_region_name: os.environ/AWS_REGION

# The same object selects a deployment and applies supported request changes.
router_settings:
  plugins:
    - switchyard_gateway.configured.ROUTING_PLUGIN
litellm_settings:
  callbacks:
    - switchyard_gateway.configured.ROUTING_PLUGIN
  drop_params: true
  request_timeout: 600
  num_retries: 2
general_settings:
  master_key: os.environ/LITELLM_MASTER_KEY
两个候选共享 model_name: switchyard,因此客户端发送 "model": "switchyard",由 Switchyard 选择候选。把能力强的模型列在第一位,高效模型列在第二位,因为 Stage 会按照该顺序读取角色。
claude-opus-5-5 和 nemotron-super-3-120b 组是单模型基线。每组始终用自己的模型回答,因此可以在相同部署中把路由组的成本和通过率与单个模型进行比较。仅有 Stage 插件会拒绝没有两个候选的组,所以镜像注册了一个小型包装器 switchyard_gateway.configured.ROUTING_PLUGIN。它对具有两个或更多唯一候选的组应用 Switchyard,并直接放行单模型组。该配置注册了两次包装器:用于选择模型,以及应用 Switchyard 记录的请求更改。
每个模型都使用 bedrock/converse/<id>,因此每个候选都走 Amazon Bedrock Converse API,验证会拒绝任何其他路由。LiteLLM 的 request_timeout 为 600 秒,与负载均衡器的 10 分钟空闲超时相匹配。
该文件不含任何凭证。LiteLLM 从环境变量读取网关密钥,AWS 凭证由任务角色提供。切勿在 litellm_params 下添加 aws_access_key_id、aws_secret_access_key 或 api_key 等凭证:堆栈会将整个 litellm.yaml 以明文形式复制到任务定义和 AWS CloudFormation 模板中。
堆栈根据此文件推导任务角色的 Amazon Bedrock 权限。对于全局跨区域推理配置文件,基础模型资源使用 * 区域和尾部 *,因此它也会匹配具有相同前缀的其他模型 ID。部署前请审查推导出的策略。
global. 前缀表示一个 全局跨区域推理配置文件,Amazon Bedrock 可能会在全球受支持的商用 AWS 区域中处理这些请求。如果处理位置很重要,请改用地理配置文件或区域内模型 ID。对于 Nemotron 3 Super,该配置文件使用区域内模型 ID nvidia.nemotron-super-3-120b,测试时可以替换为任何模型。
步骤 2:配置 Stage 路由
Switchyard 从 switchyard.toml 读取其算法和设置。默认配置文件 profiles/stage/switchyard.toml 配置了 Stage:
# Model inventory is in litellm.yaml. This file configures selection behavior.
algorithm = "stage"
# Prefer the efficient candidate when history signals are inconclusive.
picker = "efficient_first"
confidence_threshold = 0.5
# Inspect the three most recent tool results for execution signals.
recent_window = 3
only_on_wrong_signal_escalation = true
各项设置的工作方式如下:
picker = "efficient_first":当历史中的信号不明确时,Stage 会使用高效模型。新请求还没有工具结果,因此会路由到 Nemotron 3 Super。confidence_threshold:Stage 为执行信号打分时的置信度阈值,取值范围 0 到 1。recent_window = 3:Stage 检查最近的三条工具结果。only_on_wrong_signal_escalation = true:Switchyard 的默认值。它控制 Stage 何时添加可选的升级说明,此配置文件未设置任何说明。
Stage 还接受可选的交接说明和按层级划分的系统提示(escalation_note、deescalation_note、capable_system_prompt 和 efficient_system_prompt)。示例配置文件均未设置这些内容。
对于 A/B 测试,profiles/random/ 中的 Random 配置文件使用相同的模型,并配合 algorithm = "random" 和 weights = [0.5, 0.5](按声明顺序为每个唯一候选设置一个权重)。要部署它,请在步骤 3 的 cdk diff 和 cdk deploy 命令中添加 -c routingProfile=random。
堆栈在合成时会一并验证这两个文件,预检脚本也运行相同的检查。要在不调用 AWS 的情况下单独检查配置文件的更改,请运行 npm run validate:profile -- stage。无效设置会导致 LiteLLM 启动时停止,不支持的消息结构会在推理前报错。
可选:在本地运行网关
在部署任何内容之前,你可以先在自己的机器上试用该网关。Docker Compose 构建相同的镜像,并读取与部署到 Amazon ECS 的堆栈相同的配置文件。从仓库根目录运行:
npm ci
cp .env.example .env

export LITELLM_MASTER_KEY="sk-$(openssl rand -hex 24)"
eval "$(aws configure export-credentials --format env)"

ROUTING_PROFILE=stage docker compose up --build --wait
GATEWAY_URL=http://127.0.0.1:4000 ROUTING_PROFILE=stage scripts/smoke-test.sh
你导出的密钥优先于 .env 中的占位符,因此 Compose 和冒烟测试使用的是同一个密钥。AWS 凭证只来自你的 shell,绝不会写入 .env 或配置文件中。Compose 仅在 127.0.0.1 上发布网关。本地没有负载均衡器,因此冒烟测试会跳过其封闭路径检查。本地网关仍会调用 Amazon Bedrock,这些调用会产生费用。完成后,运行 docker compose down。
步骤 3:部署网关
网关在你拥有的主机名上提供 HTTPS 服务。将 GATEWAY_DOMAIN 设置为该主机名,并将 HOSTED_ZONE 设置为包含该主机名的现有 Route 53 公有托管区。AWS CDK 随后会创建经 DNS 验证的 ACM 证书和别名记录。从仓库根目录安装依赖项,运行只读预检,然后部署:
npm ci

export AWS_REGION=us-east-1
export AWS_DEFAULT_REGION="$AWS_REGION"
eval "$(aws configure export-credentials --format env)"
export CDK_DEFAULT_REGION="$AWS_REGION"
export CDK_DEFAULT_ACCOUNT="$(aws sts get-caller-identity --query Account --output text)"
export ALLOWED_CIDR="$(curl -4 -fsS --connect-timeout 5 --max-time 15 https://checkip.amazonaws.com)/32"
export GATEWAY_DOMAIN=llm-gateway.example.com
export HOSTED_ZONE=example.com

scripts/preflight.sh
npx cdk diff -c allowedCidr="$ALLOWED_CIDR" \
  -c domainName="$GATEWAY_DOMAIN" -c hostedZone="$HOSTED_ZONE"
npx cdk deploy -c allowedCidr="$ALLOWED_CIDR" \
  -c domainName="$GATEWAY_DOMAIN" -c hostedZone="$HOSTED_ZONE"
如果你的域名的 DNS 不在 Route 53 中,请改用现有的 ACM 证书。将 CERTIFICATE_ARN 设置为部署区域中该主机名的 ACM 证书,并在两条命令中将 -c hostedZone="$HOSTED_ZONE" 替换为 -c certificateArn="$CERTIFICATE_ARN"。AWS CDK 随后不会创建证书和 DNS 记录。部署完成后,创建一条 CNAME 记录(或 Route 53 别名),将主机名指向 LoadBalancerDnsName 输出。
必填的 allowedCidr 值限制了哪些网络可以访问负载均衡器,该命令会将其设置为当前的公网 IPv4 地址。请将其保持为你自己的 /32:所有共享同一允许地址的人(例如办公室 NAT 或 VPN 出口)都可以访问该端点。如果没有 allowedCidr、使用 0.0.0.0/0 这样的完全开放范围,或使用 IPv6 范围,堆栈将拒绝合成。
预检会检查配置、你的工具和你的 AWS 访问权限(包括对配置文件中每个模型的访问权限),而不会发出推理请求。AWS CDK 构建网关镜像,将其发布到 Amazon ECR,并部署堆栈。部署会输出以下内容:
| 输出 | 含义 |
| GatewayUrl | 基础 URL。与 OpenAI 兼容的 API 位于 /v1 下。 |
| MasterKeySecretArn | 网关密钥背后的 Secrets Manager 密钥。完整密钥为 sk- 加上密钥值。 |
| MasterKeyCommand | 用于打印网关密钥的命令。 |
| SmokeTestCommand | 冒烟测试命令,其中已填入堆栈名称、区域和配置文件。 |
| RoutingProfile | 当前启用的路由配置文件,默认为 stage。 |
| ClusterName, ServiceName | ECS 集群和服务。密钥轮换步骤会用到它们。 |
| LoadBalancerDnsName | 仅当指定 certificateArn 时:将你的主机名指向该名称。 |
始终向客户端提供 https:// URL。端口 80 保持开放仅用于重定向到 HTTPS,而配置为 http:// 的客户端在重定向到达之前,已经以明文发送了密钥和它的第一个请求。
负载均衡器的空闲超时为 10 分钟,以支持智能体的长响应。Web ACL 使用 Amazon IP 信誉列表和已知错误输入规则组。它还将每个 IP 地址限制为每 5 分钟 2,000 个请求。它省略了针对跨站脚本、SQL 注入和正文大小的通用正文规则,因为智能体请求中的源代码会触发这些规则。allowedCidr 范围和网关密钥仍然生效。
通过纯 HTTP 快速测试。如果没有 HTTPS 设置,synth 会报错终止。如果想要在没有域名的情况下进行简短测试,你可以选择在负载均衡器的 DNS 名称上使用纯 HTTP:
npx cdk deploy -c allowedCidr="$ALLOWED_CIDR" -c allowPlainHttp=true使用 allowPlainHttp=true 时,AWS CDK 每次合成该栈都会打印一条警告。Authorization 请求头中的网关密钥、你的提示词、智能体发送的工具结果和源代码,以及模型响应,都会在客户端与负载均衡器之间以未加密方式跨越网络传输。请仅在短期内用来自你自己的 /32 的非敏感代码进行测试时使用此可选功能。之后请轮换密钥,并在完成时运行 cdk destroy。稍后要将同一栈迁移到 HTTPS,请使用 HTTPS 设置且不带 allowPlainHttp 重新部署。
第 4 步:测试网关
在你用于部署的同一终端中,读取 AWS CloudFormation 栈输出并构建网关密钥:
export STACK_NAME=SwitchyardGateway

output() {
  aws cloudformation describe-stacks --region "$AWS_REGION" --stack-name "$STACK_NAME" \
    --query "Stacks[0].Outputs[?OutputKey=='$1'].OutputValue" --output text
}

export GATEWAY_URL="$(output GatewayUrl)"
export LITELLM_MASTER_KEY="sk-$(aws secretsmanager get-secret-value --region "$AWS_REGION" \
  --secret-id "$(output MasterKeySecretArn)" --query SecretString --output text)"
向 switchyard 模型组发送一个请求:
curl -sS -i --connect-timeout 10 --max-time 180 "$GATEWAY_URL/v1/chat/completions" \
  -H "Authorization: Bearer $LITELLM_MASTER_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"switchyard","messages":[{"role":"user","content":"Reply with the word hello."}],"max_tokens":128}'
查找 HTTP 200 和响应。x-litellm-model-name 响应头以完整的 LiteLLM 模型字符串形式显示所选模型。新请求没有可供评分的工具结果,因此 Stage 会选择高效模型 bedrock/converse/nvidia.nemotron-super-3-120b。
要检查健康状况、身份验证和路由,请运行冒烟测试:
ROUTING_PROFILE="$(output RoutingProfile)" scripts/smoke-test.sh冒烟测试会检查健康端点、确认 /ui 等已关闭的路径返回负载均衡器自身的 404、确认不带密钥的请求返回 401,并确认 /v1/models 列出每个模型组。对于 Stage,它检查普通请求是否选择高效模型,以及记录在案的历史重复失败是否会升级到能力更强的模型。然后它向每个基线组发送一个请求。该请求和冒烟测试会产生 Amazon Bedrock 计费调用。
要尝试你自己的智能体,请使用 $GATEWAY_URL/v1 作为其 OpenAI 兼容的基础 URL,使用网关密钥作为其 API 密钥,并使用 switchyard 作为模型。Stage 需要随每次请求提供完整的受支持请求历史。上游适配器支持文本消息、函数工具调用和文本工具结果,不受支持的消息结构会在推理之前失败。负载均衡器转发 Chat Completions 路径,但不转发 OpenAI Responses 或 Anthropic Messages 路径。使用这些 API 的客户端会收到 404,直到你添加该路径、针对本地容器进行测试并重新部署。
第 5 步:衡量每个已解决任务的成本
示例的编码运行器 bench/run.py 允许一个小型编码智能体通过网关列出并读取文件、替换源文件以及运行提供的单元测试。任务在结束时其测试通过(默认在六次模型轮次内)即为已解决。列出任务并从路由组上的 slugify 开始:
python3 bench/run.py --list-tasks
python3 bench/run.py --tasks slugify --model switchyard --max-turns 6
终端会显示任务、所选模型、工具操作、测试结果以及最终的代码差异。每次运行都会在 bench/results/ 下保存其起始文件、最终工作区、对话记录、补丁和结果。
| 任务 | 智能体必须做的事情 |
| slugify | 修复一个用于构建 URL slug 的短函数。 |
| roman | 编写一个将整数转换为罗马数字的函数。 |
| calc | 编写一个不带 eval 的表达式解析器,支持优先级、幂运算符、函数和错误处理。 |
| lru_ttl | 编写一个线程安全的最近最少使用(LRU)缓存,支持按条目过期和精确计数。 |
为给算术解析器任务留出运行测试和尝试修复的空间,请提高轮次限制:
python3 bench/run.py --tasks calc --model switchyard --max-turns 12运行结束后,运行器会为每个模型组打印一行,包含 RUNS、SOLVED、ERRORS、COST/TASK 和 COST/SOLVED 列。每个已解决任务的成本是该组所有运行的预估成本除以测试通过的那些运行。运行器根据 x-litellm-model-name 头中的模型以及响应中的 token 用量为每一轮定价,使用 bench/run.py 中的 PRICES 表。包含缓存输入的轮次、PRICES 中没有对应条目的模型,或缺少头部或 token 计数的响应,将保持未定价状态,而不是按零计算。在向配置文件添加模型时,请添加相应的 PRICES 条目,并查阅 Amazon Bedrock pricing 了解当前价格。两个任务上的几次运行演示了这一工作流程。它们不足以得出关于成本或质量的结论。
当某个组中的任何一次运行未定价时,该组会显示 n/a 及其原因;当没有运行被解决时,COST/SOLVED 会显示 -。要了解成本去向,请查看各轮次:终端会打印为每一轮提供服务的模型,bench/results/ 下的会话记录也会记录它。
为了比较完整的对话,bench/multiturn.py 会在每个编码任务上运行一个智能体循环,第一轮提示中包含项目文件,并在每次编辑后反馈测试输出。它还会运行四段脚本化的七轮聊天,在简单轮次与设计、调试和代码编写轮次之间交替进行,并且每一轮都重放完整的对话历史。带有简单检查的轮次(预期文本、字数限制、要点列表,或针对返回函数的断言)会记录检查是否通过。设计类响应不评分。
python3 bench/multiturn.py --tasks slugify --scripts backend api --max-spend 2--max-conv-cost 选项(默认 1 美元)限制每次对话的开销,--max-spend 会阻止运行器启动新的对话。摘要针对每个模型组显示通过的编码对话数、通过的聊天检查数,以及每个编码对话、每次聊天和总计的预估成本。
运行器会在你的机器上执行模型编写的 Python 代码。运行测试的子进程环境中没有凭证,但它并不是操作系统级沙盒:代码可以读取你的用户能读取的任何文件,并可以访问网络。请使用一次性的开发环境,磁盘上不要保留长期有效的 AWS 凭证,并保护 bench/results/ 下的文件,其中包含提示词、模型响应、工具输出和生成的代码。
解读结果
示例中的任务规模较小,仅作说明之用。要判断路由是否适合你的工作负载,请用能代表你自己代码库的任务替换或扩展这些任务,并在阅读运行器输出时牢记以下几点。
- 先看 SOLVED,再看 COST/SOLVED – 解决任务数较少的组可能显示更低的 COST/TASK,但每个已解决任务的成本反而更高,因为失败的运行增加了成本却没有增加已解决任务数。只有在比较了各组解决的任务数量之后,才应将路由组的 COST/SOLVED 与各基线组进行比较。
- 单独查看困难任务 – 汇总数字可能掩盖单个左右结果的任务。请按任务拆分结果。Stage 会根据历史记录中的失败情况进行决策,因此无法预先将困难任务路由给能力强的候选模型。一次升级轮次还会重放整个失败的尝试,这可能使恢复过程比一开始就使用能力强的候选模型的运行更加昂贵。如果少数困难任务主导了你的成本,可以考虑将它们路由到一个专门的模型组,或者选择一个能解决更多这类任务的高效候选模型。
- 进行足够次数的重复运行 – 模型的输出每次运行都有差异。如果每组只有少量几次运行,一两道任务是否解出的差别可能只是噪声。增加
--repeats,直到你关心的差异趋于稳定,并在依据差距采取行动之前先应用统计检验,例如用 Fisher 精确检验来分析解题率。 - 考虑轮次限制 – 过低的
--max-turns值会惩罚那些在编辑前先进行探索的模型,因为它留给修复失败编辑的轮次更少。请将限制设置为与你实际运行智能体的方式相符。 - 考虑输出上限 – 如果某一组的回复触及了
max_tokens,测得的成本是下限,且被截短的回复也会缩短后续轮次重放的历史记录。在比较聊天成本之前,请检查对话记录中是否有被截断的回复。 - 将成本视为估算值 – 运行器是根据 token 用量和 PRICES 表来估算成本的,而不是根据你的账单。提示缓存、批量推理以及价格变动都会影响你的实际成本。请通过 Amazon Bedrock 定价和你的 AWS 成本与使用报告进行确认。
- 测试你计划运行时使用的设置 – 结果只适用于你测量过的模型、配置文件设置和任务。如果你更改了候选模型、Stage 设置,或切换到 Random 配置文件,请重新测量。
利用这些测量结果,在三种方案中为每个工作负载做出选择:路由组、单模型组,或使用不同候选模型或设置的配置文件。当你更改模型、提示或智能体行为时,请重新运行相同的测量。
清理资源
为避免持续产生费用,请删除该堆栈。AWS CDK 需要一个 allowedCidr 值来合成应用程序,但此处的值并不重要:
npx cdk destroy -c allowedCidr=203.0.113.0/24CloudFormation 会删除主密钥密钥且没有恢复窗口,因此如果你需要该密钥,请先复制一份。网关镜像会保留在 Amazon ECR 的 AWS CDK 引导仓库中。
结论
在这篇文章中,我们展示了如何在 AWS 上部署带 NVIDIA NeMo Switchyard 路由插件的 LiteLLM,在 Amazon Bedrock 上跨模型配置 Stage 和 Random 路由,并测量路由模型组相对于单模型基线每道已解任务的成本。由于智能体任务的总成本取决于轮次、历史记录和重试次数,单凭每 token 价格并不是可靠的指导依据。在你自己的任务上测量每道已解任务的成本,能为你选择配置提供依据。
要开始使用,请在开发账户中部署示例仓库,并在你自己的工作负载任务上测量 Stage 路由和单模型基线。欲了解更多信息,请参阅 Switchyard LiteLLM 插件指南和 Amazon Bedrock 用户指南。欢迎在评论区提出你的问题。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com