Amazon Bedrock 为 Kimi K3 推出印度本地推理服务
Introducing India-based inference for Kimi K3 on Amazon Bedrock
Moonshot AI(月之暗面)的多模态开源权重模型 Kimi K3 现已通过 Amazon Bedrock 提供印度本地推理,满足数据驻留要求,处理仅限 Mumbai 和 Hyderabad 区域(profile ID 为 in.moonshotai.kimi-k3)。
Kimi K3 是一个多模态、开放权重的基座模型(FM),其提供方 Moonshot AI 表示,该模型在发布时实现了前沿水平的编程和通用智能体能力。
除了全球和美国境内的推理之外,Amazon Bedrock 现在还支持 Kimi K3 在印度的本地推理:为有严格数据驻留要求的本地工作负载扫清障碍。像 Ultrahuman 这样的客户已经在生产环境中看到了收益:
“Jade 是 Ultrahuman 应用中的 AI 健康与养生助手,它使用每个人的 Ring 和血糖数据,以通俗易懂的语言回答问题,每天处理超过 14,000 次对话。Amazon Bedrock 上的 Kimi K3 让我们能够通过已经在使用的 API 接入一个领先的开放权重模型,同时健康数据保留在 AWS 内部,并以孟买作为后备区域。借助提示词缓存,我们将 LLM 成本降低了 80%,并让多轮对话速度提升了 85%。”
—— Aditya Patawari,Ultrahuman 工程副总裁
在本文中,我们将解释可用的各种全球和地理推理选项,并分享一个示例用例的代码:对印度语系文档进行光学字符识别(OCR)和理解,并以印地语和英语混合(Hinglish)进行后续问答。
选择推理可以运行的位置
Amazon Bedrock 上的 Kimi K3 通过跨区域推理配置文件提供。您可以从广泛的 AWS 区域(“源区域”)中的任意一个调用该模型。然后,Amazon Bedrock 会在多个可能的“目标”区域之一中安全地处理您的请求。
跨区域推理完全由 AWS 托管:数据在区域之间的传输过程中经过加密,并保留在 AWS 网络内,绝不会经过公共互联网,也无需您设置任何多区域虚拟私有云(VPC)基础设施。
您调用的推理配置文件 ID 决定了哪些目标区域是符合条件的:
| 配置文件 | 模型 ID | 何时选择它 |
| 全球 | global.moonshotai.kimi-k3 |
推荐用于大多数用例:成本最低且可用范围最广 |
| 印度地理区域 | in.moonshotai.kimi-k3 |
推理处理必须保留在孟买和海得拉巴区域内 |
请参阅 Amazon Bedrock Kimi K3 模型卡片,获取有关可用推理配置文件、可以从哪些 AWS 区域调用它们,以及它们可以使用哪些目标区域进行推理的最新信息。
示例演练:印度语系文档理解
让我们来看一个示例用例:读取一份扫描的印地语文档,提取结构化数据,并以印地语和英语混合(Hinglish)回答后续问题。
这种需求在印度金融服务和公共部门工作流程中很常见,这些流程中的“了解你的客户”(KYC)表格、水电账单和类似文档通常需要数字化。Amazon Bedrock 上的 Kimi K3 可以直接读取和推理图像,包括包含多语言文本的图像。它提供了一种无需单独 OCR 或翻译服务的潜在解决方案。
前提条件
此示例的完整源代码可在 GitHub 上获取。
要跟随操作,您需要:
- 一个 AWS 账户。
- 已安装 Python 3.11 或更高版本,并且可以访问互联网以安装所需的 PyPI 软件包。
- 已安装 AWS 命令行界面(AWS CLI),并配置了具有足够 凭据和 AWS Identity and Access Management (IAM) 权限的账户,以便通过印度推理配置文件调用 Kimi K3 模型。
例如,要通过 ap-south-1 孟买区域并使用印度地理推理来使用 Kimi K3,以下 IAM 策略可授予足够的访问权限。将 {ACCOUNT_ID} 占位符替换为您的 AWS 账户 ID:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "BedrockCallWithBearerToken",
      "Effect": "Allow",
      "Action": ["bedrock:CallWithBearerToken"],
      "Resource": ["*"]
    },
    {
      "Sid": "BedrockKimiK3India",
      "Effect": "Allow",
      "Action": [
        "bedrock:InvokeModel",
        "bedrock:InvokeModelWithResponseStream"
      ],
      "Resource": [
        "arn:aws:bedrock:ap-south-1::foundation-model/moonshotai.kimi-k3",
        "arn:aws:bedrock:ap-south-2::foundation-model/moonshotai.kimi-k3",
        "arn:aws:bedrock:ap-south-1:{ACCOUNT_ID}:inference-profile/in.moonshotai.kimi-k3",
        "arn:aws:bedrock:ap-south-1:{ACCOUNT_ID}:project/default"
      ]
    }
  ]
}
有关权限的更多信息,请参阅 Amazon Bedrock 用户指南中的 运行模型推理的前提条件 。如果您的组织限制了 AWS 区域,请让管理员审阅 地理跨区域推理的 IAM 与 SCP 指南。保持源区域处于允许状态,并允许路由到两个印度目标区域,必要时使用基于配置文件(profile)范围的例外。 Responses API 指南还描述了所需的默认项目访问权限。
开始使用推理 API
正如 模型卡片中详细说明的,Amazon Bedrock 支持多种 API 来调用 Kimi K3,全部通过 Bedrock Runtime 端点:
| API | 请求与响应格式 |
| Chat Completions | OpenAI 兼容的 messages 输入和助手消息输出。 |
| Responses | OpenAI 兼容的输入和结构化输出条目。 |
| Converse | 在受支持模型之间标准化的消息、内容块和推理参数。 |
| InvokeModel | 模型特定的 JSON 请求与响应体。 |
由于本模型推荐使用 OpenAI 兼容的 API,我们在本示例中使用这些 API,并通过 openai Python 库进行连接。
Amazon Bedrock 支持为需要它们的集成 生成 API 密钥。不过,AWS 建议尽可能 改用短期凭证。 AWS token generator Python 库可以从标准 AWS CLI 凭证链派生出类似 API 密钥的短期令牌。
如果您在 AWS CLI 中使用 命名配置文件(named profile),可能需要先设置 AWS_PROFILE 环境变量。设置好 CLI 凭证后,即可使用以下代码调用模型:
from aws_bedrock_token_generator import provide_token
from openai import OpenAI

region = "ap-south-1"
model_id = "in.moonshotai.kimi-k3"

client = OpenAI(
    base_url=f"https://bedrock-runtime.{region}.amazonaws.com/openai/v1",
    api_key=provide_token(region=region),
)

response = client.chat.completions.create(
    model=model_id,
    messages=[{
        "role": "user",
        "content": "Classify this ticket as billing, technical, or account: I was charged twice."
    }],
    max_completion_tokens=2048,
)

print(response.choices[0].message.content)
这里, region(ap-south-1 孟买)指定了请求发送到的源区域。推理配置文件 in.moonshotai.kimi-k3 确保推理仅在印度区域内处理。
流式传输、工具调用和结构化输出等一系列广泛的功能在 Chat Completions 和 Responses 两种 API 中均受支持。更多示例请参阅 OpenAI Python API 参考。
分析图像
Amazon Bedrock 上的 Kimi K3 支持图像以及 PDF 和多种其他文件类型。您可以通过 base64 编码直接将输入文件发送给模型。对于 OCR 或其他对细节要求较高的用例,可考虑将图像的 detail 参数设置为 high。这可以提高准确性,但代价是每张图像消耗更多输入令牌。
在某些情况下,当图像在文本输入之前提供时,我们观察到 Kimi K3 的输出质量更高。我们建议对请求顺序进行实验。请看以下示例代码:
from base64 import b64encode

image_path = "sample_data/electricity_bill_hi.png"
with open(image_path, "rb") as f:
    image_base64 = b64encode(f.read()).decode("ascii")

response = client.chat.completions.create(
    model=model_id,
    messages=[
        {
            "role": "user",
            "content": [
                # The model card recommends placing images before text:
                {
                    "type": "image_url",
                    "image_url": {
                        "url": f"data:image/png;base64,{image_base64}",
                        "detail": "high"
                    }
                },
                {"type": "text", "text": QUESTION_PROMPT},
            ]
        },
    ],
    max_completion_tokens=16384,
)

print(response.choices[0].message.content)
为了演示,我们生成了一张印地语的合成电费账单图像。
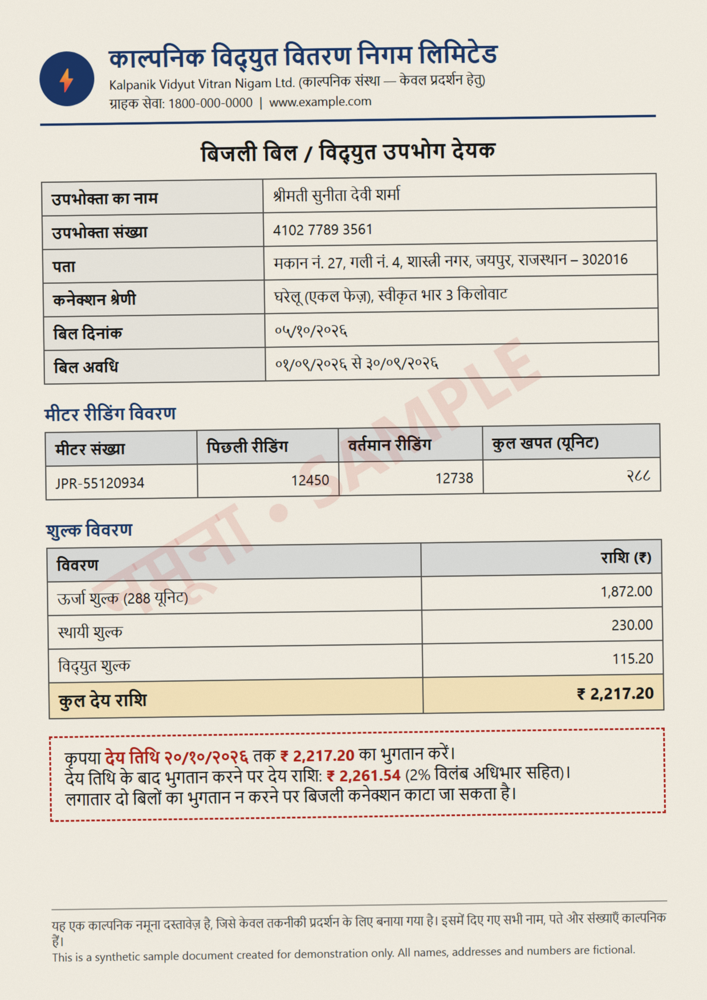
图 1:示例中的合成印地语电费账单(所有示例文档均为虚构)
给定此图像输入,模型可以直接从文档中提取数据来回答问题,无需单独的数字化步骤。例如:
问:Bill kitne ka hai aur last date kab hai? Late hua toh kitna dena padega?
答:Bill ka total ₹2,217.20 hai, aur last date 20/10/2026 hai. Late hua toh ₹2,261.54 dena padega.
除了通用问答之外,你还可以通过使用静态提示词,在许多文档中提取一组一致的预期字段,从而构建结构化的文档处理工作流。
要对输出结构施加严格约束(而不是尽力而为的提示词引导生成),Kimi K3 在 Amazon Bedrock 上支持结构化输出,既可以通过函数调用,也可以通过提供 JSON Schema 输出格式来实现。这些选项在 OpenAI 文档(针对 OpenAI 兼容的 API)和 Amazon Bedrock 用户指南(针对原生 Converse/InvokeModel API)中有更详细的描述。
在完整的示例代码仓库中,我们提供了一个端到端的流水线,它可以:
- 以原始文字转写文档(OCR)。
- 使用可配置的模式(schema)提取关键字段为 JSON,其中日期规范化为 ISO 8601(
YYYY-MM-DD),天城文数字(例如 २८८)转换为西方数字(288),姓名转写为英文。 - 撰写一段简短的英文摘要。
- 用印地英语(Hinglish,用拉丁字母书写的印地语,混合英语)就同一文档回答多轮追问。
对于前图中的同一份合成印地语电费账单,流水线返回的结构化字段如下(已缩略):
{
  "consumer_name": "श्रीमती सुनीता देवी शर्मा",
  "consumer_name_english": "Smt. Sunita Devi Sharma",
  "consumer_number": "410277893561",
  "billing_period": "2026-09-01 to 2026-09-30",
  "due_date": "2026-10-20",
  "units_consumed_kwh": 288,
  "amount_due_inr": 2217.20,
  "amount_after_due_date_inr": 2261.54
}
我们还提供了一个 KYC 表单示例和一个开放式的 无模式 模式,即由模型自行选择对任何其他文档类型最有用的字段。所有提供的示例文档均为合成的,使用了虚构的姓名和地址,并对身份号码进行了遮盖。
下载 GitHub 上的示例代码以进一步探索,并在你自己的图像上试用。
与任何自动化提取一样,在依赖输出做出重要决策之前,你应该验证这些输出对你的特定用例是否可靠。对于关键工作流,可以考虑添加后验证逻辑或人工审核步骤。
优化性价比、服务层级与缓存
针对示例文档调整你的系统提示词和模式,以实现可靠的提取。Amazon Bedrock 高级提示词优化(AdvPO)提供了一种完全托管的方式来基于参考示例优化提示词模板。
Amazon Bedrock 服务层级让你可以按请求控制性价比。对于延迟不太敏感的场景,你可以选择 flex 层级,享受默认标准定价 5 折(50% 折扣)的优惠。对于延迟关键的场景,你可以选择“priority”,以更高的价格请求更高的队列优先级。详情请参阅定价页面。
输入提示词中包含长且很少变化的内容的用例,也可以从 Amazon Bedrock 上的提示词缓存中受益。请确保静态内容(系统提示词、工具描述等)出现在输入的开头,位于当前图像和问题等动态部分之前。
Amazon Bedrock 上的 Kimi K3 既支持缓存命中的折扣定价,也支持显式缓存模式。在默认的隐式缓存模式下,服务会自动尝试在请求之间缓存并重用重复的提示词前缀,无需用户执行任何操作。不过,你可以通过选择显式模式并在输入中指定可缓存内容的“断点”来提升性能,从而提高缓存命中率、响应速度并节省成本。
以下示例展示了如何通过 Responses API 进行显式提示词缓存。更多信息请参阅 Amazon Bedrock 用户指南中的提示词缓存:
for call in (1, 2):
    response = client.responses.create(
        model=model_id, max_output_tokens=2048, store=False,
        input=[
            {"type": "message", "role": "system", "content": [{
                "type": "input_text", "text": static_prefix,
                "prompt_cache_breakpoint": {"mode": "explicit"},
            }]},
            {"type": "message", "role": "user", "content": [{
                "type": "input_text", "text": dynamic_prompt,
            }]},
        ],
        extra_body={"prompt_cache_options": {"mode": "explicit"}},
    )
    print(call, response.usage.input_tokens_details.cached_tokens)
监控使用情况
Amazon CloudWatch 会在 AWS/Bedrock 命名空间下自动为 Kimi K3 生成指标,让您能够查看调用速率、token 数量、缓存使用情况、延迟、错误和节流情况。
模型调用日志记录为可选功能,可以选择包含提示词和输出。启用前请先审查访问权限、保留期限和存储位置设置。
无论哪个目标区域可能在跨区域推理中处理了请求,日志和指标都存储在您提交请求的源区域中。您可以选择启用 AWS CloudTrail 数据事件日志记录,在 CloudTrail 中记录模型调用,它会将请求的目标区域记录为 additionalEventData.inferenceRegion 字段。
清理
Kimi K3 按 token 计费,因此这些代码示例不会预配任何需要清理的持久性 AWS 资源。如果您为了体验而创建了新的 IAM 角色或用户,或者为现有的用户/角色添加了额外权限,请记得在完成后将其删除。
结论和后续步骤
在这篇文章中,我们探讨了 Amazon Bedrock 上的 Kimi K3 如何提供按需智能,能够理解印度语系与英语混合的语言。它现在通过 in.moonshotai.kimi-k3 推理配置文件支持在印度境内(AWS 孟买和海得拉巴区域)进行完整的数据处理。
欢迎今天就在 Amazon Bedrock 控制台或通过推理 API 进行体验。查看模型卡片了解更多信息,并访问 AWS re:Post 寻找答案或向社区咨询 Amazon Bedrock 相关问题。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com