OpenFold3 登陆 Amazon SageMaker JumpStart:预测生物分子结构
OpenFold3 on Amazon SageMaker JumpStart: Predict biomolecular structures
OpenFold Consortium 与哥伦比亚大学 AlQuraishi Lab 开发的开源生物分子结构预测模型 OpenFold3-preview(版本 OpenFold3 0.4.1,of3-p2-155k checkpoint,Apache 2.0 许可)现可从 Amazon SageMaker JumpStart 部署。
您可以从 Amazon SageMaker JumpStart 部署 OpenFold3-preview。OpenFold 联盟和哥伦比亚大学的 AlQuraishi 实验室将 OpenFold3 开发为开源生物分子结构预测模型。只需几行代码,您通常就能将 OpenFold3 部署到自己的 AWS 账户中。随后您可以预测蛋白质、DNA、RNA、小分子配体的 3D 结构以及它们形成的复合物。该终端节点以网络隔离方式运行,可帮助您将序列数据保留在自己的 AWS 账户内。
如今,计算药物研发团队已将结构预测作为其工作的核心部分。团队将其用于靶点识别、抗体和蛋白质工程,以及基于结构的虚拟筛选。团队发现运行这些模型颇具挑战:需要 GPU 基础设施、可用的 CUDA 和 PyTorch 技术栈、大型模型检查点,以及一个能处理需要数分钟而非数毫秒才能完成的请求的服务层。SageMaker JumpStart 可为您完成其中大部分工作。OpenFold3 运行在托管 Amazon SageMaker AI 终端节点上由 AWS 维护的容器中。该终端节点专为处理请求排队和 GPU 预热而设计,并且您可以添加自动扩缩。
在这篇文章中,我们将向您展示如何:
- 在 SageMaker 异步推理终端节点上部署 OpenFold3-preview。
- 提交结构预测任务并解读结果,包括预测结构和置信度分数。
- 在多 GPU 实例上并行运行多个预测。
- 提供您自己的多序列比对(MSA)以提高预测准确性,同时帮助保护您的序列隐私。
- 在终端节点空闲时通过将终端节点扩缩至零来帮助降低成本。
OpenFold3 概述
OpenFold3 是一个全原子结构预测模型。它根据一组分子的序列预测它们的联合 3D 结构。它不局限于单条蛋白质链:它可以在一次预测中折叠多链蛋白质复合物、蛋白质–核酸组装体以及蛋白质–配体复合物。
| 属性 | 详细信息 |
| 开发者 | OpenFold 联盟 / 哥伦比亚大学 AlQuraishi 实验室 |
| 模型类型 | 全原子生物分子结构预测 |
| 输入 | 蛋白质、DNA 和 RNA 序列;小分子配体以 SMILES 表示 |
| 输出 | mmCIF 格式的预测结构,附带置信度指标(pLDDT、PAE、PDE) |
| 版本 | OpenFold3 0.4.1,of3-p2-155k 检查点 |
| 许可证 | Apache 2.0 |
| JumpStart 模型 ID | huggingface-proteinfolding-openfold3 |
| 支持的实例 | ml.g6.2xlarge、ml.g6.4xlarge(默认)、ml.g6.12xlarge |
OpenFold3 的开发者在 Apache 2.0 许可证下发布其代码和模型权重,并公开训练数据和方法。研究机构和制药公司可以在该许可条款下检查模型、对其进行微调并在此基础上进行构建。开发者将 OpenFold3-preview 描述为研究预览版。
用例
- 靶点与复合物结构预测 – 为没有实验结构的靶点预测结构,包括多链组装体和蛋白质–核酸复合物。
- 蛋白质–配体共同折叠 – 将蛋白质与以 SMILES 提供的小分子一起折叠,为基于结构的设计生成结合姿态假设。
- 抗体和蛋白质工程 – 通过预测设计变体的结构并比较各候选的置信度来进行评估。
- 高通量筛选流水线 – 针对自动扩缩端点排队大批量预测任务,并直接从 Amazon Simple Storage Service (Amazon S3) 处理结果。
为什么 OpenFold3 使用异步推理
大多数 JumpStart 模型(例如大语言模型和嵌入模型)部署到实时端点。实时端点在单个请求内返回响应,且该请求的上限为 60 秒。结构预测的工作方式不同。折叠时间随查询中链条的数量和长度而增长,而现实中的蛋白质和复合物往往需要几分钟。
因此,JumpStart 上的 OpenFold3 运行在 SageMaker 异步推理上:
- 你将请求上传到 Amazon S3 并调用
InvokeEndpointAsync,它会立即返回。 - 端点将请求排队并处理,调用超时最长可达 1 小时。
- 端点将结果或错误详情写入你选择的 S3 位置。你可以轮询该位置,或通过 Amazon Simple Notification Service (Amazon SNS) 获取通知。
异步端点的两个特性特别适合科学工作负载。第一,它们在内部对突发的请求进行排队,因此你可以提交大批量序列而无需自行构建任务队列。第二,当队列为空时,它们可以缩容到零个实例,这有助于你避免在实验间隙为空闲实例付费。
先决条件
要按照本演练操作,你需要:
- 一个 AWS 账户,以及用于端点的 SageMaker AI 执行角色。遵循最小权限原则,此 AWS Identity and Access Management (IAM) 角色只需对你用于请求和结果的 S3 前缀具有读写访问权限。更多信息请参阅 如何使用 SageMaker AI 执行角色。
- 运行代码的身份所需的 IAM 权限:创建、描述、调用和删除模型、端点配置和端点,以及为执行角色附加
iam:PassRole。对于可选的缩容到零部分,还需要 AWS Application Auto Scaling 和 Amazon CloudWatch 警报权限。在生产环境中,请将这些权限限定到你的资源,而不是使用AmazonSageMakerFullAccess这样的宽泛托管策略。更多信息请参阅异步推理的 完成先决条件。 - 访问 Amazon SageMaker Studio、SageMaker 笔记本实例或本地 IDE。
- SageMaker Python SDK v3 和 py3Dmol,可通过
pip install "sagemaker>=3,<4" py3Dmol安装。 - 在您的 AWS 区域内至少一个
ml.g6.4xlarge端点实例的服务配额。如果你按照多 GPU 部分操作,还需要ml.g6.12xlarge的配额。你可以在 Amazon SageMaker 下的服务配额控制台中查看配额并申请提升。
重要提示:SageMaker 端点在运行期间按实例小时计费,包括空闲时间。为避免意外费用,请遵循清理部分,或按本文后面所述配置缩容到零。定价详情请参阅 Amazon SageMaker AI 定价。
在 SageMaker JumpStart 中查找 OpenFold3
- 打开 SageMaker Studio,并在导航窗格中选择 JumpStart。
- 搜索 OpenFold3。
- 打开模型卡片,查看模型描述、许可证和支持的实例类型。
- 从模型卡中打开示例笔记本。它包含本文展示的完整异步部署流程。
使用 SageMaker Python SDK 部署 OpenFold3
首先,根据 JumpStart 配置构建模型,并定义一个 AsyncInferenceConfig。输出路径和失败路径是端点写入结果和错误详情的 S3 位置。
import json, time, uuid
import boto3
from sagemaker.core.helper.session_helper import Session
from sagemaker.core.inference_config import AsyncInferenceConfig
from sagemaker.core.jumpstart.configs import JumpStartConfig
from sagemaker.core.training.configs import Compute
from sagemaker.serve.model_builder import ModelBuilder

session = Session()
bucket = session.default_bucket()          # sagemaker-{region}-{account-id}
prefix = "openfold3-async"

model_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=JumpStartConfig(
        model_id="huggingface-proteinfolding-openfold3",
        accept_eula=True,
    ),
    compute=Compute(instance_type="ml.g6.4xlarge"),
)
model = model_builder.build()

async_config = AsyncInferenceConfig(
    output_path=f"s3://{bucket}/{prefix}/output",
    failure_path=f"s3://{bucket}/{prefix}/failure",
)

endpoint = model_builder.deploy(inference_config=async_config)
endpoint_name = endpoint.endpoint_name
print(f"Deployed asynchronous endpoint: {endpoint_name}")
设置 accept_eula=True 表示你已查看并接受模型的许可条款,这是部署该模型所必需的。如果你在 SageMaker Studio 之外运行此代码,还需通过 role_arn="<role-arn>" 将你的 SageMaker 执行角色传递给 ModelBuilder.from_jumpstart_config。
端点将你的请求和结果存储在 Amazon S3 中,其中包含你的序列和预测结构。对于专有序列,请考虑使用专用 S3 存储桶或前缀,并通过你自行管理的 AWS Key Management Service (AWS KMS) 密钥进行服务器端加密。要使用你的密钥加密结果,请将其 ARN 以 kms_key_id 的形式传递给 AsyncInferenceConfig。通过存储桶策略限制访问,只允许运行此工作流的角色访问,并添加 S3 生命周期规则来过期你不需要保留的请求和结果对象。更多信息请参阅 Amazon S3 安全最佳实践。
部署通常在几分钟内完成。其中包括一个预热步骤,容器会在每个 GPU 上运行一次短预测,以便在端点达到 InService 时 GPU 已经完成预热。
提示:在某些区域,G6 容量可能有限。如果部署因
InsufficientInstanceCapacity而失败,请稍后重试、选择其他受支持的实例规格,或在模型可用的其他 AWS 区域进行部署。
运行结构预测
请求是一个 JSON 文档,包含一个或多个命名的查询(query),每个查询列出其链(chain)。一个查询中的所有链会作为一个复合体一起折叠。不同的查询则独立折叠。
每条链包含以下字段:
molecule_type–protein、dna、rna或ligand。chain_ids– 链标识符列表,例如["A"]。要指定相同的副本(例如同源二聚体),请使用["A", "B"]。sequence– 残基序列,用于蛋白质、DNA 和 RNA 链。smiles– SMILES 字符串,用于配体链,代替sequence。
以下示例折叠人泛素(ubiquitin),这是一种已被充分表征的 76 残基蛋白质:
s3 = boto3.client("s3")
smr = boto3.client("sagemaker-runtime")

payload = {
    "queries": {
        "ubiquitin": {
            "chains": [
                {
                    "molecule_type": "protein",
                    "chain_ids": ["A"],
                    "sequence": "MQIFVKTLTGKTITLEVEPSDTIENVKAKIQDKEGIPPDQQRLIFAGKQLEDGRTLSDYNIQKESTLHLVLRLRGG",
                }
            ]
        }
    }
}

# 1. Stage the request in S3
input_key = f"{prefix}/input/{uuid.uuid4().hex}.json"
s3.put_object(Bucket=bucket, Key=input_key, Body=json.dumps(payload).encode())

# 2. Submit asynchronously -- returns immediately
resp = smr.invoke_endpoint_async(
    EndpointName=endpoint_name,
    ContentType="application/json",
    InputLocation=f"s3://{bucket}/{input_key}",
    InvocationTimeoutSeconds=3600,
)
output_location, failure_location = resp["OutputLocation"], resp["FailureLocation"]
然后轮询 S3 以获取结果或失败记录:
def split(uri):
    b, _, k = uri.removeprefix("s3://").partition("/")
    return b, k

result = None
for _ in range(120):                                    # up to ~30 minutes
    for loc, is_failure in ((output_location, False), (failure_location, True)):
        try:
            body = s3.get_object(Bucket=split(loc)[0], Key=split(loc)[1])["Body"].read()
        except s3.exceptions.NoSuchKey:
            continue
        if is_failure:
            raise RuntimeError(body.decode())
        result = json.loads(body)
    if result:
        break
    time.sleep(15)

if result is None:
    raise TimeoutError(f"No result yet; check {output_location}")
if result.get("status") == "error":
    raise RuntimeError(result["error"])
包含无效输入的请求(例如格式错误的链或不受支持的 MSA 名称)仍会生成结果对象,但其中是 "status": "error" 和一条 error 消息,而不是结构。最后的检查会显示该消息。
预测时间随输入规模增长。在我们在 ml.g6.4xlarge 上的测试中,较小的蛋白质比较大的蛋白质完成得更快。
解读结果
响应包含一个 status、以 mmCIF 格式表示的预测 structures 列表,以及与之匹配的 confidences。默认情况下,OpenFold3 会为每个查询生成五个扩散样本,因此每个查询返回五个候选结构。每个样本附带两个置信度文件:一个详细文件(*_confidences.json)和一个摘要文件(*_confidences_aggregated.json)。摘要中包含一个 sample_ranking_score,可用于挑选最佳样本。
import os
os.makedirs("structures", exist_ok=True)
for s in result["structures"]:
    path = os.path.join("structures", os.path.basename(s["filename"]))
    with open(path, "w") as f:
        f.write(s["content"])
    print("saved", path, f'({s["size_bytes"]/1024:.0f} KB)')

summaries = {c["filename"]: c["data"] for c in result["confidences"]
             if c["filename"].endswith("_aggregated.json")}
for name, m in sorted(summaries.items(), key=lambda kv: -kv[1]["sample_ranking_score"]):
    print(f'{name}: ranking={m["sample_ranking_score"]:.2f} pLDDT={m["avg_plddt"]:.1f} '
          f'pTM={m["ptm"]:.2f} ipTM={m["iptm"]:.2f}')
你可以在任何结构查看器中打开 .cif 文件,例如 PyMOL、ChimeraX 或 Mol*。要在笔记本中内联查看结构,请使用 py3Dmol:
import py3Dmol   # pip install py3Dmol
view = py3Dmol.view(width=600, height=450)
view.addModel(result["structures"][0]["content"], "cif")
# pLDDT is stored in the B-factor field: red = low confidence, blue = high
view.setStyle({"cartoon": {"colorscheme": {"prop": "b", "gradient": "roygb", "min": 50, "max": 90}}})
view.zoomTo(); view.show()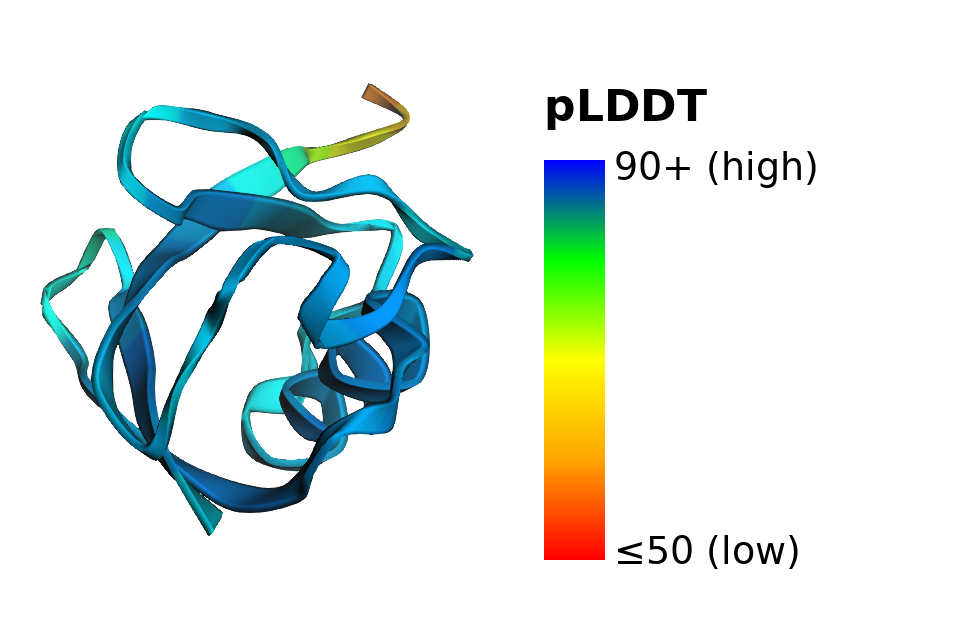
图 1:OpenFold3 预测的泛素结构,使用前面的代码渲染,并按逐原子置信度 (pLDDT) 着色。本文中的所有插图均使用 3Dmol.js 渲染(Rego 和 Koes,Bioinformatics, 2015)。
预测结果显示了泛素的紧凑折叠:一个混合 β 折叠片堆积在单个 α 螺旋上。结构的大部分是蓝色(高置信度)。只有图像顶部的柔性 C 端尾部偏向黄色和红色,这与实验结构中该尾部已知的柔韧性相符。
置信度指标告诉你应该在多大程度上信任每个预测:
- pLDDT(预测的局部距离差异测试)——对局部结构的逐原子置信度,范围为 0–100。数值越高越好,约 70 以上的数值通常表示局部结构可靠。摘要文件将平均值报告为
avg_plddt。 - pTM 和 ipTM(预测的 TM 分数和界面 pTM)——对整体折叠的置信度,以及对各链和配体彼此相对位置的置信度,范围为 0–1。对于复合物,ipTM 是关键数值。摘要文件还会报告每对链的
chain_pair_iptm。 - PAE(预测的对齐误差)和 PDE(预测的距离误差)——逐残基对的误差估计,位于详细置信度文件中。用它们来判断结构域和链的相对位置。
折叠一个复合物
要预测一个复合物,请在同一个查询中列出多条链。以下示例将人类碳酸酐酶 II 与其催化锌离子以及药物乙酰唑胺共同折叠。这是一个被充分研究的复合物,在蛋白质数据库(Protein Data Bank)中有实验结构(例如 PDB 3HS4):
ca2_sequence = (
    "MSHHWGYGKHNGPEHWHKDFPIAKGERQSPVDIDTHTAKYDPSLKPLSVSYDQATSLRILNNGHAFNVEFDDSQDKAVLKGG"
    "PLDGTYRLIQFHFHWGSLDGQGSEHTVDKKKYAAELHLVHWNTKYGDFGKAVQQPDGLAVLGIFLKVGSAKPGLQKVVDVLDS"
    "IKTKGKSADFTNFDPRGLLPESLDYWTYPGSLTTPPLLECVTWIVLKEPISVSSEQVLKFRKLNFNGEGEPEELMVDNWRPAQ"
    "PLKNRQIKASFK"
)

payload = {
    "queries": {
        "ca2_acetazolamide": {
            "chains": [
                {"molecule_type": "protein", "chain_ids": ["A"], "sequence": ca2_sequence},
                {"molecule_type": "ligand",  "chain_ids": ["B"], "smiles": "[Zn+2]"},
                {"molecule_type": "ligand",  "chain_ids": ["C"], "smiles": "CC(=O)Nc1nnc(s1)S(=O)(=O)N"},
            ]
        }
    }
}
这些示例中的蛋白质序列来自 UniProt(P0CG48、P00918)。你提交和读取此请求的方式与泛素示例相同。对于这类复合物,预测质量在很大程度上取决于提供 MSA,接下来的章节将展示这一点。
在多 GPU 实例上并行运行预测
单个 OpenFold3 预测在一个 GPU 上运行,因此多 GPU 实例不会让单个预测变快。不过,你可以同时运行多个预测。在具有四个 GPU 的多 GPU 实例(如 ml.g6.12xlarge)上,容器会为每个并发请求分配各自的 GPU。要使用所有 GPU,请将 max_concurrent_invocations_per_instance 设置为实例上的 GPU 数量(对于 ml.g6.12xlarge 是四个):
multi_gpu_builder = ModelBuilder.from_jumpstart_config(
    jumpstart_config=JumpStartConfig(
        model_id="huggingface-proteinfolding-openfold3",
        accept_eula=True,
    ),
    compute=Compute(instance_type="ml.g6.12xlarge"),
)
multi_gpu_model = multi_gpu_builder.build()

async_config = AsyncInferenceConfig(
    output_path=f"s3://{bucket}/{prefix}/output",
    failure_path=f"s3://{bucket}/{prefix}/failure",
    max_concurrent_invocations_per_instance=4,   # = number of GPUs on the instance
)

multi_gpu_endpoint = multi_gpu_builder.deploy(inference_config=async_config)
这会创建第二个端点,所以完成后记得也将其删除(参见 清理)。
在我们的测试中,四个并发预测分别在不同的 GPU 上运行,吞吐量提升随蛋白质尺寸增大而增长。对于较大的蛋白质,我们基于按需实例定价在 ml.g6.12xlarge 上测得的每个预测成本接近 ml.g6.4xlarge。你的结果取决于你的输入和区域。有关定价,请参见 Amazon SageMaker AI pricing。
注意:
ml.g6.12xlarge容量可能有限。如果你的区域中不可用,你可以通过在多个ml.g6.4xlarge实例上横向扩展来提高吞吐量,使用本文稍后描述的自动扩缩配置。
使用下表来选择实例:
| 工作负载 | 推荐实例 | 原因 |
| 单用户的交互式探索 | ml.g6.2xlarge 或 ml.g6.4xlarge |
单个 GPU 一次处理一个预测,且是支持的实例中每小时成本最低的 |
| 团队使用或并发请求突增 | ml.g6.12xlarge 配合 max_concurrent_invocations_per_instance=4 |
四个预测并行运行,而不是排队 |
| 高通量筛选 | ml.g6.12xlarge 配合自动扩缩 |
支持的实例中每个实例吞吐量最高。根据队列深度横向扩展并回缩至零 |
使用你自己的 MSA 提高预测准确性
OpenFold3 可以将多序列比对(MSA)作为每条蛋白质链的额外输入。MSA 是一组与查询序列进化相关的序列的比对结果。这些序列之间的共变信息提示哪些残基可能相互接触,因此 MSA 可以显著提高许多蛋白质和复合物的预测精度。
为了帮助将你的序列保留在你的 AWS 账户内,JumpStart 端点在网络隔离环境下运行,不会调用外部 MSA 服务器。相反,它在请求中接受预先计算好的 MSA。你可以在自己控制的基础设施上,使用你现有的流程和序列数据库生成比对结果,然后传递给端点。这种设计有助于需要将专有序列保密的药物研发项目。
如果不提供 MSA,端点将仅基于序列进行预测。对于小而表征充分的蛋白质(如泛素),这可能效果很好。对于大多数真实世界的靶点和复合物,请提供 MSA。本节的其余部分将展示如何操作,以及它能带来多大的改进。
自带 MSA
每条蛋白质链都接受一个 precomputed_msa 字段:一个比对列表,每个比对包含一个 name 以及 A3M 或 Stockholm 格式的比对结果 content。对于单一合并比对(例如 ColabFold MMseqs2 搜索的输出),使用名称 colabfold_main:
with open("ca2_colabfold.a3m") as f:
    ca2_msa = f.read()

payload["queries"]["ca2_acetazolamide"]["chains"][0]["precomputed_msa"] = [
    {"name": "colabfold_main", "content": ca2_msa}
]
这个示例只有一条蛋白质链。如果查询包含多条不同的蛋白质链,请为每条链计算一个 MSA,并将其附加到该链的 precomputed_msa 字段。在同一个 chain_ids 条目下列出的相同拷贝(例如同源二聚体)共享同一个 MSA。
端点也接受其他比对名称,例如 uniref90_hits、mgnify_hits 和 bfd_uniclust_hits,前提是你使用不同的流程生成 MSA。由于请求会暂存在 S3 中,你可以发送大型比对结果。在我们的测试中,几兆字节的比对结果均可正常使用。
你可以使用 ColabFold(MMseqs2)、HHblits 或 JackHMMER 等工具生成 MSA。为了帮助将专有序列保留在你的环境中,请在自己的 AWS 基础设施上针对本地托管的序列数据库运行搜索,而不是将序列发送到公共服务器。例如,ColabFold 的 colabfold_batch 命令默认使用公共 ColabFold MSA 服务器,因此对于专有序列,请改用 colabfold_search 并配合本地托管的数据库。
MSA 能带来多大差异?
我们在同一个端点上对前一节的碳酸酐酶 II、锌离子和乙酰唑胺复合物进行了两次折叠预测:一次使用单序列模式,一次使用来自 ColabFold MMseqs2 搜索的 MSA。
| 指标(5 次采样中的第 1 次) | 无 MSA | 有 MSA |
| 平均 pLDDT | 30 | 98 |
| pTM | 0.22 | 0.98 |
| ipTM | 0.49 | 0.98 |
| 锌–His94/His96/His119 距离 | 2.3–9.4 Å | 均为 2.0 Å |
| 乙酰唑胺氮–锌距离 | 5.6 Å | 2.0 Å |
| 预测时间 | 约 1.5 分钟 | 约 1.5 分钟 |
使用 MSA 后,OpenFold3 恢复了已知的结合模式。锌离子由三个活性位点的组氨酸配位,乙酰唑胺的磺酰胺氮直接与锌结合,与实验结构一致。没有 MSA 时,蛋白质折叠置信度较低,结合位点无法形成。添加 MSA 没有明显改变预测时间。
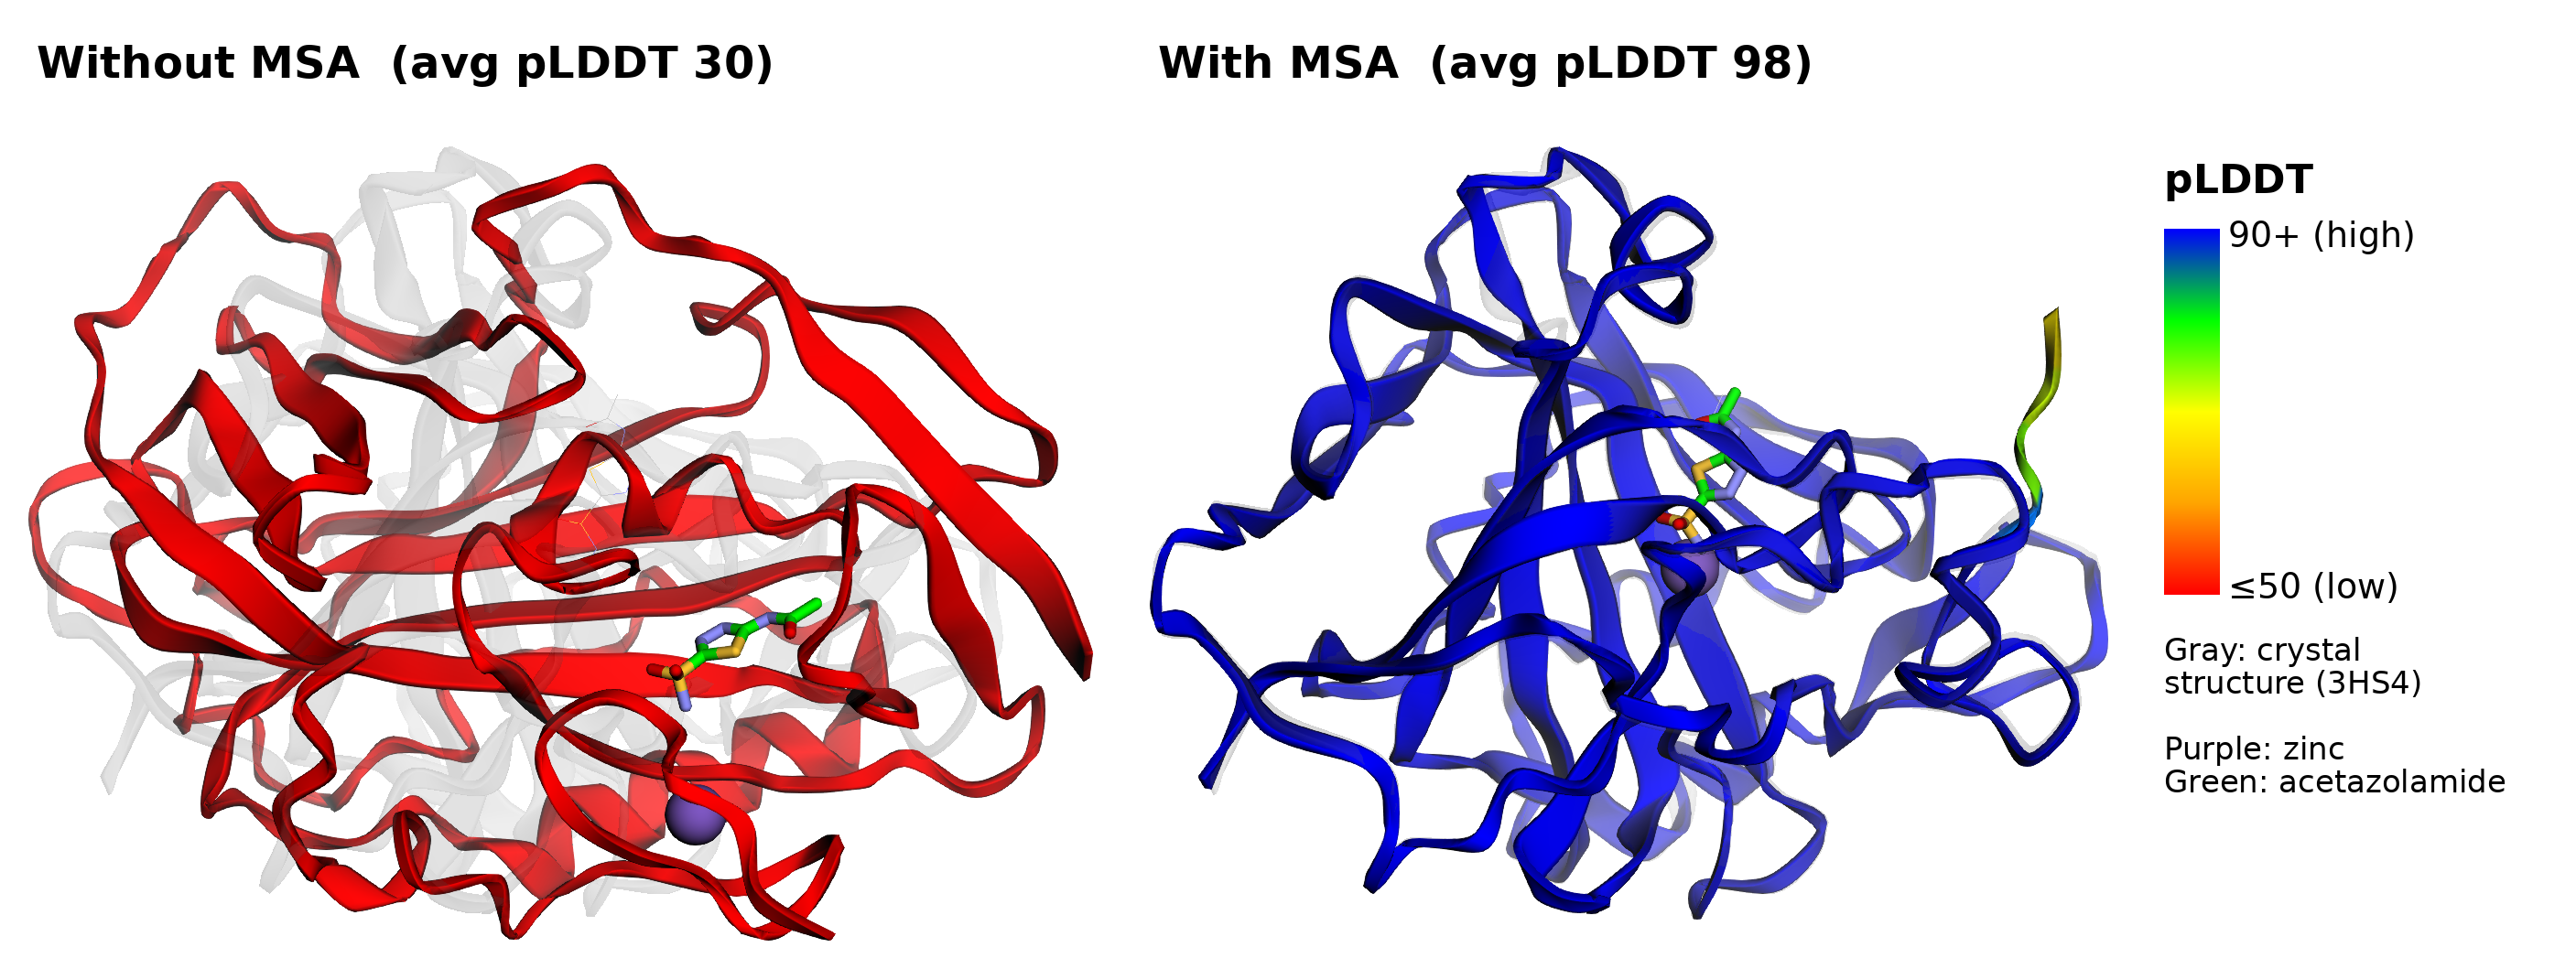
图 2:相同的碳酸酐酶 II、锌离子和乙酰唑胺查询,分别在不使用 MSA(左)和使用 MSA(右)的情况下折叠。每次预测按 pLDDT 着色,并与实验晶体结构(灰色,PDB 3HS4;Sippel 等,2009)叠加。
将基于 MSA 的预测叠加在晶体结构上,两者高度吻合:蛋白质主链偏差为 0.2 Å(Cα RMSD),锌离子偏差小于 0.1 Å,乙酰唑胺的重原子 RMSD 偏差为 0.4 Å。而单序列预测则是错误折叠的,Cα RMSD 达 22 Å。
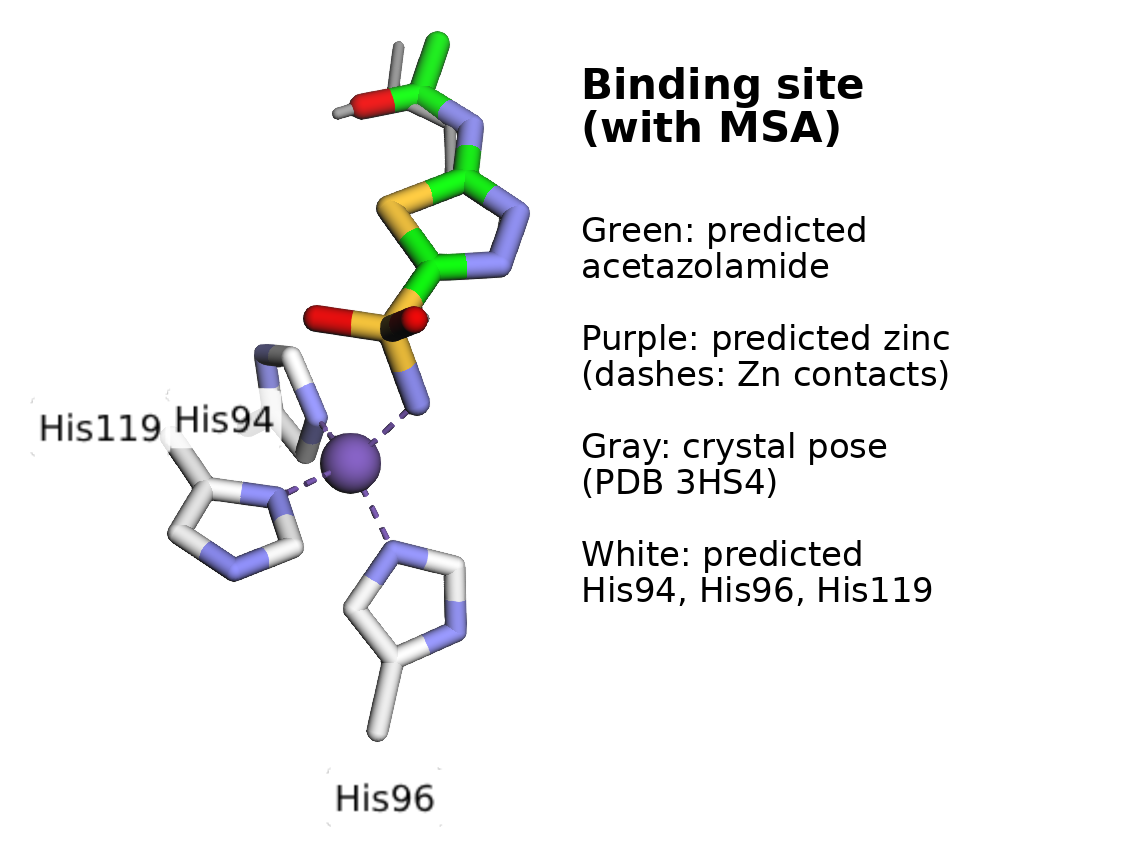
图 3:基于 MSA 的预测中结合位点的特写。预测的锌离子(紫色)由 His94、His96、His119 以及乙酰唑胺(绿色)的磺酰胺氮原子配位。晶体构象(灰色)几乎完全被预测结果遮住。
碳酸酐酶 II 与乙酰唑胺的复合物是蛋白质数据库(Protein Data Bank)中被研究得最为深入的复合物之一,而密切相关的结构很可能包含在 OpenFold3 的训练数据中。请将此示例视为对工作流程以及 MSA 重要性的演示,而非对新颖靶标准确性的基准测试。
当你将 OpenFold3 的结果与其他工具或已发表的基准进行比较时,应同类比较:单序列结果与单序列结果比较,基于 MSA 的结果与基于 MSA 的结果比较。
帮助降低成本:空闲时缩容至零
当没有请求排队时,异步端点可以缩容至 零实例,并在新请求到达时重新扩容。这种模式适合结构预测工作,因为这类工作通常以突发方式运行。
aas = boto3.client("application-autoscaling")
resource_id = f"endpoint/{endpoint_name}/variant/AllTraffic"

aas.register_scalable_target(
    ServiceNamespace="sagemaker",
    ResourceId=resource_id,
    ScalableDimension="sagemaker:variant:DesiredInstanceCount",
    MinCapacity=0,
    MaxCapacity=4,
)

# Scale out and in to keep about 4 queued requests per instance
aas.put_scaling_policy(
    PolicyName="openfold3-backlog",
    ServiceNamespace="sagemaker",
    ResourceId=resource_id,
    ScalableDimension="sagemaker:variant:DesiredInstanceCount",
    PolicyType="TargetTrackingScaling",
    TargetTrackingScalingPolicyConfiguration={
        "TargetValue": 4.0,
        "CustomizedMetricSpecification": {
            "MetricName": "ApproximateBacklogSizePerInstance",
            "Namespace": "AWS/SageMaker",
            "Dimensions": [{"Name": "EndpointName", "Value": endpoint_name}],
            "Statistic": "Average",
        },
        "ScaleInCooldown": 600,
        "ScaleOutCooldown": 300,
    },
)
目标跟踪会在队列空闲一段时间后将端点缩容至零。在我们的测试中,这大约需要 15–20 分钟。但是,目标跟踪不会将端点从零重新扩容。要在请求到达且没有实例运行时启动实例,请添加一个由 HasBacklogWithoutCapacity 指标触发的步进扩缩策略:
cw = boto3.client("cloudwatch")

step = aas.put_scaling_policy(
    PolicyName="openfold3-scale-from-zero",
    ServiceNamespace="sagemaker",
    ResourceId=resource_id,
    ScalableDimension="sagemaker:variant:DesiredInstanceCount",
    PolicyType="StepScaling",
    StepScalingPolicyConfiguration={
        "AdjustmentType": "ChangeInCapacity",
        "MetricAggregationType": "Average",
        "Cooldown": 300,
        "StepAdjustments": [{"MetricIntervalLowerBound": 0, "ScalingAdjustment": 1}],
    },
)

cw.put_metric_alarm(
    AlarmName=f"{endpoint_name}-has-backlog-without-capacity",
    Namespace="AWS/SageMaker",
    MetricName="HasBacklogWithoutCapacity",
    Dimensions=[{"Name": "EndpointName", "Value": endpoint_name}],
    Statistic="Average",
    Period=60,
    EvaluationPeriods=2,
    DatapointsToAlarm=2,
    Threshold=1,
    ComparisonOperator="GreaterThanOrEqualToThreshold",
    TreatMissingData="missing",
    AlarmActions=[step["PolicyARN"]],
)
当请求到达一个实例数为零的端点时,它会在实例启动期间在队列中等待。从零扩容后的第一个请求完成所需的时间会更长,因为它包括了警报触发、实例启动以及预测本身的时间。同一突发中的后续请求则以正常速度运行。这种权衡对批量工作负载来说效果很好。对于交互式使用,请设置 MinCapacity=1 以保持一个实例处于热备状态。更多详情,请参阅 对异步端点进行自动扩缩。
清理
为避免继续产生费用,请在完成后删除你创建的资源。如果你配置了自动扩缩,请先将其移除:删除 Amazon CloudWatch 警报,然后注销可扩缩目标。然后删除每个端点及其端点配置和模型,包括你部署的多 GPU 端点(如果有):
# 1. If you configured autoscaling, remove it before deleting the endpoint
cw.delete_alarms(AlarmNames=[f"{endpoint_name}-has-backlog-without-capacity"])
aas.deregister_scalable_target(
    ServiceNamespace="sagemaker",
    ResourceId=resource_id,
    ScalableDimension="sagemaker:variant:DesiredInstanceCount",
)

# 2. Delete the endpoints, endpoint configurations, and models
#    (include only the ones you deployed)
from sagemaker.core.resources import EndpointConfig

for m, ep in ((model, endpoint), (multi_gpu_model, multi_gpu_endpoint)):
    endpoint_config = EndpointConfig.get(endpoint_config_name=ep.endpoint_name)
    m.delete()
    ep.delete()
    endpoint_config.delete()
如果你不再需要请求和结果对象,也可以从 s3://<bucket>/openfold3-async/ 中将它们删除。
结语
借助 SageMaker JumpStart 上的 OpenFold3,研究和药物发现团队只需几行代码,就能在自己的 AWS 账户中部署一个开放、可审查的结构预测模型。异步推理可以处理长时间运行的折叠计算和突发性批量工作负载,多 GPU 实例可并行运行预测。网络隔离有助于保护专有序列的私密性,而且由于你可以自带 MSA,无需将序列发送到外部服务器即可享受 MSA 带来的好处。借助缩容至零功能,在队列空闲足够长的时间使端点完成缩容后,你就无需再为端点实例付费。其他费用(如 Amazon S3 存储费用)仍然适用。
本文中的代码仅供实验使用的示例代码。在将其用于专有或受监管数据之前,请与您的安全和法务团队合作,以满足您所在组织的安全、监管和合规要求。
要开始使用,请在 SageMaker JumpStart 中搜索 OpenFold3,或从模型卡打开示例笔记本。要了解本文中使用的功能的更多信息,请参阅 异步推理 和 自动扩缩异步终端节点。如需讨论您的结构生物学工作负载,请联系您的 AWS 客户团队。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com