SGLang-Neuron 正式可用,通过 AWS Deep Learning Container 在 Trainium 上部署模型
Deploy frontier AI models on AWS Trainium with SGLang-Neuron
Amazon 宣布 SGLang-Neuron 公开可用,由 RadixArk 与 Annapurna Labs 合作通过 AWS Deep Learning Container 发布,可在 AWS Trainium 上用熟悉的 SGLang 接口服务模型并生成 RL rollouts。
人工智能
今天,Amazon 宣布 SGLang-Neuron 正式公开可用,可通过 AWS Deep Learning Container 访问,由 RadixArk 与 Annapurna Labs 合作发布。借助 SGLang-Neuron,你可以在 AWS Trainium 上使用与你目前相同的 SGLang 接口来部署模型并生成强化学习(RL)rollout。Trainium 是 AWS 的 AI 芯片系列,可为大规模 AI 训练和推理提供出色的经济效益。现在,在 Trainium 上运行 SGLang 遵循你已熟悉的 SGLang 工作流程:你通过 SGLang 的服务器接口启动模型,并使用相同的生成 API 调用端点。在该接口之下,SGLang-Neuron 运行在原生 PyTorch 上。凭借树外插件设计,Trainium 支持与 SGLang 核心可以独立开发并更快迭代。
SGLang 如何在 Trainium 上运行
SGLang-Neuron 是一个连接 SGLang 与 AWS Trainium 的树外插件。安装该插件会通过 SGLang 的插件入口点注册 neuron 平台,并且设置 SGLANG_PLATFORM=neuron 会在服务器启动时选择该平台。SGLang 核心继续提供 API 服务器、请求生命周期、RadixAttention 以及前缀缓存簿记。该插件实现了 Trainium 特定的模型、注意力机制、专家混合(MoE)以及图运行器。
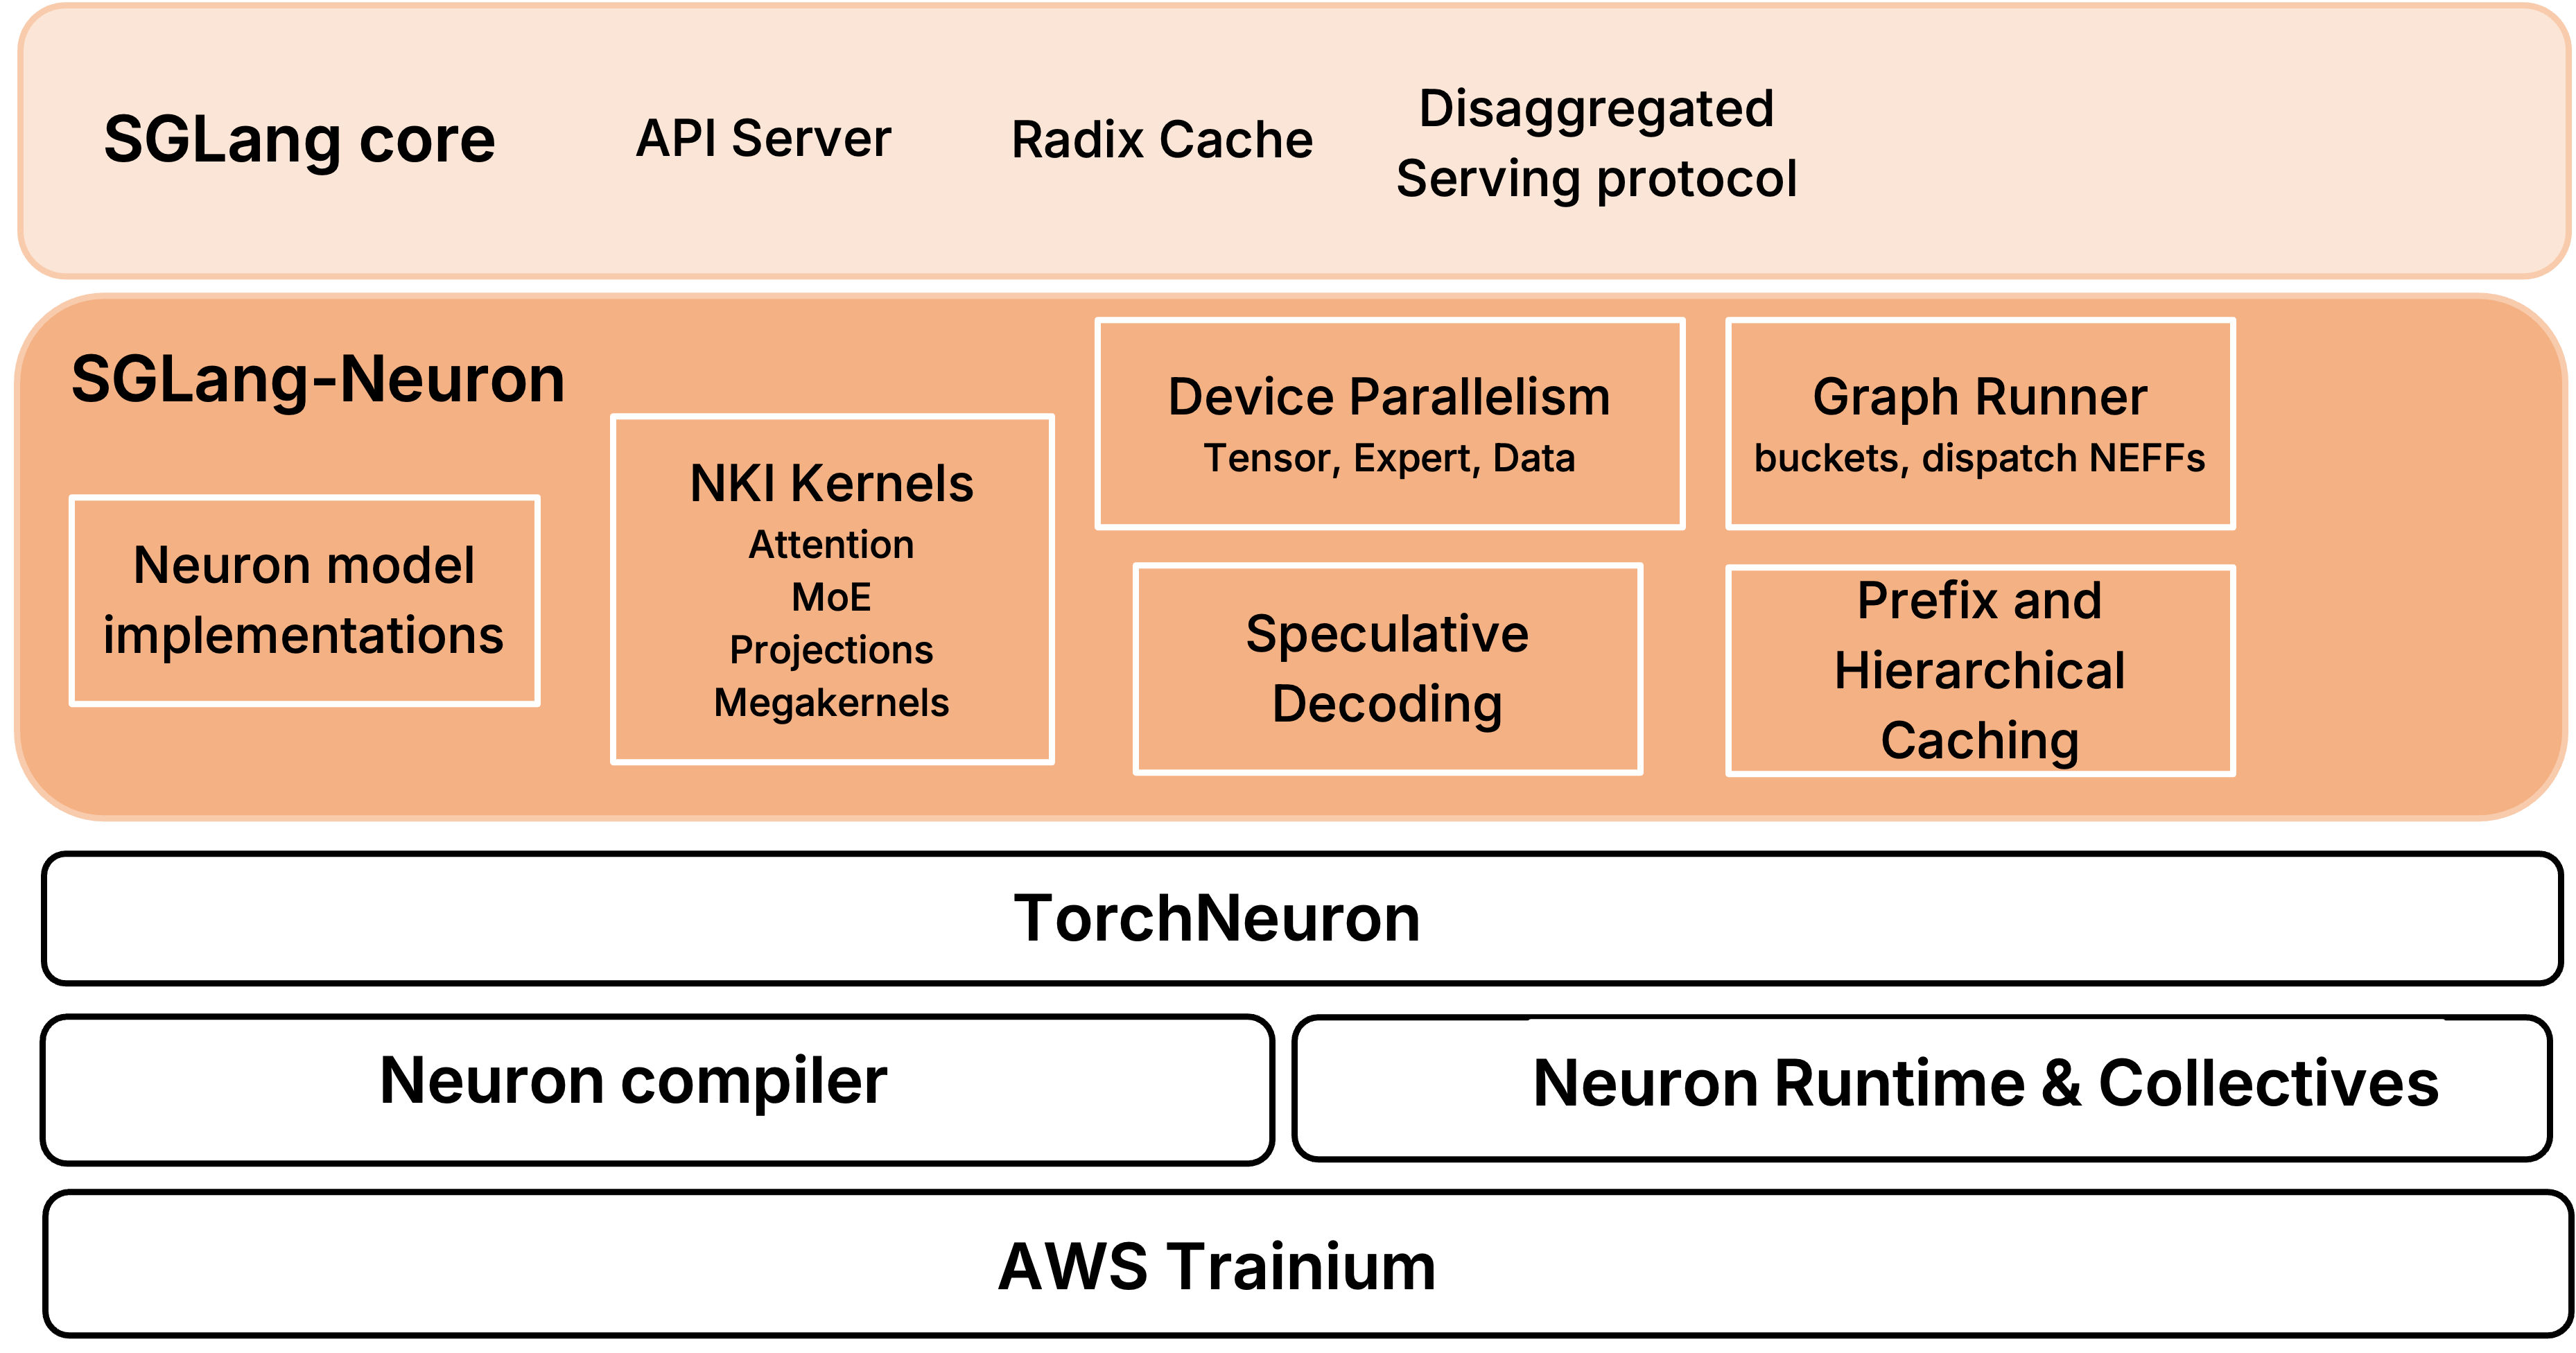
图 1:AWS Trainium 上的 SGLang-Neuron
TorchNeuron 将 Trainium 注册为原生 PyTorch 设备。SGLang-Neuron 在模型执行路径中使用标准 PyTorch 操作,并集成了使用 Neuron Kernel Interface(NKI)编写的高性能内核。它使用 torch.compile 将这些操作和内核编译为可执行程序,由图运行器在服务期间准备并执行。
SGLang-Neuron 还支持 PD 分离。在这种配置中,prefill 服务器计算提示词的 KV 缓存,并通过 弹性 fabric 适配器(EFA) 使用 NIXL 将其传输到 decode 服务器。decode 服务器随后生成其余 token。每个服务器仍使用 SGLang 的调度器和请求生命周期,而插件负责管理 Trainium 执行和 KV 缓存传输路径。
使用 SGLang-Neuron 在 AWS Trainium 上部署模型
要按照本指南操作,你需要使用一台带有 pytorch-inference-sglang-neuronx 容器的 Trainium3 Amazon Elastic Compute Cloud(Amazon EC2)实例。步骤如下:
- Start the container.
docker run --rm -it \ --privileged --ipc=host \ -v /path/to/work:/work \ public.ecr.aws/neuron/pytorch-inference-sglang-neuron:v0.1.0-neuron-py314-sdk-2.33.0-ubuntu26.04 \ /bin/bash - Launch the SGLang model server inside the container.
SGLANG_PLATFORM=neuron \ python -m sglang.launch_server \ --model-path openai/gpt-oss-120b \ --tp-size 8 \ --ep-size 8 \ --kv-cache-dtype fp8_e4m3 \ --context-length 10240 \ --chunked-prefill-size 8192 \ --max-running-requests 64 \ --max-total-tokens 655360 \ --mem-fraction-static 0.8 \ --host 127.0.0.1 \ --port 30000 - Send a request to the model server.
curl -s http://127.0.0.1:30000/v1/chat/completions \
-H 'Content-Type: application/json' \
-d '{
"model": "openai/gpt-oss-120b",
"messages": [
{"role": "user", "content": "Explain why the sky appears blue."}
],
"temperature": 0,
"max_tokens": 128
}'
欲了解更多信息,请参阅 SGLang-Neuron 入门指南中的设置说明,并浏览代码仓库文档以了解支持的模型、功能和经过验证的配置。
结论
SGLang-Neuron 通过原生 PyTorch 将 SGLang 熟悉的服务工作流程带入 AWS Trainium。你可以通过启动 SGLang-Neuron 容器 并按照 快速入门 部署受支持的模型来开始使用。在你的工作负载中试用它,通过项目代码仓库参与贡献,并分享反馈以帮助塑造未来的模型和功能支持。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com