如何用开源爬虫 Crawl4AI 为 Amazon Bedrock Knowledge Bases 准备网页内容
Prepare web content for Amazon Bedrock Knowledge Bases with Crawl4AI
AWS 在博客中展示如何用开源 Python 爬虫 Crawl4AI 为 Amazon Bedrock Knowledge Bases 做网页内容预处理,作为官方 Web Crawler 连接器之外的自定义方案。
构建检索增强生成(RAG)应用时,回答质量取决于你摄取的数据。Amazon Bedrock Knowledge Bases 是 Amazon Bedrock 的全托管 RAG 能力。通过 Amazon Bedrock Managed Knowledge Base,你只需连接数据源,Amazon Bedrock 会为你管理摄取、存储、索引和检索。你无需预置或扩展向量存储,嵌入和重排序默认使用服务托管的模型。
对于网页内容,可以从托管知识库的 Amazon Bedrock Web Crawler 数据源连接器开始。你提供有权爬取的种子 URL 或站点地图,它会在你设定的范围和速率限制内进行爬取。计划的同步会在页面变化时保持知识库最新,并且该连接器可以等待通过 JavaScript 加载的内容。你无需构建、托管或运营爬虫,因此对于大多数公开网站内容,该连接器是首选起点。
有些数据源需要对进入知识库的内容进行更多控制。你可能只想索引每个页面的主要内容区域,去除导航和其他样板内容,或者为每个文档附加自己的元数据属性。对于这类源素材,你可以使用 Crawl4AI(一个开源 Python 爬虫)构建的预处理步骤来扩展知识库的覆盖范围。该步骤将每个页面的 Markdown 和元数据附属文件写入 Amazon Simple Storage Service(Amazon S3),知识库通过其 Amazon S3 数据源摄取这两类文件。
在本文中,我们向你展示如何选择合适的网页摄取路径,并为需要额外处理的内容实现自定义预处理。然后,你将开始向托管知识库中摄取数据并验证检索质量。配套的 aws-samples repository 以示例实现的形式提供了完整的工作流程。
这是对已知网站资产的批量摄取,而不是像使用 Amazon Nova 的 Web Grounding 那样在推理时进行实时网页访问。
解决方案概述
当 Amazon Bedrock Web Crawler 能够访问并索引你需要的页面时,请从它开始。它遵循 robots.txt,并且在首次完整爬取之后,每次同步只捕获新增、更新和删除的内容。
当公开的源素材在摄取之前需要以下一项或多项处理时,请使用 Crawl4AI 预处理路径:
- 结构化 Markdown 预处理:使用
DefaultMarkdownGenerator配合剪枝内容过滤器,在保留标题、列表和表格的同时减少导航和其他样板内容。由于剪枝是启发式的,请审查来自你网站的代表性输出。 - 有边界、有针对性的提取:仅提取与可选 CSS 选择器匹配的页面区域。通过种子来源、页面/路径/主机范围、深度和页面数量上限以及 URL 模式来约束广度优先遍历。
- 自定义元数据:为每个文档附加源 URL、爬取时间戳、内容类型以及你自己的属性,以便你可以据此过滤检索结果。
由于托管知识库和客户自管知识库都支持 Amazon S3 数据源,因此 Crawl4AI 路径适用于这两种类型。本文使用托管知识库,并会注明客户自管知识库的差异之处。
本文余下部分遵循配套示例。请将其架构和默认设置视为起点,而非 Amazon Bedrock Knowledge Bases 的要求。
默认情况下,示例在公有子网中运行 AWS Fargate 任务,通过互联网网关访问您配置的网站。Crawl4AI 的职责在准备好源文档和元数据附属文件后就结束了。从数据摄取开始,由 Amazon Bedrock Knowledge Bases 负责解析、分块、嵌入、索引和检索。下图展示了从计划调度到检索的 Crawl4AI 路径。
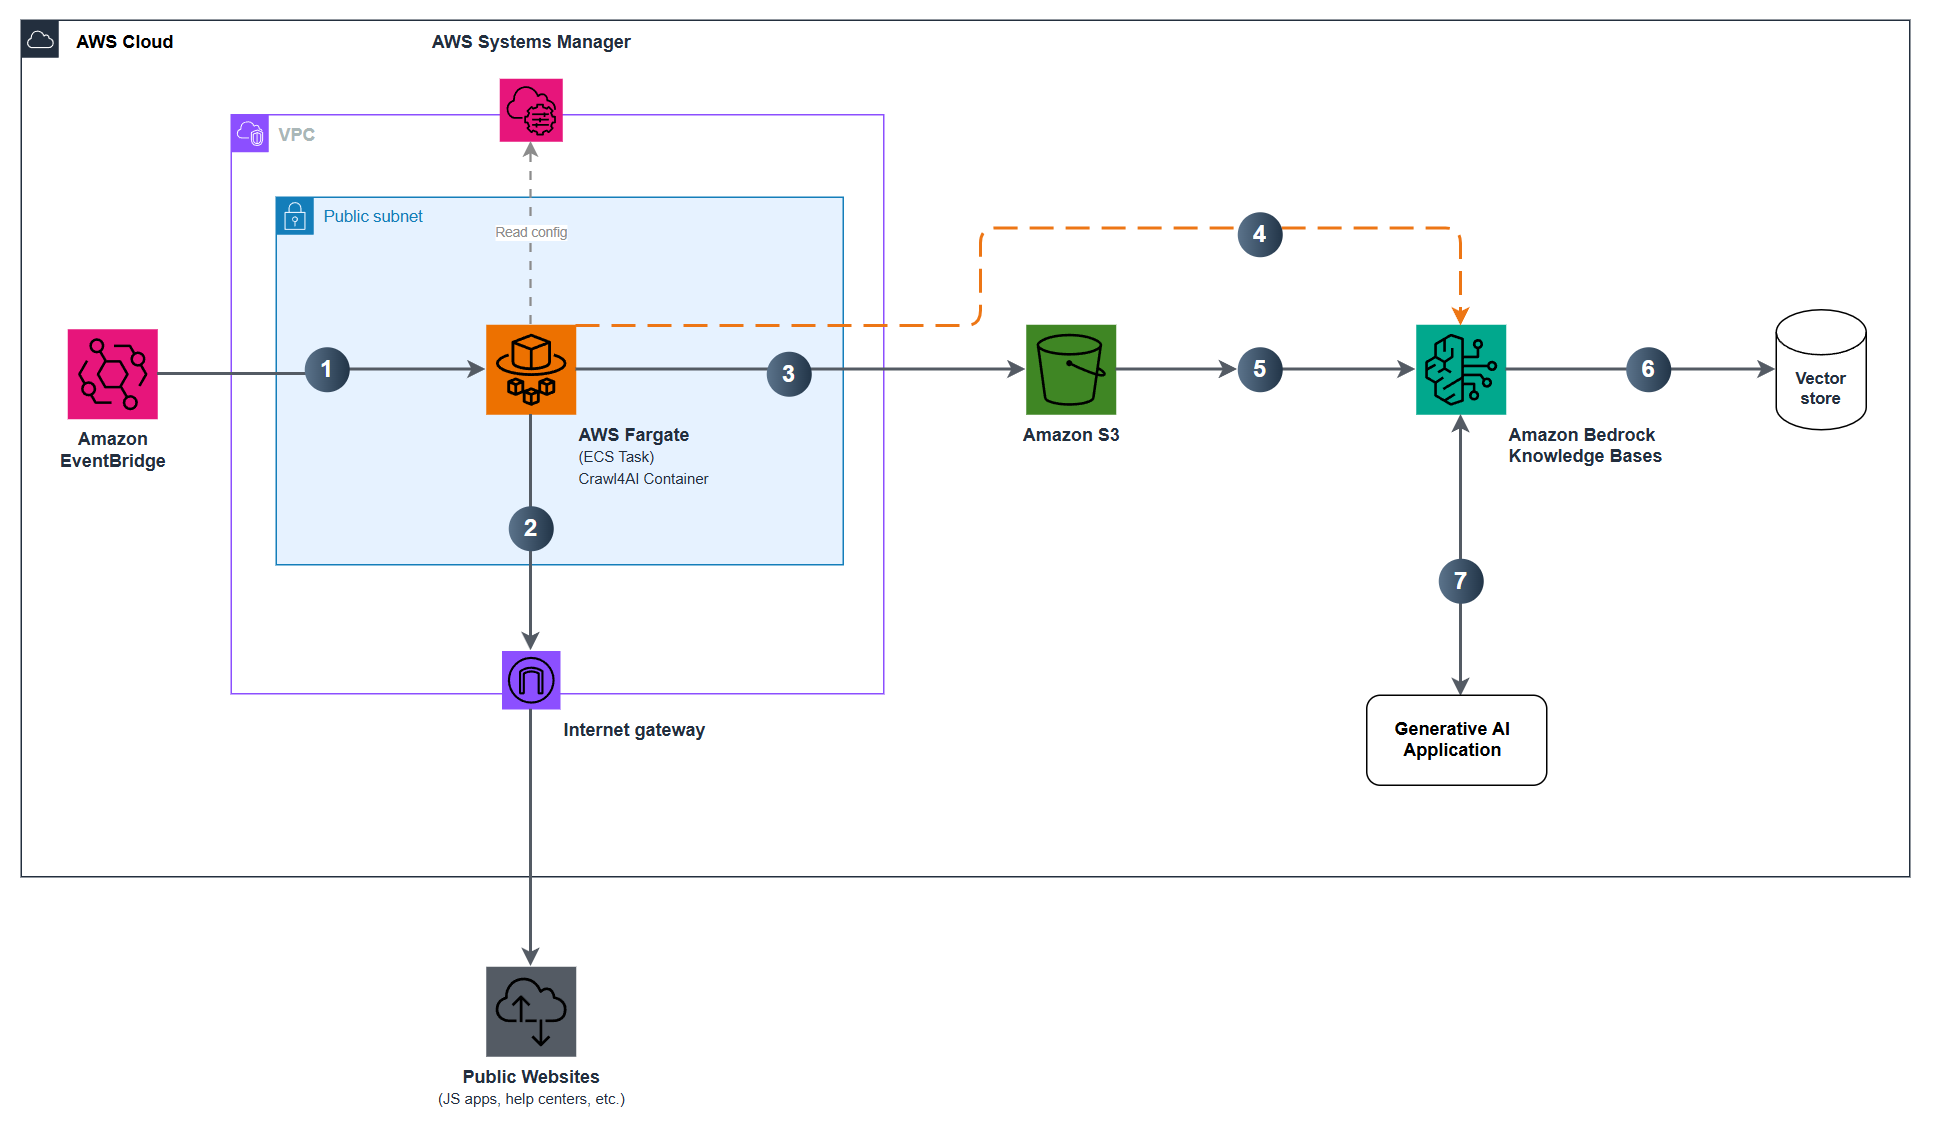
图 1:面向 Amazon Bedrock Knowledge Bases 的 Crawl4AI 到 Amazon S3 的数据摄取路径
图中的编号步骤对应以下工作流:
- Amazon EventBridge 按配置的计划在 AWS Fargate 上启动 Amazon Elastic Container Service (Amazon ECS) 任务。
- 该任务爬取您配置的公有网站,并为每个页面准备附带元数据附属文件的 Markdown。
- 该任务将准备好的文件上传到作为知识库数据源支持的 Amazon S3 存储桶。
- 该任务启动 Amazon Bedrock Knowledge Bases 摄取作业。
- Amazon Bedrock Knowledge Bases 读取新增和变更的对象,进行解析,并应用您选择的分块策略。
- 它创建嵌入并将其索引到知识库的向量存储中,对于托管型知识库,该向量存储由 Amazon Bedrock 管理。
- 您的生成式 AI 应用程序查询知识库以获取相关分块,或获取带有引用的生成回复。
该任务在启动时从 AWS Systems Manager Parameter Store 读取其非机密的流水线配置。
该工作流仅处理公有页面,不实现经过身份验证的会话。对于需要登录的网站,请先评估 Amazon Bedrock Web Crawler 身份验证选项,其中包括基本身份验证、基于表单的身份验证和 SAML 身份验证。为该示例扩展身份验证功能需要会话处理、将凭证存放在 AWS Secrets Manager 中,以及进行安全审查。
工作流的工作原理
AWS Cloud Development Kit (AWS CDK) 应用程序在部署期间将实现打包为容器镜像。当计划触发时,容器运行 scripts/container_entrypoint.py 并依次执行爬取、上传和摄取。以下三个步骤解释了核心逻辑。
步骤 1:爬取并提取内容
爬取步骤执行有界爬取,并为每个成功准备的页面写入一个附带元数据附属文件的 Markdown 文件。以下代码段经过了简化。模块 src/crawl4ai_bedrock_kb/crawl.py 包含完整的种子页面节奏控制、URL 过滤与范围限定、页面限制和重定向检查:
async def crawl_and_prepare(config: PipelineConfig, output_dir: str) -> list[str]:
    written, seen = [], set()
    pages_crawled = 0
    browser_config = BrowserConfig(headless=True, java_script_enabled=True)

    async with AsyncWebCrawler(config=browser_config) as crawler:
        for seed in config.seed_urls:
            remaining = config.crawl.max_pages - pages_crawled
            if remaining <= 0:
                break

            strategy = BFSDeepCrawlStrategy(
                max_depth=config.crawl.max_depth,
                max_pages=remaining,
                filter_chain=FilterChain([
                    SeedScopeFilter(seed, config.crawl.scope),
                    # Optional include/exclude URLPatternFilter objects are added here.
                ]),
            )
            run_config = CrawlerRunConfig(
                deep_crawl_strategy=strategy,
                markdown_generator=DefaultMarkdownGenerator(
                    content_filter=PruningContentFilter()
                ),
                css_selector=config.crawl.css_selector,  # Optional page region.
                check_robots_txt=config.crawl.check_robots_txt,
                mean_delay=config.crawl.request_delay_seconds,
                max_range=0,
                semaphore_count=1,
            )

            results = await crawler.arun(url=seed, config=run_config)
            for result in results:
                if pages_crawled >= config.crawl.max_pages:
                    break
                pages_crawled += 1
                requested_url = result.url
                source_url = getattr(result, "redirected_url", None) or requested_url
                if not SeedScopeFilter(seed, config.crawl.scope).apply(source_url):
                    continue  # Recheck the effective destination after redirects.
                canonical = _canonical_url(source_url)
                if canonical in seen:
                    continue
                seen.add(canonical)
                if not result.success or not result.markdown:
                    continue

                md_result = result.markdown
                markdown = (
                    getattr(md_result, "fit_markdown", None)
                    or getattr(md_result, "raw_markdown", None)
                    or (md_result if isinstance(md_result, str) else "")
                )
                if not markdown:
                    continue

                # The complete implementation adds title, crawl timestamps, content
                # type, and configured custom attributes to this metadata.
                written.extend(
                    _write_document(
                        output_dir,
                        _base_name(source_url),
                        markdown,
                        {"source_url": source_url},
                    )
                )
    return written
Amazon Bedrock Knowledge Bases 为 Amazon S3 数据源支持 多种文档格式,包括纯文本、HTML、Markdown、PDF 和 DOCX。该工作流写入 Markdown,因为它可以在不将全部原始 HTML 带入摄取过程的情况下保留标题、列表和表格。
步骤 2:上传到 Amazon S3
上传步骤将每个准备好的 Markdown 文档及其对应的元数据附属文件发送到配置的 S3 存储桶中,位于工作流的 s3Prefix 之下。对于 page.md,附属文件必须命名为 page.md.metadata.json,即完整的源文件名加上 .metadata.json。该工作流将每个附属文件存储在其文档所在的同一 S3 位置。Amazon Bedrock 将每个元数据附属文件的大小限制为 10 KB。如果某个附属文件会超过该限制,运行将在写入任何文件之前因错误而停止。
附属文件中的每个属性都采用托管型知识库和客户自管知识库对 Amazon S3 数据源均可接受的类型化格式。以下经过缩略、为便于阅读而排版的附属文件展示了该工作流写入的三个属性:
{
  "metadataAttributes": {
    "source_url": {
      "value": {"type": "STRING", "stringValue": "https://www.example.com/services/permits"}
    },
    "crawled_at_epoch": {
      "value": {"type": "NUMBER", "numberValue": 1790640000}
    },
    "content_category": {
      "value": {"type": "STRING", "stringValue": "web"}
    }
  }
}
该流水线仅上传当前爬取产生的路径,因此不会发送过期的本地文件。
第 3 步:让 Amazon Bedrock Knowledge Bases 进行分块、嵌入和索引
内容进入 S3 后,一个摄取任务会将每个文档交给数据源的摄取流水线。默认情况下,托管式知识库使用其托管解析器解析每个文件,该解析器会自动为你的内容选择解析方式。你需要在连接数据源时选择分块策略。此后无法更改,因此在创建生产环境数据源之前请先评估各个选项。托管式知识库提供以下分块策略:
- 默认分块使用固定大小的分块,每块 300 个 token,重叠率为 20%。
- 固定大小分块按你设置的最大 token 数和重叠百分比来拆分内容。
- 不分块将每个文件视为单个分块,适用于你已经自行拆分过的内容。
分块边界和检索结果取决于内容及所选策略,因此请使用具有代表性的页面和评估问题来比较各选项。若要日后更改策略,需创建新的数据源。更多信息请参阅 自定义数据源的摄取。客户自管式知识库还提供语义分块、层级分块以及更多解析选项。详情请参阅 知识库的内容分块工作原理。
随后工作流会启动一个摄取任务,让知识库处理新文档。下面是 src/crawl4ai_bedrock_kb/ingest.py 中经过简化的摘录,展示了该调用:
def start_ingestion_job(config: PipelineConfig) -> str:
    # Start an Amazon Bedrock knowledge base ingestion job and return its ID.
    client = boto3.client("bedrock-agent", region_name=config.region)
    response = client.start_ingestion_job(
        knowledgeBaseId=config.knowledge_base_id,
        dataSourceId=config.data_source_id,
    )
    return response["ingestionJob"]["ingestionJobId"]
同样的 StartIngestionJob 和 GetIngestionJob 调用对两种知识库类型都适用,你也可以在控制台上监控进度。
部署解决方案
在本节中,你将使用 AWS CDK 把该工作流部署到你的 AWS 账户中。两种知识库类型之间只有知识库前置条件不同。完成后,请按照清理部分中的步骤移除相关资源。
前置条件
开始之前,请确保你具备:
- 一个 AWS 账户。
- One of the following knowledge bases:
- 一个托管式知识库(本文使用此类型),位于提供托管式知识库的 AWS 区域中。操作说明请参阅创建托管式知识库以及 Amazon S3 连接器。在数据源上,请将 Metadata files prefix 留空,因为工作流会将每个元数据 sidecar 文件写入其对应文档的旁边。
- 一个已有的客户自管式知识库。要添加 Amazon S3 数据源,请参阅 为你的知识库连接 Amazon S3。工作流会为每个文档写入一个元数据 sidecar 文件,因此请确认你的向量存储能够存储并筛选这些属性,如元数据与筛选中所述。例如,Amazon OpenSearch Serverless 向量索引必须使用
faiss引擎。Amazon Aurora 向量索引需要一列自定义元数据,或为每个元数据属性各设一列。使用 Amazon S3 Vectors(Amazon S3 的一项功能),你可以为每个向量附加最多 1 KB 的自定义元数据,因此请保持所添加的属性简短。
- 该知识库中一个状态为
AVAILABLE的 Amazon S3 数据源。它可以是新的数据源,也可以是你已经在使用的数据源。它必须使用你为此工作流配置的 S3 存储桶。如果数据源按前缀或文件模式筛选内容,则筛选条件必须允许工作流写入其s3Prefix(默认为web-content/)下的文件。 - 知识库、S3 存储桶以及您部署的堆栈都必须位于同一个区域内。
- 对您配置的公开网站进行抓取的授权。
- 一台部署工作站,安装有 Git、Python 3.10 或更高版本、
Node.js、AWS 命令行界面(AWS CLI)版本 2、AWS CDK CLI v2,以及正在运行的兼容 Docker 的容器引擎。部署指南列出了 AWS CDK CLI 的最低版本要求。 - 部署工作站上已配置的 AWS 凭证,并具有引导目标环境和部署 CDK 堆栈的权限。
- 目标账户和区域中已引导的 CDK 环境。部署步骤中包含引导命令。
您只需要工作站来构建和部署。部署完成后,调度计划会在 AWS 中运行任务。
部署定时工作流
克隆配套代码仓库并安装部署依赖项:
git clone https://github.com/aws-samples/sample-crawl4ai-bedrock-knowledge-base.git
cd sample-crawl4ai-bedrock-knowledge-base/deploy
python -m venv .venv
source .venv/bin/activate  # Windows PowerShell: .venv\Scripts\Activate.ps1
python -m pip install -r requirements.txt
保持 Docker 运行。首先将 AWS_DEFAULT_REGION 设置为您知识库所在的区域,因为 cdk deploy 使用的是您环境或 AWS 配置文件中的区域,而不是引导命令中的区域。如有需要,对目标账户和区域进行一次引导。然后使用您的知识库、数据源、S3 存储桶和已授权的种子 URL 部署堆栈:
export AWS_DEFAULT_REGION=REGION  # Windows PowerShell: $env:AWS_DEFAULT_REGION = "REGION"
cdk bootstrap aws://ACCOUNT_ID/REGION

cdk deploy \
  -c knowledgeBaseId=ABCDEFGHIJ \
  -c dataSourceId=KLMNOPQRST \
  -c s3Bucket=amzn-s3-demo-bucket \
  -c 'seedUrls=["https://www.example.com/services"]' \
  -c maxDepth=1 \
  -c maxPages=25
替换所有示例值,包括 ACCOUNT_ID、REGION 以及四个必需的上下文键,换成您自己的值。示例值在语法上是有效的,因此未经修改的命令会部署一个指向您不拥有的存储桶的堆栈。您也可以在 cdk.json 中设置这些键。
maxDepth 和 maxPages 的值将首次抓取限制在一个链接层级和 25 个页面。在检查了准备好的输出之后再提高它们。要预览一次抓取会准备哪些页面,您还可以使用 --dry-run 在本地运行该流水线,如README中所述。堆栈名称是固定的,因此在同一账户和区域中再次执行 cdk deploy 会更新此堆栈。
该示例默认构建 ARM64 容器镜像。如果您的 x86_64 工作站上的 Docker 无法构建 ARM64 镜像,请在 cdk deploy 命令中添加 -c cpuArchitecture=X86_64。
如果您的账户开启了 VPC Block Public Access,任务将无法从默认公共子网访问互联网。要检查模式,请运行 aws ec2 describe-vpc-block-public-access-options。在仅入站模式下,请使用 -c egressMode=nat 进行部署,这会添加一个按小时计费的 NAT 网关。双向模式还需要一个排除项,如部署指南所述。
该堆栈不会创建或更改您的知识库或数据源。
使用默认的 rate(24 hours) 调度计划,首次运行将在部署创建 Amazon EventBridge 规则时开始。要跟踪该运行,请使用 TailLogsCommand 输出中的命令,该输出由 cdk deploy 在完成时打印。一次成功的运行会记录 job_status: COMPLETE。要在调度计划之外启动另一次运行,请在当前运行完成后使用 RunTaskCommand 输出中的命令。要在之后列出输出,请运行 aws cloudformation describe-stacks --stack-name Crawl4aiBedrockKbCrawler --region REGION --query "Stacks[0].Outputs"。
部署指南涵盖了其余的配置,包括抓取边界、调度计划、网络、容器架构、监控和按需运行。
验证检索质量
在摄取之后,在添加生成功能之前,先用 Retrieve 测试有代表性的问题。托管式知识库使用混合搜索。当它使用默认的托管式嵌入模型时,还会使用其托管式重排序器对结果进行重排序。您可以使用附带元数据文件中的元数据来缩小结果范围。该示例的默认配置会为每个页面添加设置为 web 的 content_category。以下示例最多返回过去七天内抓取的那些页面中的五个片段。它需要 AWS SDK for Python(Boto3)1.43.32 或更高版本,您可以使用 python -m pip install "boto3>=1.43.32" 安装。请将区域和知识库 ID 替换为您自己的值:
import time

import boto3

client = boto3.client("bedrock-agent-runtime", region_name="us-east-1")
week_ago = int(time.time()) - 7 * 24 * 60 * 60

response = client.retrieve(
    knowledgeBaseId="ABCDEFGHIJ",
    retrievalQuery={"text": "How do I apply for a building permit?"},
    retrievalConfiguration={
        "managedSearchConfiguration": {
            "numberOfResults": 5,
            "filter": {
                "andAll": [
                    {"equals": {"key": "content_category", "value": "web"}},
                    {"greaterThan": {"key": "crawled_at_epoch", "value": week_ago}},
                ]
            },
        }
    },
)

for result in response["retrievalResults"]:
    print(result.get("metadata", {}).get("source_url"), result["content"]["text"][:200])
该示例传递了一个整数时间戳,两种知识库类型都在数字过滤器中接受它。托管知识库不支持 startsWith 和 stringContains 过滤器。对于客户自主管理的知识库,请改为在 vectorSearchConfiguration 中传递相同的过滤器,而不是 managedSearchConfiguration。它支持的运算符取决于其向量存储。
元数据过滤可以提高检索精度,但它并不是授权边界。如果不同用户应看到不同页面,托管知识库的 Amazon S3 连接器支持使用您提供的访问控制列表(ACL)文件来实现文档级访问控制。本示例不会创建 ACL 文件。
要从托管知识库生成响应,请使用智能体检索。AgenticRetrieveStream 操作会返回检索到的结果以及一条带有这些结果引用的生成响应。对于客户自主管理的知识库,请使用 RetrieveAndGenerate。在这两种情况下,每个被引用的结果都包含其附属文件中的 source_url 元数据,您的应用程序可以将其作为面向用户的来源进行展示。
每当您更改内容准备、分块或检索设置时,都应评估检索相关性、来源页面覆盖率和引用质量。有关可调的检索设置,请参阅为托管知识库配置和自定义查询。
重复运行
每个计划事件都会启动一个独立的 Fargate 任务。该技术栈不会阻止运行重叠,因此请选择比预期的爬取和摄取时长更长的时间间隔。失败的运行不会发出通知,因为本示例没有添加重试策略、死信队列或警报。摄取作业也可能在部分文档摄取失败时报告 COMPLETE,此时任务以退出代码 0 结束。任务会记录作业的失败原因。在依赖该计划之前,请添加您所需的监控,包括针对这些失败原因的警报。
每次运行都会按所配置的任务规格产生 Fargate 费用,默认为 2 个 vCPU 和 4 GB 内存。任务在轮询摄取作业期间会持续运行长达 30 分钟,因此缓慢的摄取作业会延长计费的任务时间。如果摄取耗时更长,任务将以非零退出代码结束,而摄取作业会继续运行。该技术栈会为集群启用 Container Insights,并为其创建的 Amazon Virtual Private Cloud(Amazon VPC)启用流日志,两者都会产生 Amazon CloudWatch 费用。该技术栈的 AWS KMS 密钥按月收费,任务的公有 IPv4 地址在任务运行期间计费。使用 egressMode=nat 或 privateEndpoints=true 时,NAT 网关和接口端点按小时计费,即使没有任务在运行。知识库的使用费用单独计费。详情请参阅Amazon VPC 定价和Amazon Bedrock 定价。
上传是增量式的:在后续爬取中移除某个 URL 或缺少某个页面,并不会删除其已有的 S3 对象。要移除过期内容,请在所配置的前缀下删除过时的文档及对应的附属文件,然后重新启动摄取。如果您为托管知识库数据源开启了文档删除保护(删除防护),请检查其阈值。如果一次同步会删除超过该百分比的文档,则会跳过其删除阶段,因此这些文档会保持已索引状态。要让存储桶中的对象发生变化时自动启动摄取,请参阅为 Amazon Bedrock Knowledge Bases 构建和部署自动同步解决方案。
负责任的 AI 注意事项
检索到的段落会成为基础模型用于生成回答的上下文。在生产环境中运行此工作流之前,请先应用以下控制措施:
- Amazon Bedrock Guardrails:为您的智能体检索或
RetrieveAndGenerate请求附加一个护栏(guardrail),以应用内容过滤器、被拒主题、词汇过滤器和敏感信息过滤器。智能体检索仅支持护栏的BLOCK操作,不支持MASK。 - 上下文依据检查:开启 Guardrails 的上下文依据检查(contextual grounding check),对每条回答进行评分,衡量其与检索段落的依据程度以及与查询的相关性。护栏会拦截低于您所设阈值的回答。对于智能体检索,您可以使用
ApplyGuardrailAPI 对生成的答案运行该检查。此检查支持问答和摘要场景,不支持聊天机器人对话场景。 - 将抓取的内容视为不受信任的输入:处理后的网页会成为模型上下文,因此公开页面上的文本可能通过检索尝试进行提示词注入。不要仅依赖护栏来拦截。将种子 URL 限制为您信任的站点,并在内容进入知识库之前,应用下一节所述的摄取过滤模式。
- 引用与人工审核:在每条生成的回答中附带引用,以便用户可以对照源页面核实内容。对于风险较高的使用场景,请保留人工审核环节。
安全与合规注意事项
在将此工作流用于生产内容之前,请审阅以下注意事项:
- 使用受信任的公开抓取目标:种子 URL 和抓取设置属于部署配置,Fargate 任务允许出站访问以便访问公开网站。在示例的默认网络模式下,任务运行在具有公有 IP 的公有子网中。仅配置经授权的公开站点。不要使用此示例抓取私有或内部端点。在将此工作流适配到其他信任模型之前,请审阅网络出站和目标控制。
- 遵守抓取指令:默认情况下,工作流会开启 Crawl4AI 的
robots.txt检查,且 CDK 路径将其固定为开启,没有可禁用它的上下文键。请确认您有权抓取目标站点,并符合AWS 可接受使用政策。 - 速率限制:配置请求之间的延迟,以避免压垮源网站。
- 静态加密:该技术栈会创建一个带自动密钥轮换的 AWS Key Management Service(AWS KMS)客户托管密钥,并用它加密其 CloudWatch 日志组。Amazon S3 默认使用 Amazon S3 托管密钥的服务器端加密(SSE-S3)对新对象进行加密。如果您的数据分类要求存储桶使用客户托管密钥,请将存储桶配置为使用该密钥。然后在 AWS Identity and Access Management(IAM)和密钥策略中,为上传方和知识库服务角色授予所需的 AWS KMS 权限。该技术栈的任务角色不包含 AWS KMS 权限。托管式知识库默认使用 AWS 拥有的密钥加密其数据,或使用您在创建时指定的客户托管密钥。对于客户管理的知识库,请审阅其向量存储的加密方式。
- 最小权限 IAM:CDK 栈为 Fargate 任务角色授予对所配置存储桶前缀的
s3:PutObject权限。还授予对目标知识库的bedrock:StartIngestionJob和bedrock:GetIngestionJob权限,以及其单一配置参数的ssm:GetParameter权限。Amazon EventBridge 任务启动以及标准的容器镜像拉取和日志投递由单独的角色负责。该流水线不会读取或列出 S3,也不会调用InvokeModel或Retrieve。 - 容器和模板检查:容器以非 root 用户运行,CDK 应用在每次合成时运行 cdk-nag AWS Solutions 检查,并使用资源范围的抑制规则。
- 保护部署配置:CDK 应用将非机密的流水线设置存储在 Parameter Store 的明文
String参数中。任务定义中只放置参数名称。不要将密码、cookie、令牌或其他机密放入 CDK 上下文或此参数中。 - 摄取流水线安全:请参阅 Securing the RAG ingestion pipeline: Filtering mechanisms,了解在内容进入知识库之前应用的过滤和验证模式。
清理
为避免产生持续费用,请删除本次演练期间创建的资源:
- 在代码仓库的
deploy/目录中,在同一 Region 下运行cdk destroy,并使用与传递给cdk deploy时相同的四个必需-c值。应用会在每条命令中检查这些值。此操作会删除该栈的 Amazon EventBridge 规则、ECS 集群、任务定义、日志组、IAM 角色、Parameter Store 参数和安全组,如果该栈创建了 VPC,也会将其删除。它还会将该栈的 AWS KMS 密钥安排在 30 天等待期后删除。它不会删除导入的 VPC、你的知识库、你的 S3 存储桶或工作流上传的对象。CDK 还会在其引导资源中保留容器镜像和模板。它也会保留集群的 Container Insights 日志组,其名称以/aws/ecs/containerinsights/Crawl4aiBedrockKbCrawler-开头。 - 要删除已摄取的网页内容,请删除
s3://<bucket>/<prefix>下的已准备对象,并再次同步数据源。如果托管知识库数据源开启了文档删除保护,则一次会删除超过其阈值百分比文档的同步将跳过其删除阶段。 - 仅当你专为本演练创建了该托管知识库时才将其删除。托管知识库没有需要单独删除的向量存储。
- 对于客户自主管理的知识库,仅当你专为本演练创建了该 Amazon S3 数据源时才将其删除。其数据删除策略决定 Amazon Bedrock 是否同时从你的向量存储中删除该数据源的向量嵌入。
结语
在这篇文章中,你学习了如何扩展 Amazon Bedrock Knowledge Bases,以支持需要在摄取前进行准备的授权公共网页内容。一个定时 Fargate 任务使用 Crawl4AI 进行有界爬取,使用 page.md.metadata.json sidecar 准备 Markdown,将其上传到 Amazon S3 数据源,并启动摄取。随后,知识库负责解析、分块、嵌入、索引、检索以及带引用的基于事实的响应。
对于大多数公共网站,请从托管知识库中的 Amazon Bedrock Web Crawler 开始。当你需要控制每个页面被索引的部分或随之传递的元数据时,请使用 Crawl4AI 方案。要开始使用,请从配套的 sample-crawl4ai-bedrock-knowledge-base 仓库部署定时 Fargate 工作流,然后在扩展之前使用有代表性的内容验证检索质量和引用。
了解更多
有关本文中介绍的服务和模式的更多信息,请参阅以下资源:
- 构建托管式知识库
- 用于托管式知识库的 Amazon Bedrock Web Crawler
- 用于托管式知识库的 Amazon S3 连接器
- 使用智能体检索来查询知识库
- GitHub 上的 Crawl4AI
- aws-samples/amazon-bedrock-samples 中的知识库示例
致谢
本产品包含由 UncleCode 作为 Crawl4AI 项目 的一部分开发的软件。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com