AWS 使用 Ray LLM Deep Learning Containers 在 Amazon EKS 上运行多节点推理
Run multi-node inference workloads using Ray LLM Deep Learning Containers
AWS Machine Learning Blog 发布教程,展示如何用多节点 Ray LLM DLC 在 Amazon EKS 上将单个 LLM 部署到两个 GPU 节点,通过单一 OpenAI 兼容端点实现 prefill/decode 分离推理。
本文介绍如何在 Amazon Elastic Kubernetes Service(Amazon EKS)上,使用多节点Ray LLM 深度学习容器将一个大语言模型(LLM)部署到两个 GPU 节点上。它在同一个 OpenAI 兼容端点后面使用分离的预填充(prefill)和解码(decode)节点。这种多节点设置常见于张量并行、流水线并行和数据并行,以及预填充/解码分离推理工作负载。在之前的文章中,我们介绍了 Ray Serve DLC,并用它在单个 GPU 节点上通过 HTTP 端点部署了一个小模型。您由此获得了一个可用的推理端点,而且该容器保持了 GPU 技术栈的兼容性(包括 CUDA 库),因此无需编写样板代码。
Ray 是一个分布式计算框架,因此 Ray Serve 部署可以跨越多个节点。客户使用多节点 Ray Serve 的原因有多种。有些客户希望运行对单个 GPU 来说过大的基础模型或开放权重模型。有些客户需要的吞吐量超出了单个副本所能提供的。还有些客户希望将推理的两个阶段分离以提升性能。无论哪种情况,客户都必须自行构建依赖链:为 GPU 技术栈选择兼容的库,并在组件出现不一致时调试问题。这类无差异化的工作会耗费时间和精力,使其无法专注于交付模型。
AWS 深度学习容器(DLC)长期以来一直在为训练和推理工作负载解决这类问题。DLC 是预先构建、经过性能优化的 Docker 镜像,它将框架、其依赖项以及 GPU 技术栈打包成经过测试和修补的组合,可以立即拉取使用。随着面向多节点部署的 Ray LLM DLC 的发布,同样的方法现在扩展到了多节点推理。您将获得一个专为在 HTTP 端点后服务模型而构建的容器,由 AWS 维护和测试,并且完整的推理栈已经组装完毕。
本文将逐步介绍如何使用多节点 Ray LLM DLC 实现多节点分离式推理:在 Amazon EKS 上将一个大语言模型部署到两个由 GPU 驱动的节点上,并在单个端点后协同工作。其中一个 GPU 节点处理预填充阶段,另一个 GPU 节点处理解码阶段。将两个阶段分离,可以防止计算量大的长提示词阻塞已在进行的请求的 token 生成。这种方法非常适合诸如检索增强生成(RAG)、文档摘要和智能体应用等工作负载。我们使用多节点 Ray LLM DLC,它随附 Ray Serve LLM、NVIDIA Inference Transfer Library(NIXL)和 Elastic Fabric Adapter(EFA)技术栈,并且无需应用代码即可提供 OpenAI 兼容的 API。完整代码可在随附的代码库中获取。
为什么要进行预填充/解码(PD)分离
LLM 推理有两个截然不同的阶段。Prefill(预填充)并行处理整个输入提示,并构建键值(KV)缓存。Decode(解码)随后逐个 token 生成响应,读取并扩展该缓存。Prefill 受计算能力限制,而 Decode 受内存带宽限制。当两个阶段共享一块 GPU 时,它们会争夺相同的资源,突发且计算密集的 prefill 工作会干扰平稳且延迟敏感的 decode 工作。将 prefill 阶段与 decode 阶段分离,意味着你可以为每个阶段选择合适的硬件和服务特性,从而在大规模部署时提升整体性能。
PD 分离(PD disaggregation)将这两个阶段放在不同的节点上,使每个阶段运行时互不干扰,并且可以独立扩缩。其代价是,prefill 期间构建的 KV 缓存必须传递给 decode 节点,且该传输必须足够快,才不会抵消带来的收益。这正是节点间互连至关重要的原因。
Ray LLM DLC 提供了什么
AWS DLC 是预先构建、性能优化的 Docker 镜像,它将某个框架及其依赖项和 GPU 技术栈打包成经过测试、已打补丁的组合,你可以直接拉取并立即使用。所有组件在每次发布前都会经过统一验证,因此 CUDA 运行时、框架和服务层之间不会出现版本漂移。安全补丁会在构建时应用。
Ray LLM DLC 将此扩展到分布式 LLM 服务。它内置 vLLM 作为推理引擎,Ray Serve 的 HTTP 作为服务层,NIXL 用于节点间的 KV 缓存传输,以及 EFA 技术栈(libfabric 和 aws-ofi-nccl)用于高带宽的节点间通信。由于 Ray Serve LLM 库包含内置的应用构建器,整个服务应用就是一段 YAML。无需处理类(handler class),无需模型归档器,也无需构建自定义镜像。一个简单的辅助函数 build_pd_openai_app 接收 prefill 配置和 decode 配置,并在一个 OpenAI 兼容端点后自动完成它们之间的 KV 缓存传输接线。
架构
下图展示了该部署在 Amazon EKS 上的布局。用户请求到达 CPU 系统节点上的 Ray head,两个 GPU 工作节点分别运行模型的 prefill 和 decode 阶段。
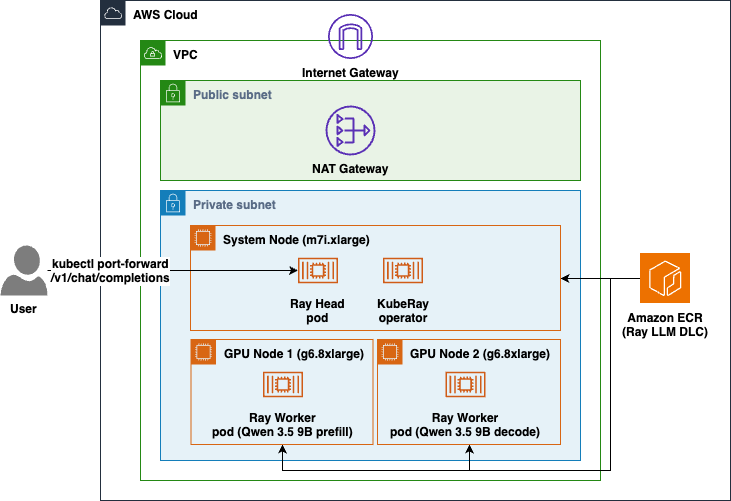
图 1:Amazon EKS 上的多节点推理架构,Ray head 位于 CPU 系统节点上,prefill 和 decode 阶段分别位于两个 GPU 工作节点上
该部署是虚拟私有云(VPC)中的一个 EKS 集群。节点运行在私有子网中,通过 NAT 网关进行出站访问。一个 CPU 系统节点(m7i.xlarge)承载系统工作负载、KubeRay 操作器和 Ray head pod(仅 CPU)。两个 GPU 工作节点(g6.8xlarge)运行 Ray 工作进程:一个服务于 prefill 阶段,另一个服务于 decode 阶段。两个节点都从 Amazon Elastic Container Registry (Amazon ECR) 拉取 Ray LLM DLC。
KubeRay 监视你应用的 RayService,并自动完成 head 与 worker 的加入接线。Ray Serve 将 prefill 和 decode 部署放置到两个 GPU 工作节点上。KV 缓存通过 NIXL 从 prefill 工作节点流向 decode 工作节点,经由 NIXL 的 libfabric 后端使用 EFA。GPU 节点组固定在单一可用区(AZ),因为 EFA 无法跨可用区。
前提条件
要跟随本文操作,你需要:
- 已启用计费的 AWS 账户。
- 目标区域中运行两个 g6.8xlarge 实例(至少 64 vCPU)的充足服务配额。
- 已配置凭证的 AWS 命令行界面 (AWS CLI)。
- 用于与 Kubernetes 集群控制平面通信的 kubectl CLI。
- 用于在 EKS 上创建和管理集群的 eksctl CLI。
- 用于安装 KubeRay operator 的 helm(Kubernetes 的包管理器)。
- 用于渲染清单的 envsubst 工具(GNU gettext 的一部分)。
使用以下命令验证您的 AWS 凭证是否有效:
aws sts get-caller-identity使用预构建的应用程序提供推理服务
该应用程序是 manifest/rayservice.yaml 中的 serveConfigV2 块。它使用 build_pd_openai_app,该函数接受一个 prefill_config 和一个 decode_config,并在它们之间建立 KV-cache 传输连接:
applications:
- name: qwen
  import_path: ray.serve.llm:build_pd_openai_app # OpenAI-compatible PD app, built in
  route_prefix: /
  args:
    prefill_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true # Skip CUDA graph capture to reduce peak GPU memory
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: prefill
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
      deployment_config: { num_replicas: 1 }
    decode_config:
      model_loading_config: { model_id: qwen3.5-9b, model_source: Qwen/Qwen3.5-9B }
      engine_kwargs:
        max_model_len: 4096
        dtype: bfloat16
        gpu_memory_utilization: 0.90
        enforce_eager: true
      kv_transfer_config:
        kv_connector: NixlConnector
        kv_role: kv_both
        engine_id: decode
        kv_connector_extra_config: { backends: ["LIBFABRIC"] }
deployment_config: { num_replicas: 1 }有几个设置起到了最关键的作用。max_model_len: 4096 将上下文大小设定为与 GPU 上测得的 KV 缓存相匹配。dtype: bfloat16 和 gpu_memory_utilization: 0.90 设置精度以及 vLLM 可占用的 VRAM 数量。enforce_eager: true 跳过 CUDA 图捕获以降低 GPU 峰值内存(取决于模型和输入)。kv_transfer_config 设置是实现分离式部署的关键:两个阶段都使用带有 kv_role: kv_both 的 NixlConnector 以及各自不同的 engine_id(预填充用一个,解码用另一个)。最关键的设置是 kv_connector_extra_config: { backends: ["LIBFABRIC"] }。如果没有那一行,NIXL 会默认使用 UCX,即使是在 EFA 上也只能以 TCP 速度运行。
清单的其余部分(在 rayClusterConfig 中)描述了各个 pod。头节点 pod 仅使用 CPU(num-gpus: "0")并固定在系统节点组上。每个工作节点 pod 请求一个 GPU 和一个 EFA 接口(nvidia.com/gpu: "1", vpc.amazonaws.com/efa: "1"),并通过 nodeSelector: { role: gpu-worker } 定位到 GPU 节点。它运行 privileged: true,因为 NIXL 会向 EFA 网卡注册 CUDA VRAM。仅有 IPC_LOCK 能力是不够的。工作节点设置了 FI_PROVIDER=efa,从 pod IP 读取 VLLM_HOST_IP,并挂载共享内存卷。内存限制远高于约 18 GiB 的检查点,以便操作系统的页面缓存可以容纳它。对于在 g6.8xlarge 上按上述缓存配置加载 Qwen3.5-9B 模型,重启时模型权重加载时间从约 145 秒缩短到约 2 秒。
部署到 Amazon EKS
所有脚本共享一个配置文件 scripts/env.sh。该脚本包含 CLUSTER_NAME、REGION、K8S_VERSION 和 NAMESPACE 的默认值。其他默认值涵盖系统节点组和 GPU 节点组、KubeRay 版本以及模型。在运行脚本之前,可以通过导出变量来覆盖任何变量。
在项目根目录下,设置一个基础目录,然后加载变量:
CURRENT_DIR=$(pwd)
cd $CURRENT_DIR/ray-serve-multi-node/scripts
source ./env.sh
步骤 1:创建 EKS 集群
./deploy_cluster.sh此步骤会预置 EKS 集群(VPC、OIDC 提供商、核心插件)以及一个 CPU 系统节点组,用于运行系统工作负载、KubeRay operator 和 Ray 头节点。节点在私有子网中运行,并通过 NAT 网关进行出站访问,集群子网部署在提供该 GPU 实例类型的可用区中。该脚本具有幂等性,全新运行需要 15–20 分钟。
步骤 2:添加 GPU 工作节点
./deploy_node_group.sh此步骤会创建 GPU 节点组:两个启用了 EFA 的 g6.8xlarge 实例,固定在单个可用区中并标记为 role=gpu-worker,以便 Ray 工作节点定位到它们。启用 EFA 还会安装 EFA 设备插件,该插件会在每个节点上通告 vpc.amazonaws.com/efa。此步骤大约需要 5-20 分钟,首次运行通常耗时更长。
步骤 3:安装 KubeRay operator
./install_kuberay.sh此步骤使用 Helm 安装 KubeRay operator,并将其固定在系统节点组上,以保持 GPU 节点可用于推理。KubeRay 会监视你接下来应用的 RayService,并自动完成头节点与工作节点的连接。此步骤大约需要 1–2 分钟。
步骤 4:部署 RayService
./deploy_ray_service.sh该脚本使用 envsubst 将你的镜像、模型和命名变量渲染到 manifest/rayservice.yaml 中并应用它。KubeRay 会创建 head 和两个 worker pod,Ray Serve LLM 会启动 prefill 和 decode 部署。脚本会等待 head 达到 Ready 状态、两个 worker 达到 Running 状态,最后等待 Serve 应用报告 RUNNING。由于每个节点都要加载模型,预计这一步需要几分钟。
可随时检查状态,包括每个 pod 落在哪个节点上以及可用的 GPU 容量:
./deploy_ray_service.sh status调用模型
Serve 应用正常运行后,KubeRay 会创建一个稳定的 <rayservice-name>-serve-svc Service。对其进行端口转发:
kubectl port-forward -n inference svc/ray-llm-serve-svc 8000:8000由于该 DLC 暴露了与 OpenAI 兼容的 API,你可以列出模型并发送标准的 chat-completion 请求,无需自定义 schema:
curl --silent http://127.0.0.1:8000/v1/models
curl --fail --silent --show-error \
  --request POST "http://127.0.0.1:8000/v1/chat/completions" \
  --header "Content-Type: application/json" \
  --data '{
    "model": "qwen3.5-9b",
    "messages": [
      {"role": "user", "content": "Explain the benefits of prefill/decode disaggregation."}
    ],
    "max_tokens": 200,
    "temperature": 0.7
  }'
验证 EFA 正在被使用
如果 NIXL 无法使用 libfabric,它会回退到 TCP 速度的传输方式,且不会抛出错误,因此值得确认它选择了哪个后端。用 grep 检索 worker 日志:
for POD in $(kubectl get pods -n inference -l ray.io/node-type=worker \
  -o jsonpath='{.items[*].metadata.name}'); do
  kubectl exec -n inference "$POD" -c ray-worker -- \
    grep -rhoE "Backend (LIBFABRIC|UCX) was instantiated" /tmp/ray/session_latest/logs/ 2>/dev/null
done | sort | uniq -c
deploy_node_group.sh 在创建组时已经会打印每个节点的 vpc.amazonaws.com/efa 数量。要获得跨节点带宽数值,该 DLC 在 /usr/local/bin/all_reduce_perf 处附带了一个预构建的 NVIDIA Collective Communications Library(NCCL)基准测试。
清理资源
为避免产生持续费用,请按相反顺序拆除资源:
./delete_ray_service.sh # Remove the RayService
./install_kuberay.sh cleanup # Uninstall the KubeRay operator
./delete_node_group.sh # Remove the GPU node group
./delete_cluster.sh # Delete the EKS cluster
结论与后续步骤
你在两个 GPU 节点上部署了一个带有 prefill/decode 分离的单一模型,而整个应用只是一段 YAML,没有 handler 代码,没有 model archiver,也没有手工拼装的 GPU 和 EFA 堆栈。多节点 Ray LLM DLC 提供了经过测试的推理堆栈,KubeRay 编排了 Ray 集群,NIXL over EFA 在节点之间传输 KV 缓存。你的工作是配置它,而不是构建它。
运行多节点推理的常见模式包括张量并行和流水线并行(对单个实例装不下的大模型进行分片)、数据并行(复制模型以提升吞吐量),以及 prefill/decode 分离(将推理的两个阶段放到不同节点上)。
从这里开始,你可以扩展 decode 副本以获得更高的吞吐量,在更大的 GPU 实例上使用张量并行或流水线并行运行更大的模型,或者在同一个经过测试的基础上为需要的模型叠加额外的库。完整代码、当前镜像标签列表以及底层机制,请参阅随附的仓库、Ray LLM DLC 可用镜像页面、Ray Serve LLM prefill/decode 文档和EFA 文档。
关于作者
来源:AWS Machine Learning Blog · aws.amazon.com