IskayPet 如何用 Amazon Bedrock Managed Knowledge Bases 统一企业知识库
How IskayPet unified corporate knowledge with Amazon Bedrock Managed Knowledge Bases
伊比利亚宠物护理公司 IskayPet 基于 Amazon Bedrock Managed Knowledge Bases 构建了企业知识助手,无需自管 RAG 基础设施,即可在西班牙、葡萄牙、法国三国以四种语言回答员工关于零售、兽医、人事入职和采购的问题。
IskayPet 的办公团队面临知识管理难题。日常运营问题的答案,例如退货政策、兽医规程或入职步骤,散落在数百份 Microsoft SharePoint 文档中,涵盖四种语言和三个国家。要在庞大的文档库中找到正确的信息,往往需要很长时间。每新增一家门店、一个国家或一套流程,问题都会进一步扩大。
检索增强生成(RAG)是解决这类问题的常用方法。但在生产环境中运行 RAG 通常意味着要自行运维向量数据库、嵌入管道和数据摄取作业。
在这篇文章中,我们将展示伊比利亚领先的宠物护理公司 IskayPet 如何在 Amazon Bedrock Managed Knowledge Bases 上构建企业知识助手。该助手以四种语言、覆盖三个国家,回答员工在零售运营、兽医护理、人事与入职以及采购方面的问题,且无需管理任何 RAG 基础设施。团队使用 Kiro 与 Claude Haiku 4.5 构建了整套解决方案,从面向门店的前端到 AWS 架构与部署。我们将介绍其架构、SharePoint 集成、检索配置决策以及生产环境中的成果。
关于 IskayPet
IskayPet 是伊比利亚领先的宠物护理公司,以 Kiwoko、Tiendanimal、Kivet、Clinicanimal 和 Animalis 等品牌在西班牙、葡萄牙和法国运营着 330 多家门店。IskayPet 拥有 4,500 多名员工和 700 万客户,业务横跨零售、兽医诊所、动物护理、采购以及人事与入职。每个领域都有各自的政策和流程,涵盖西班牙语、葡萄牙语、法语和英语。
挑战
在所有业务领域,IskayPet 的办公人员都要手动搜索数百份 SharePoint 文档,来回答有关流程、政策、合同和入职的运营问题。由于业务分布在三个国家、使用四种语言,这耗费了大量时间,而且答案往往过时或错误。
此前没有查询企业知识的可靠方法,而且每新增一个国家、一个领域或一份文档,问题都会随之加重。IskayPet 需要一个能够实现以下功能的解决方案:
- 基于其自有企业文档回答自然语言问题。
- 跨四种语言工作,无需维护多套独立系统。
- 将每个问题路由到正确的知识体系(某个领域、某个国家),避免交叉污染。
- 扩展到新的领域和国家,而无需重新设计架构。
- 注明来源,让员工能够信任并验证答案。
- 复用其现有的 SharePoint 文档库,无需昂贵的迁移。
为什么选择 Amazon Bedrock Managed Knowledge Bases
IskayPet 选择 Amazon Bedrock Managed Knowledge Bases 是因为其托管式 RAG 基础设施,免除了自行运行向量存储、嵌入或摄取管道的需要。主要原因如下:
- 托管式 RAG: Amazon Bedrock 负责数据摄取、多模态解析、向量存储、嵌入生成和检索。IskayPet 只需为实际存储和检索的内容付费。
- 原生 SharePoint 连接器: 该连接器直接从 IskayPet 现有的 SharePoint 环境摄取文档,避免了数据迁移。启用高级索引后,它还能处理文档中嵌入图片的内容。
- 内置混合搜索: 以零额外成本结合语义搜索和关键词(BM25)搜索,可找回纯语义搜索可能遗漏的精确词条,例如产品编码和编号。
- 托管重排序: 检索到的段落会按相关性重新排序,无需额外付费。
- 文档级访问控制: 知识库可以在检索时强制执行源系统自身的权限,因此查询只会返回请求用户已有权限阅读的文档中的段落。这让 IskayPet 得以复用 SharePoint 权限,而无需重建一套授权模型。
- 模型灵活性: IskayPet 可以先使用高性价比的模型,之后无需重写基础设施即可更换。
- 原生 RAG 评估: 团队使用内置的评估工具在每个步骤衡量质量。
解决方案概览
下图展示了端到端流程:从员工提问,经过具有权限感知的检索,到生成有依据、带引用的答案。
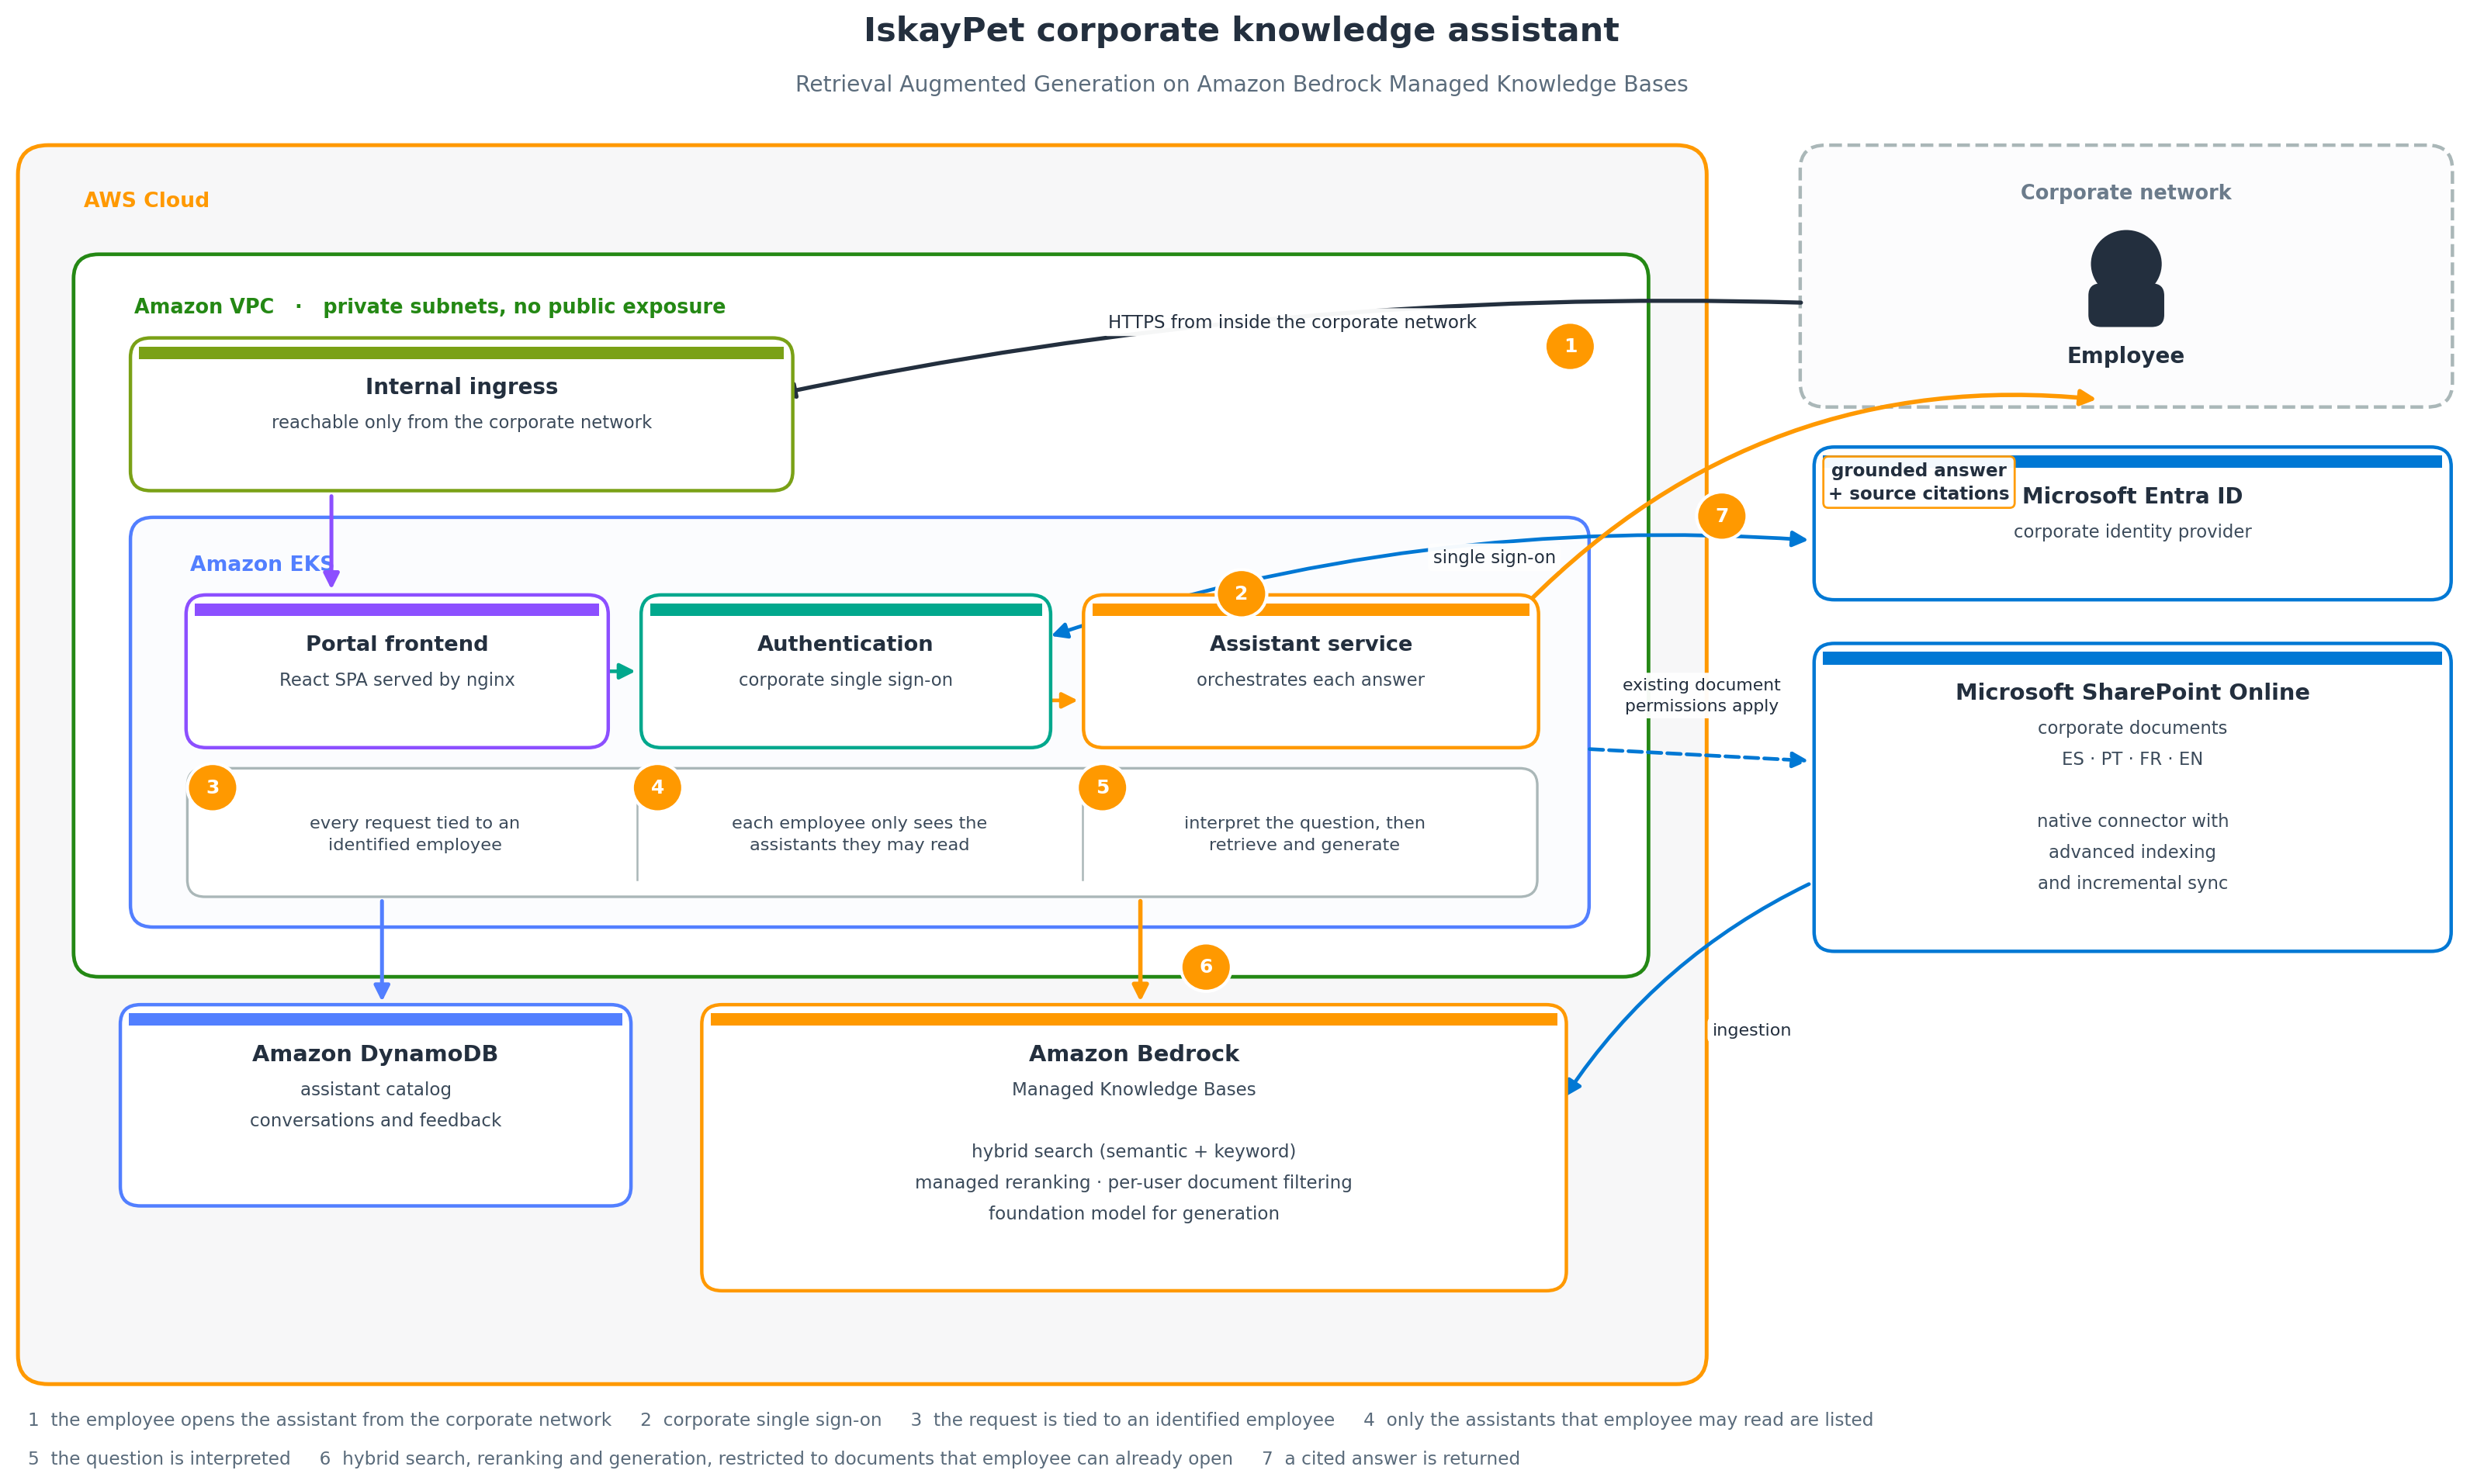
图 1:解决方案架构
该解决方案是一个助理,员工通过现有渠道访问。当员工提问时,助理会从其知识库中检索最相关的段落,范围限定在该员工有权阅读的文档内,然后以员工使用的语言生成有依据、带引用的答案。
概括来说,流程如下:
- 员工通过聊天界面提交一个自然语言问题。
- 应用程序为所请求的助理调用知识库,传入员工的身份,以便在检索时应用文档级权限。
- 知识库对已索引的内容执行混合搜索(语义和关键词),对结果重排序,并返回最相关的段落及其来源引用。
- 一个基础模型(FM)根据检索到的段落生成有依据的答案。提示词要求注明来源引用,并告知模型在答案不在检索内容中时要如实说明。
- 员工收到答案以及来源文档,并可留下反馈(点赞或点踩),这些反馈会进入评估集。
使用 Kiro 和 Claude Haiku 4.5 构建解决方案
IskayPet 使用在 Amazon Bedrock 上运行的 Claude Haiku 4.5 的智能体开发环境 Kiro,构建了整个解决方案,从面向门店的前端到 AWS 架构和服务部署。随着 Amazon Bedrock 上新模型的推出,IskayPet 计划针对每个用例评估并采用这些新模型。
有关各 AWS 区域可用的模型,请参阅 Supported models by AWS Region in Amazon Bedrock。
- 面向门店的前端 – 团队使用 Kiro 构建了门店员工用来与助理交互的前端,并借助 Claude Haiku 4.5 生成 UI 代码并进行迭代。
- 架构与部署 – Kiro 还帮助设计了 AWS 架构并预置了解决方案背后的服务:知识库配置、数据源、AWS Identity and Access Management (IAM) 角色以及应用层。
借助 Kiro 和 Claude Haiku 4.5 这样快速且高性价比的模型构建的智能体工作流,帮助一个小团队快速从概念走向生产环境,同时保持应用程序代码和基础设施的一致性与可维护性。
数据摄取:具备高级索引功能的 SharePoint 连接器
IskayPet 的文档本来就已经存放在 SharePoint 中,按地区和国家进行了组织。团队没有迁移这些文档,而是使用了 Amazon Bedrock Managed Knowledge Bases 中的原生 SharePoint 连接器。
在数据源的高级配置中,在内容索引和高级索引下,IskayPet 启用了文档中的可视化内容。此设置会从文档(PDF、DOCX、PPTX)中嵌入的图像以及独立图像中提取内容。流程文档中的图表和扫描内容因此变得可搜索,无需单独的预处理流水线。
该连接器以增量方式同步,因此每次同步都会拾取新增和更新的文档。
多国家、多地区架构
一个关键的设计决策是如何为四种语言、多个业务领域和三个国家组织知识结构。IskayPet 权衡了两种方案:
- 单一共享知识库,每个文档按国家和地区打标签,并在每次查询时应用检索过滤器。这能最大化共享内容的复用,但会把所有领域耦合到同一个索引中。
- 每个助手使用专属的知识库,各自限定于相关的 SharePoint 网站或文档库。这样可以将每部分知识端到端地隔离,并让每个助手独立调优。
IskayPet 选择了每个助手一个知识库的方案。每个助手指向特定的 SharePoint 网站,并且可以通过包含路径进一步限定到特定的文档库或文件夹,因此它只索引目标内容,而不是整个公司网站。新增一个地区或国家只需添加一个助手并将其指向相应内容,而无需重新架构系统。
访问控制
访问由用户现有的 SharePoint 权限管理。助手不会授予任何新的访问权限:它只是让员工更方便地查询他们本来就能打开的文档。这在两个层面上生效。
- 用户能看到哪些助手 – 员工只能看到其有权阅读其底层文档的助手,无论这种权限来自直接授权、组成员身份,还是对特定文件夹的访问。如果无法确认访问权限,该助手会被隐藏而不是显示。
- 哪些文档会构成答案 – 在检索时还会逐个文档再次执行访问控制:员工的身份会被传递给知识库,知识库只返回该员工有权查看的文档中的片段。Amazon Bedrock Managed Knowledge Bases 原生支持这种文档级访问控制,因此对同一个问题的相同回答,在两个权限不同的员工之间可以合理地有所不同。
由于每次访问检查都会从 SharePoint 读取权限,因此在 SharePoint 中撤销或授予访问权限会即时反映到助手中,无需更改应用程序。
检索与生成配置
RAG 系统的质量主要取决于摄取、检索和生成环节。微调则是一种辅助技术。针对这个用例,IskayPet 调整了以下设置:
- 分块 – 由托管知识库处理,因此团队无需构建或调优分块流水线。这省去了自托管 RAG 中通常需要大量运维投入的一个组件。
- 混合搜索 – 知识库结合了语义检索和关键词检索,可以找回纯语义搜索可能遗漏的精确词汇,例如产品代码。
- 结果数量 – 根据评估集进行调优。助手检索 25 个段落,在去除重复项和过短而无法提供上下文的片段后,最多将 15 个注入提示词中。这个数字是主要的成本杠杆,因为它会在每次提问时成倍增加输入 token。
- 生成提示词 – 强制使用企业语调,要求注明来源引用,并告知模型在检索内容中没有答案时要如实说明,从而减少幻觉并增强可追溯性。
作为生产环境控制手段,团队正在添加 Amazon Bedrock Guardrails,以便对生成的答案应用内容过滤和负责任的 AI 政策。
- 评估 – 使用 Amazon Bedrock 原生 RAG 评估,将真实使用中的点赞和点踩反馈作为评估集,在每次变更前后衡量质量。
生成响应
在答案生成方面,IskayPet 使用了 Amazon Bedrock 上一款高性价比的基础模型。由于知识库将检索与生成解耦,IskayPet 可以在不改动摄取层或检索层的情况下切换或升级生成模型。这让团队能够随着使用量的增长平衡成本与答案质量。
成本效率
知识库以无额外收费的方式提供多模态解析、嵌入生成和重排序,因此 IskayPet 的持续成本主要来自索引存储、检索 API 调用和生成模型 token。在生产环境中,由于每个提示词都会注入段落,输入 token 在成本中占主导地位。随着使用量增长,团队正在评估进一步的优化方案,包括针对提示词稳定部分进行提示词缓存,以及针对非交互式工作负载使用批量推理。
成果
在生产环境运行的前两个月里,IskayPet 取得了如下成果:
- 更快的回答 – 查找运营类答案的时间从 3–5 分钟缩短到约 7 秒。
- 更高的生产力 – 在查找流程和政策上花费的时间减少约 95%。
- 规模 – 该解决方案预计每月可处理来自所有业务领域和国家/地区的大约 100,000 次查询。
结论
IskayPet 基于 Amazon Bedrock 托管知识库构建了生产级企业知识助手,覆盖三个国家、四种语言和多个业务领域,且无需运维任何 RAG 基础设施。原生 SharePoint 连接器复用了他们现有的存储库。每个助手配备专属知识库的设计使各领域的端到端隔离清晰明了。托管的解析、嵌入和重排序让运维投入和成本都保持在较低水平。使用 Kiro 和 Claude Haiku 4.5 构建前端和 AWS 架构,让一个小团队得以快速上线生产。
如果你正面临类似的知识检索挑战,可以从 AWS 免费套餐开始,在 Amazon Bedrock 控制台上构建你的第一个知识库。想深入了解,请参阅以下资源,并针对你自己的文档试用 SharePoint 连接器和文档级访问控制。
欲了解更多,请参阅 Amazon Bedrock 托管知识库和使用 Amazon Bedrock 评估来评估 RAG 源的性能。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com