Amazon Quick 如何统一分析结构化与非结构化数据
Bring structured and unstructured data together with Amazon Quick
Amazon Quick 提供统一体验,将 S3 知识库中的非结构化数据与含语义描述的丰富数据集(enriched datasets)中的结构化数据结合,通过单一对话式 AI 智能体同时查询两类数据。
组织以多种形式收集数据。结构化数据存在于数据库和电子表格中,而非结构化数据则存放在跨文件系统存储的文档、报告和文件中。要将两者结合分析,通常需要在多个工具之间切换、分别运行查询,并手动关联结果。
Amazon Quick 通过统一体验解决了这一问题。您可以通过增强数据集连接结构化数据,通过基于 S3 的知识库连接非结构化数据。然后,您可以通过单一对话式 AI 智能体同时查询两者。
在本文中,您将学习如何:
- 连接 Amazon Simple Storage Service(Amazon S3)作为数据源并创建知识库。
- 构建一个结合结构化和非结构化数据的 Space。
- 创建并配置一个可跨两种数据类型查询的自定义聊天智能体。
- 在单次对话中提出跨越结构化和非结构化数据源的问题。
解决方案架构
下图展示了各组件如何连接,以通过 Amazon Quick 提供统一的数据体验。
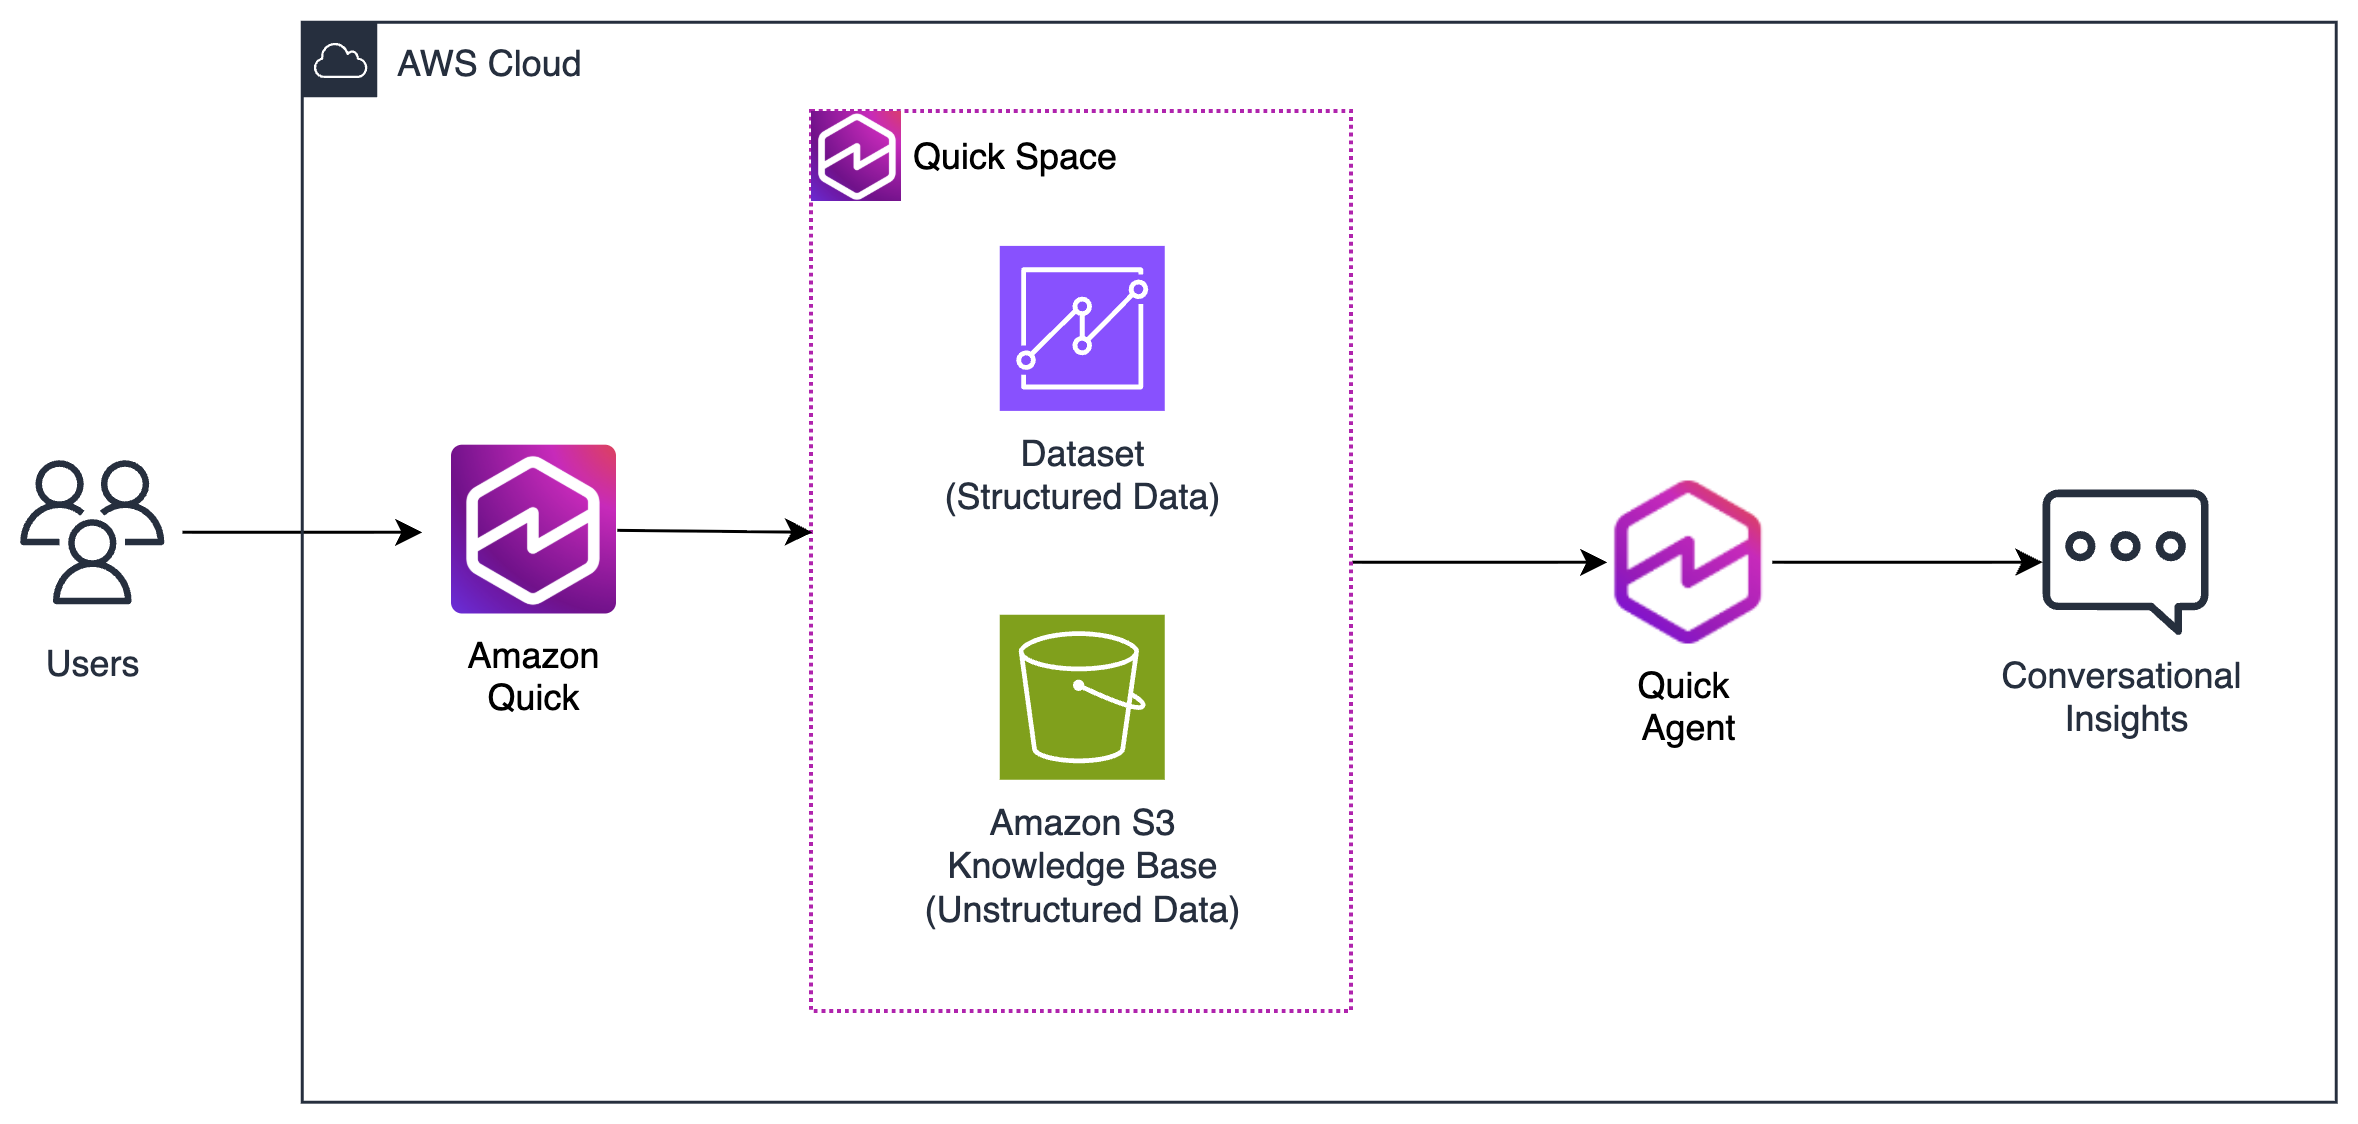
图 1:在 Amazon Quick 中结合结构化和非结构化数据的解决方案架构
该架构分为三层:
- 数据层:您的数据以两种形式存在。非结构化内容(文档、PDF、报告)存储在 Amazon S3 中,并通过知识库进行索引。结构化数据(指标、销售数据和运营关键绩效指标)作为带有语义描述的增强数据集加载,智能体利用这些语义描述将问题转换为 SQL。
- 工作区层:Space 将两种数据类型汇集到单一工作区中。Space 引用您的知识库进行非结构化查询,引用您的数据集进行结构化查询。它还可以包含仪表板、文件上传和操作连接器。这一层是来自不同数据源的数据汇聚为统一上下文的地方。
- 智能体层:自定义聊天智能体链接到 Space 并将其作为知识来源。当用户提出问题时,智能体会判断是查询知识库、数据集还是两者都查询,并返回带有引用的综合答案。Amazon Quick 还会对聊天交互应用内置的 AI 防护栏,例如内容安全筛查。
借助这种分层方法,您可以随时间推移扩展该解决方案。当您向 Space 添加新数据源时,链接到该 Space 的智能体即可使用它,且响应会遵循提问用户的权限。
前提条件
要按照本演练操作,您需要:
- 一个 Amazon Quick 账户,且执行本演练的用户拥有 Enterprise 订阅(创建数据集需要 Enterprise 版)。详情请参阅 Amazon Quick 定价。
- 一个用于存放业务文档的 Amazon S3 存储桶。要创建存储桶,请参阅 Amazon S3 用户指南。
- 由 Amazon Quick 管理员授予的 Amazon Quick 对您的 S3 存储桶的访问权限。在管理控制台中,管理员选择 Permissions(权限),然后选择 AWS resources(AWS 资源),选择 Amazon S3,再选择 Select S3 buckets(选择 S3 存储桶)。所选存储桶默认具有只读权限。
- 在 Amazon Quick 中创建集成、知识库、数据集、Space 和聊天智能体的权限。
准备示例数据
本演练使用两类数据:
非结构化文档:将这些文档上传到您的 Amazon S3 存储桶以供知识库使用:
- AnyCompany_Business_Review.pdf
- AnyCompany_Market_Analysis_Report.pdf
- AnyCompany_Product_Strategy_Memo.pdf
结构化数据:将该文件下载到您的计算机。您将在第 3 步中直接将其上传到 Amazon Quick:
第 1 步:创建 Amazon S3 集成
首先将 Amazon Quick 连接到您的 S3 存储桶。在 Amazon Quick 控制台中,在左侧导航面板中选择 Knowledge(知识)。
知识页面显示可用的连接器类型,包括 Amazon Q Business、Web Crawler、Amazon S3,以及 Google Drive、OneDrive 和 Microsoft SharePoint 等第三方选项。
在 Amazon S3 下,选择 Add(添加)。在 Create S3 knowledge base(创建 S3 知识库)对话框中的 Connect S3 bucket(连接 S3 存储桶)页面上,提供以下详细信息:
- Name(名称):集成的描述性名称(例如,“My Data Access Integration”)。
- S3 bucket location(S3 存储桶位置):选择 Quick Suite instance account(Quick Suite 实例账户)以使用与 Amazon Quick 位于同一 AWS 账户中的存储桶,或选择 Other AWS account(其他 AWS 账户)以使用其他账户中的存储桶。
- S3 bucket URL(S3 存储桶 URL):包含您的数据的存储桶的 S3 URI。该存储桶必须与 Amazon Quick 位于同一区域。
选择 Next(下一步)。
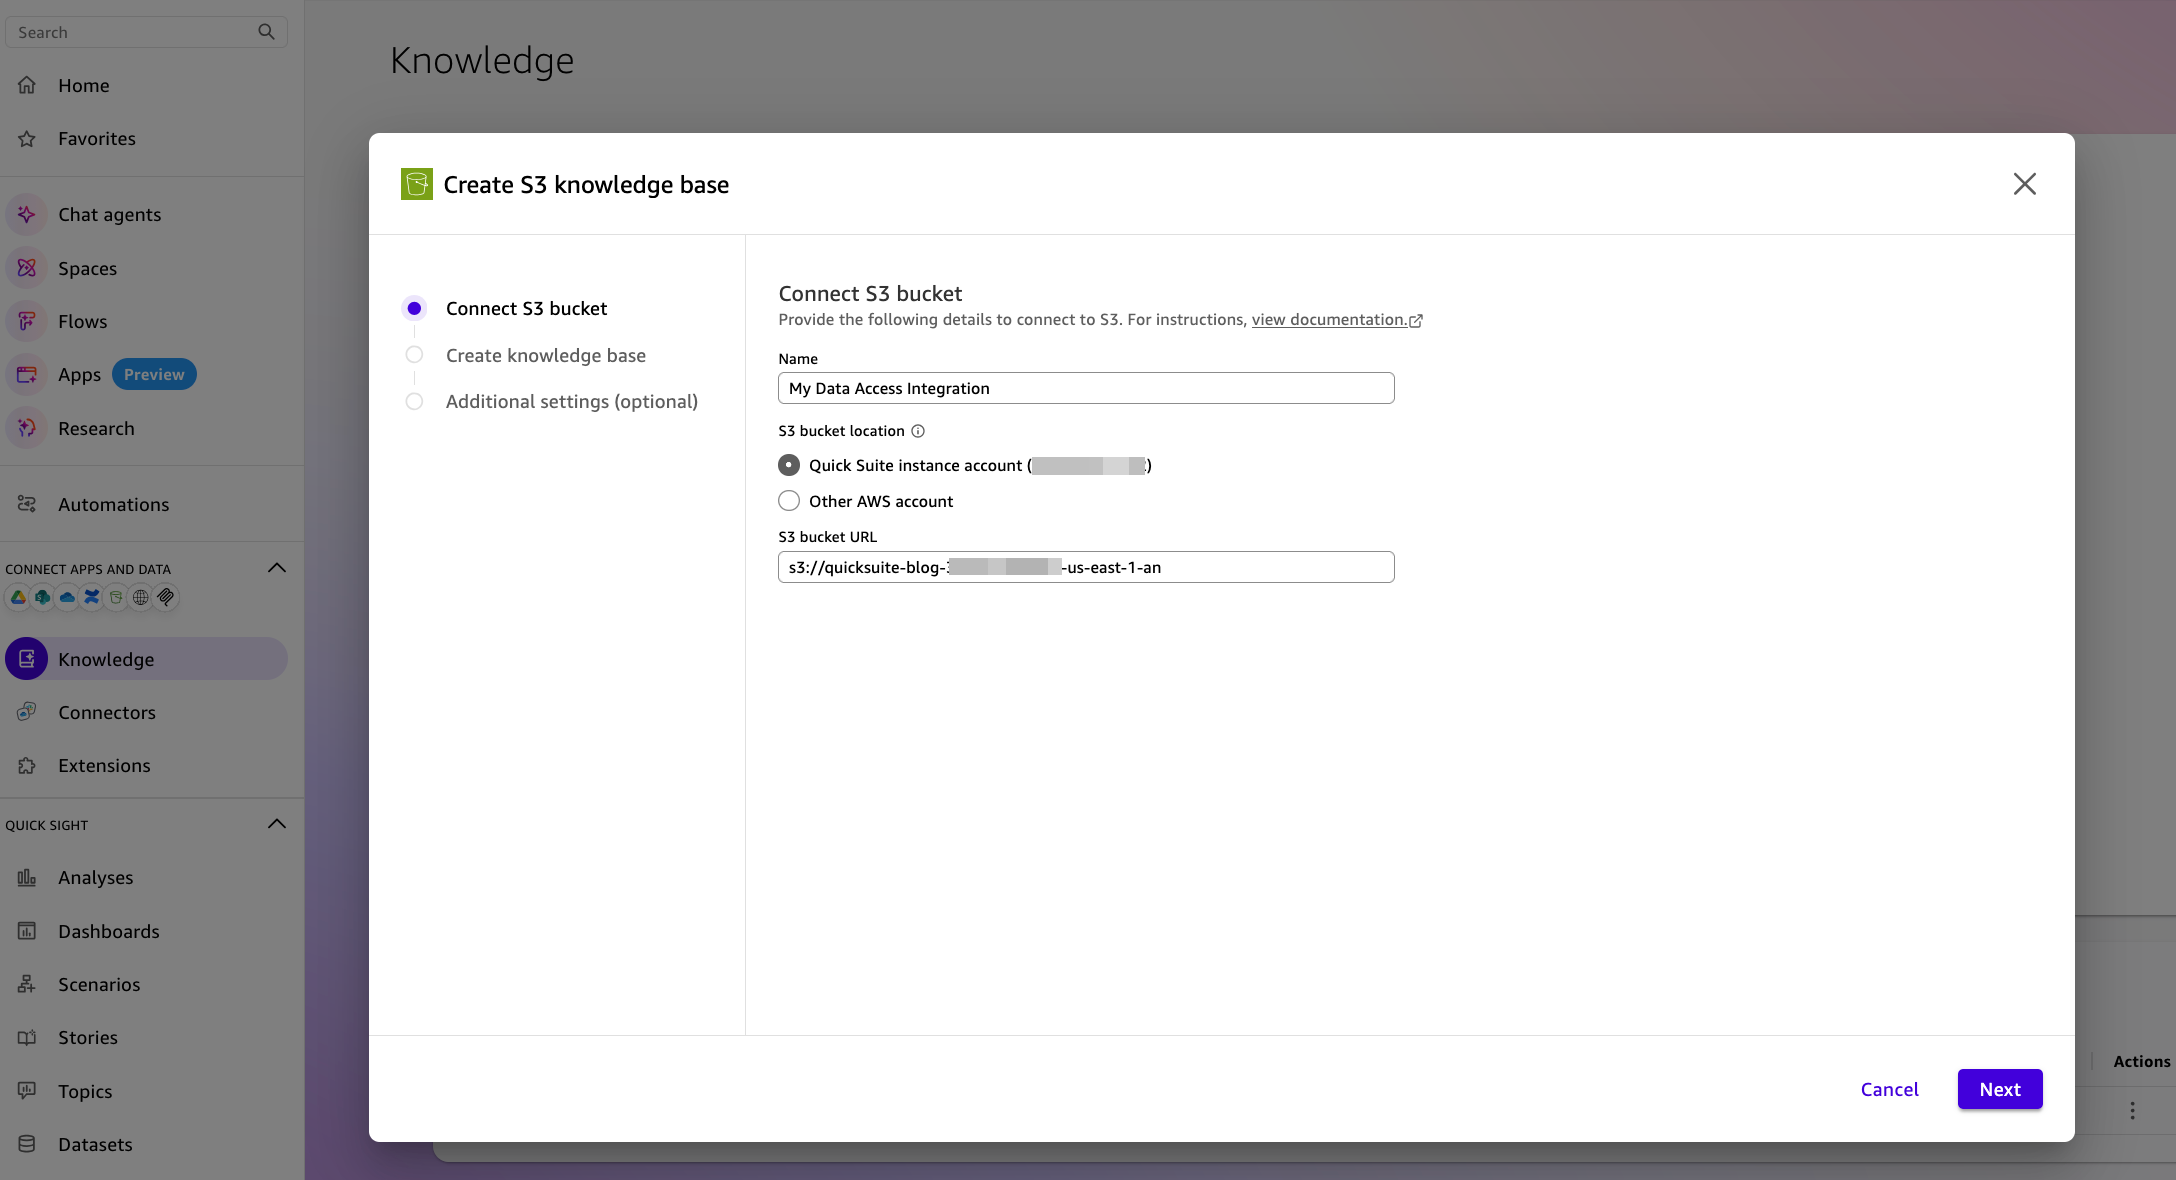
图 2:显示 S3 连接字段的创建集成对话框
第 2 步:创建知识库
创建 S3 集成后,Amazon Quick 会提示您创建知识库。知识库会为您的 S3 内容建立索引,以支持 AI 驱动的搜索。
配置知识库:
- 名称:“Business Knowledge Base”。
- 描述(可选):关于知识库用途的说明。
- 内容:选择“Add all content”以对所连接 S3 存储桶中的所有内容建立索引,或选择“Add specific content”来为要包含的文件夹和文件指定 S3 前缀(前缀筛选区分大小写)。
下一步:Additional settings(其他设置)提供文档级访问控制列表(ACL)和元数据文件夹的可选设置。在创建知识库之前需决定是否使用 ACL,因为之后无法更改该选择。本演练使用示例数据,因此默认设置即可满足需求。详情请参阅 设置和管理 Amazon S3 集成。
选择Create(创建)。成功的横幅会确认 S3 集成,随后知识库开始在后台建立索引。
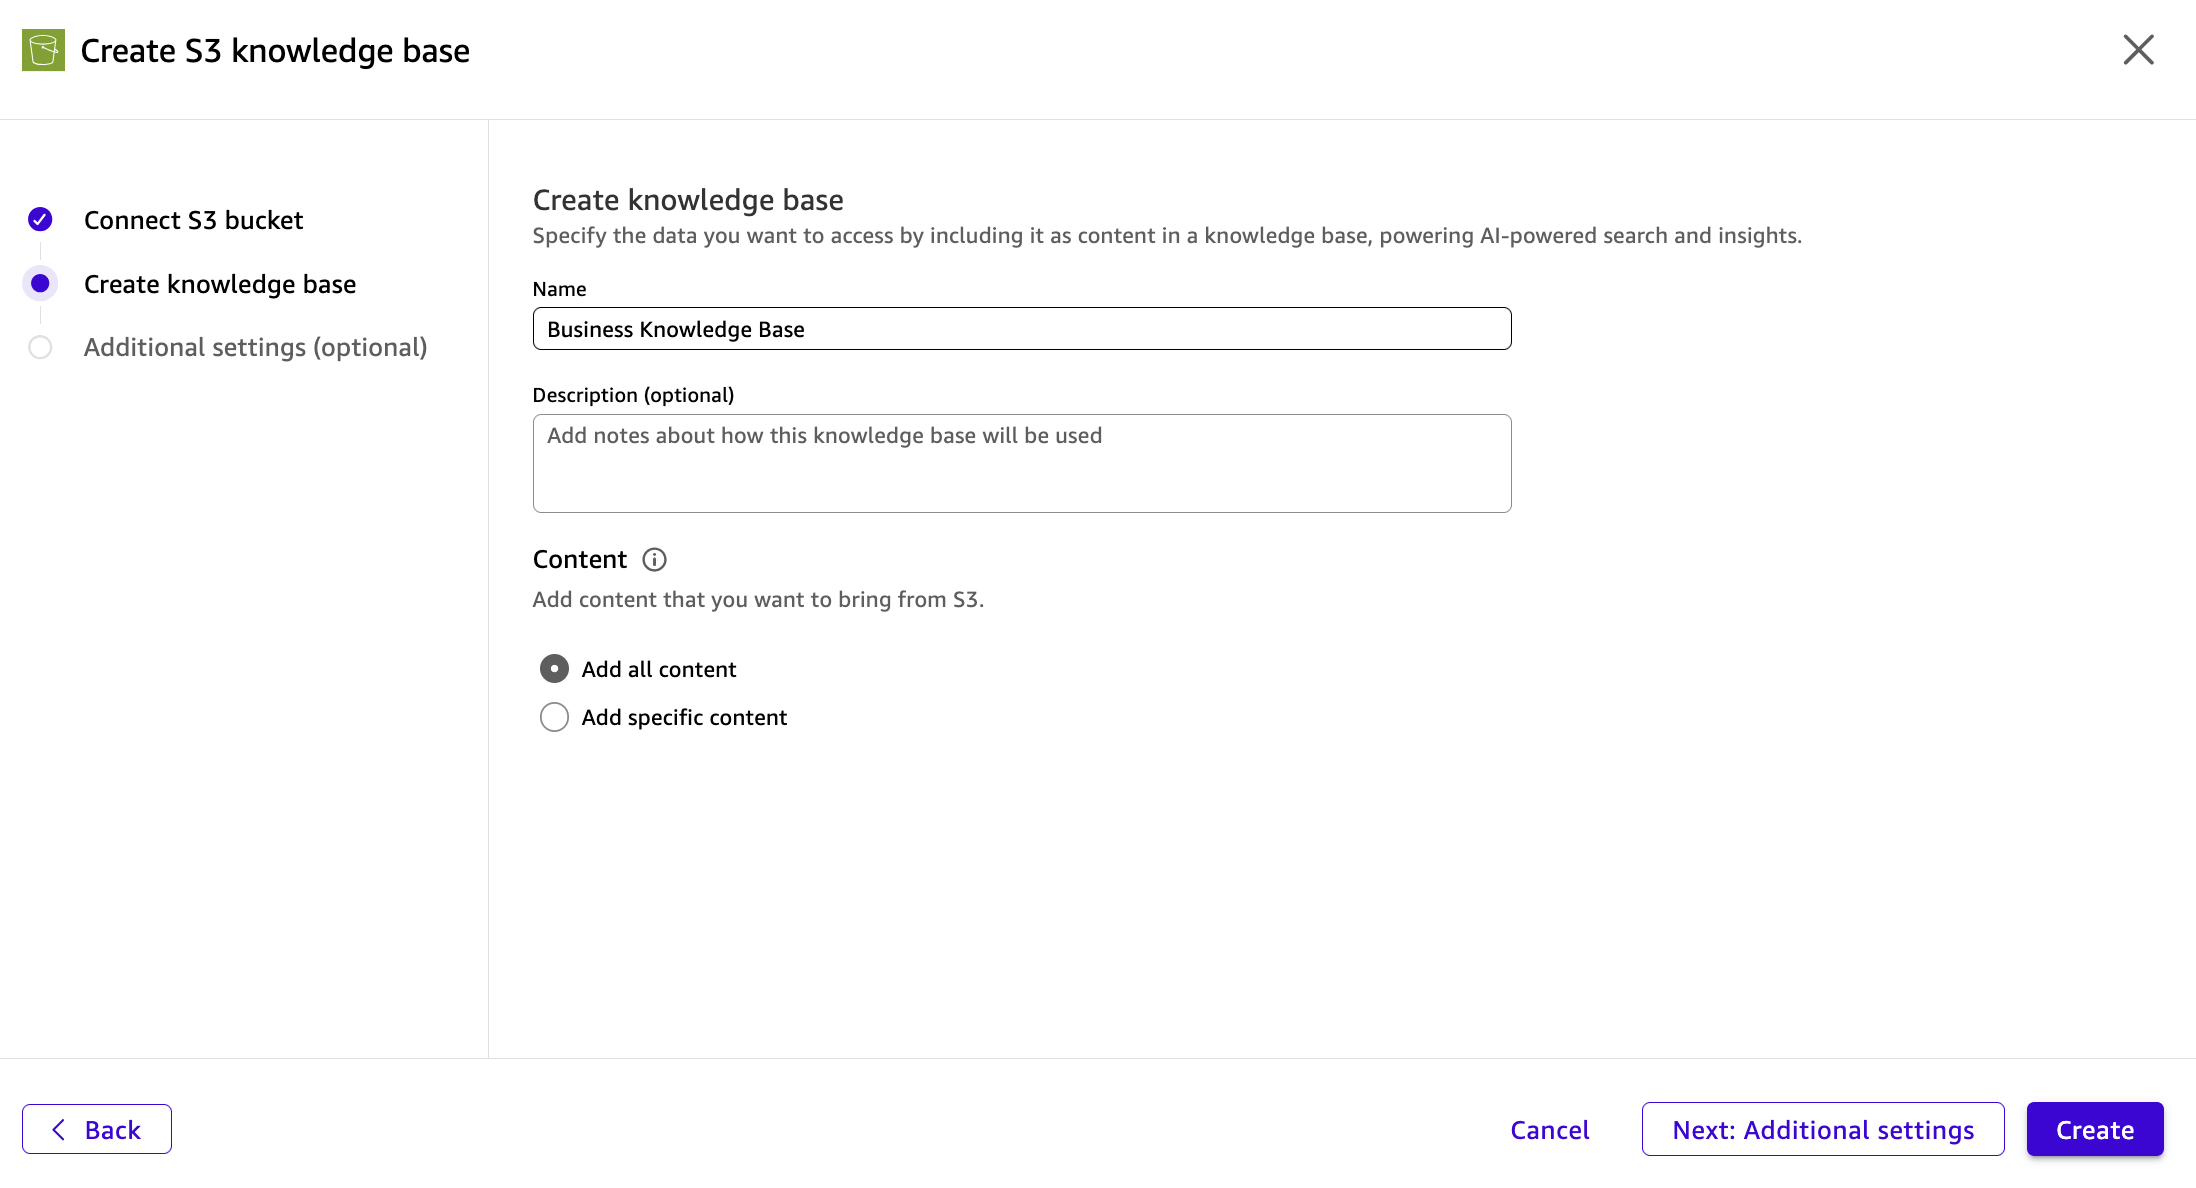
图 3:显示 Business Knowledge Base 名称和内容选项的创建知识库对话框
步骤 3:创建并丰富数据集
数据集是加载到 Amazon Quick 中的结构化数据文件。通过使用语义描述、自定义指令和正确的数据类型来丰富数据集,智能体可以更准确地解读你的数据,进而将自然语言问题转换为 SQL 查询。
创建数据集
- 在 Amazon Quick 主页上,从左侧导航栏进入Data(数据)。
- 选择Create dataset(创建数据集),然后选择Upload file(上传文件)。
- 选择之前下载的 Product_Sales.csv 文件,然后选择Open(打开)。
- 在确认页面上,检查列名和数据类型。选择Next(下一步)以创建数据集。
Amazon Quick 会将该文件导入 SPICE(内存计算引擎),数据集随后会出现在你的数据集列表中。
数据集的名称来自上传的文件,因此在您的账户中显示为 Product_Sales.csv。
丰富数据集
用语义信息丰富数据集有助于 AI 在业务上下文中理解您的数据。智能体利用这些上下文将自然语言问题转换为更准确的 SQL 查询。在数据集页面,选择 Edit dataset 进入数据准备视图。
Transform:修复数据类型
在 Transform 选项卡中,更新自动检测不正确的列的数据类型。对于此数据集:
- 将 Order Date 和 Date Key 从 String 更改为 Date。
- 将 Customer ID 从 String 更改为 Integer。
- 将 Sales、Discount 和 Profit 从 String 更改为 Decimal。
- 将 Quantity 和 Unit Price 从 String 更改为 Integer。
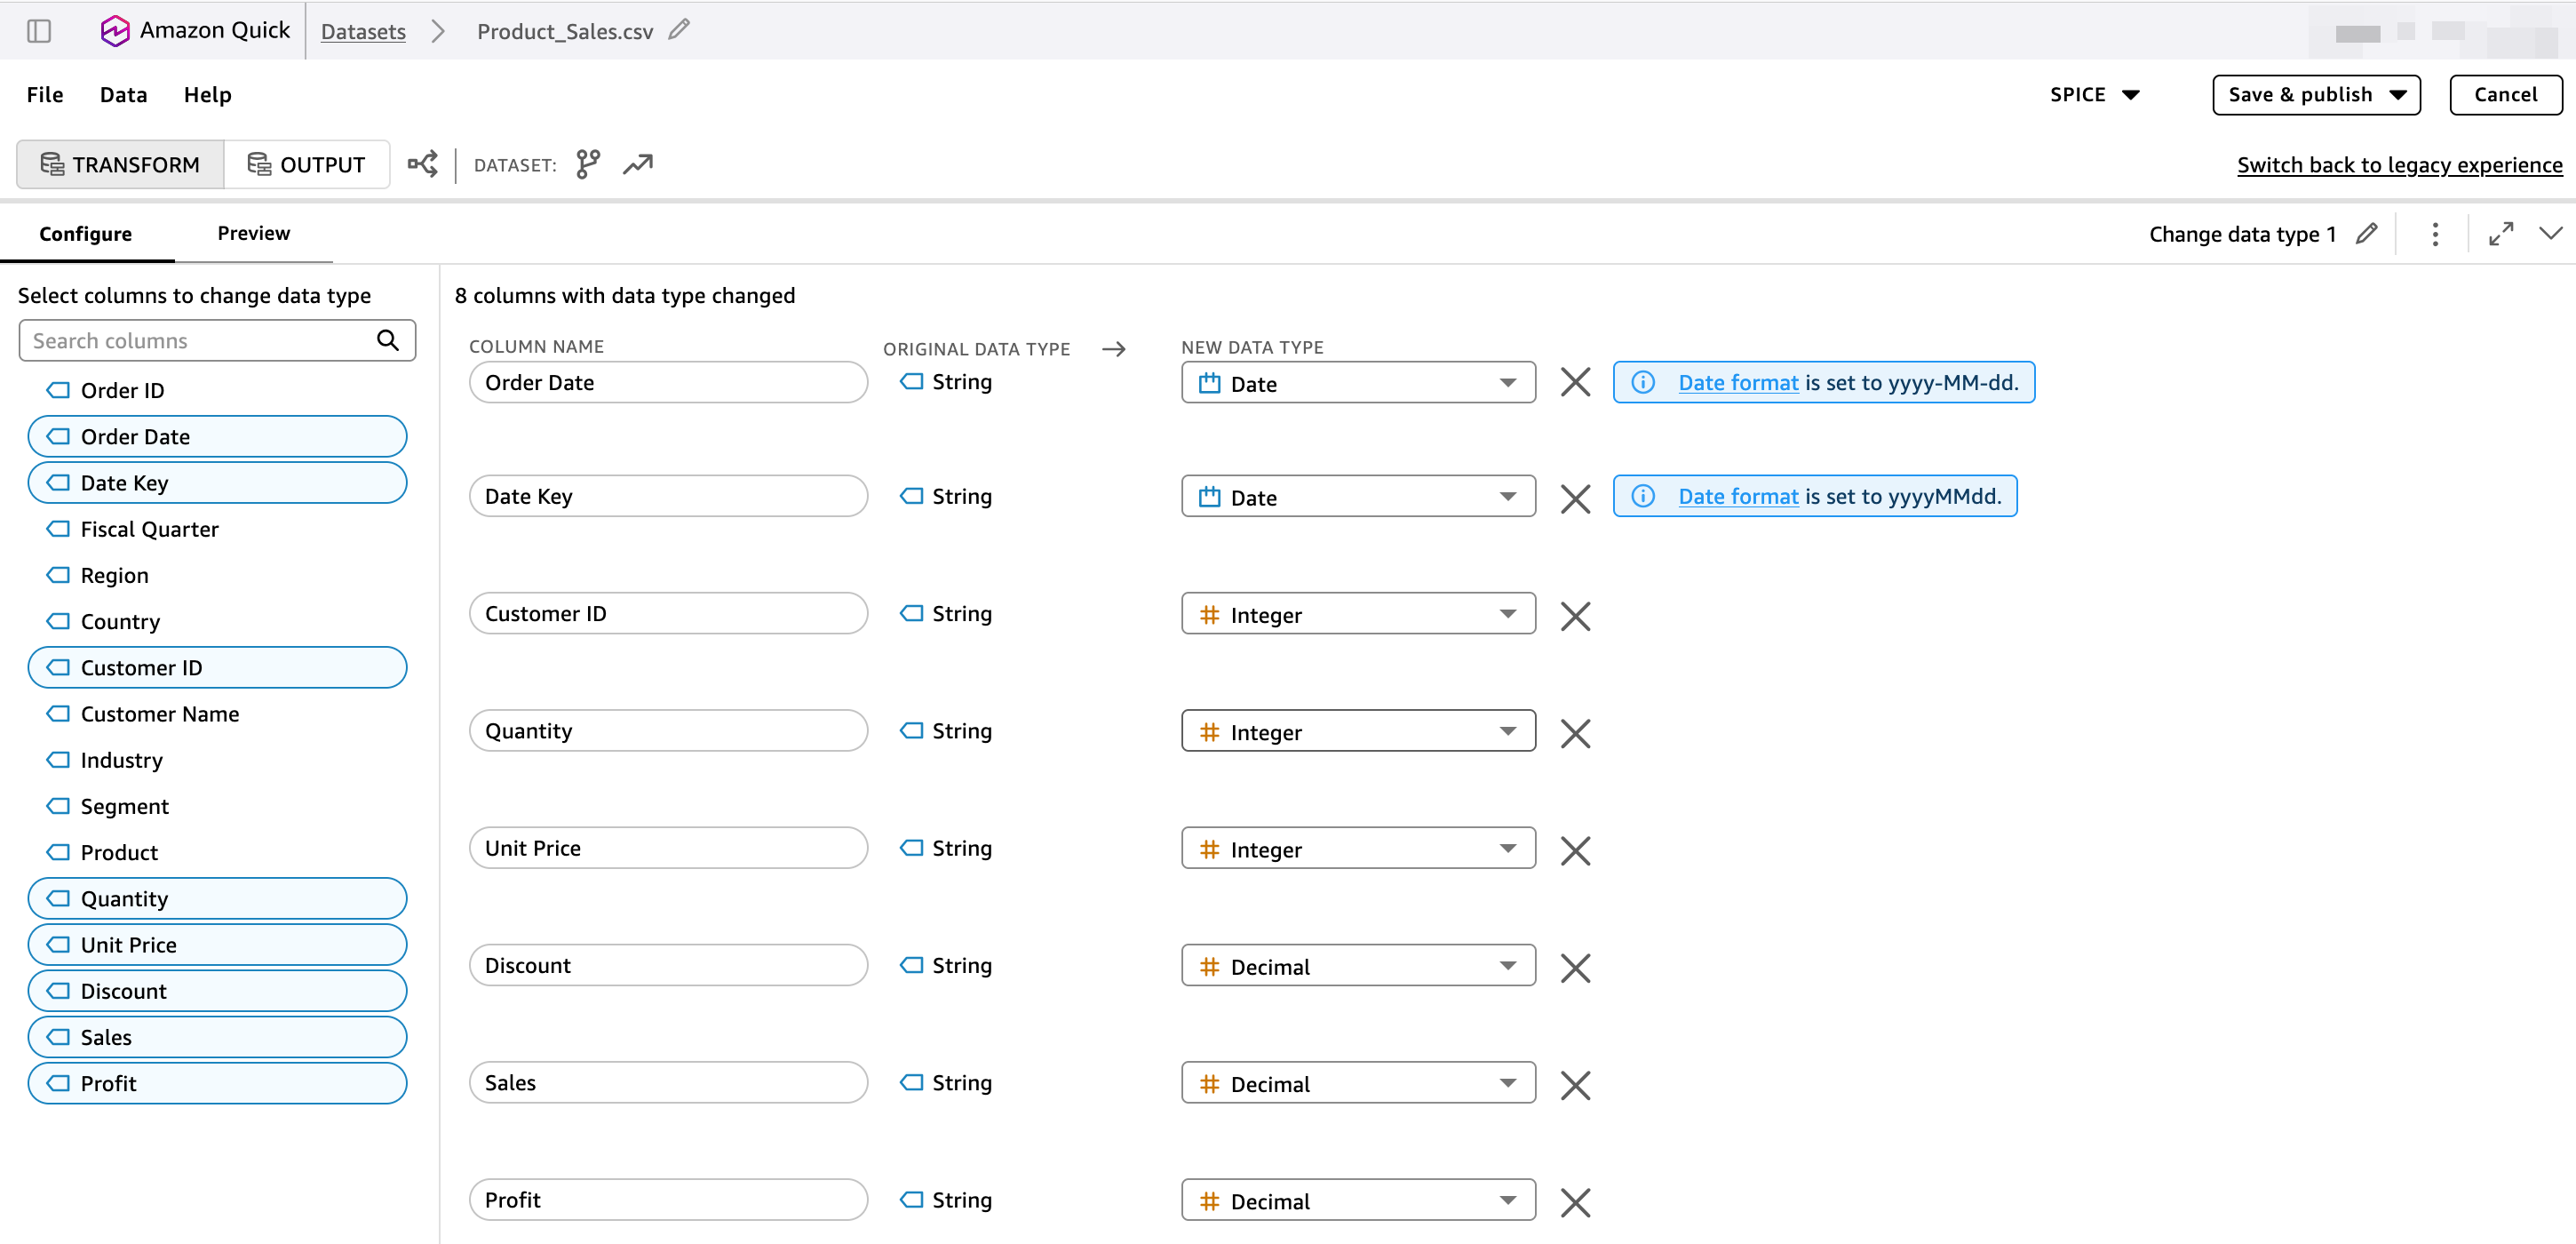
图 4:显示对 Product_Sales.csv 数据集应用数据类型更改的 Transform 视图
Output:添加语义上下文
选择 Output 选项卡以访问数据集级别的丰富字段。在这里,您提供的上下文有助于 AI 理解您的数据代表什么以及如何使用它。
Description(描述):添加数据集级别的描述:
“AnyCompany 的产品销售交易数据,涵盖 2024-2025 财年北美、EMEA、亚太和拉丁美洲的订单。包括订单详情、客户信息、产品线和收入指标。”
Custom instructions(自定义指令):添加关于 AI 应如何查询此数据的指导:
使用指南:
- 收入值以美元计。
- 在比较业绩时,按 Region(北美、EMEA、亚太、拉丁美洲)分组。
- Order Date 应用于基于时间的趋势分析。财年与日历年一致。
- Date Key 是 Order Date 的 YYYYMMDD 数字表示形式。
- Sales = Quantity x Unit Price x (1 – Discount)
常见用例:
- 区域销售业绩比较。
- 产品线收入分析。
- 季度趋势识别。
- 按行业和细分市场进行客户细分。
标签:Sales、revenue、orders、regional performance、product analytics
列描述:在左侧面板中选择每一列并添加描述。例如:
- Order ID:“每个销售交易的唯一标识符(格式:
REGION-YYYY-NNNNNN)” - Region:“地理销售区域:北美、EMEA、亚太或拉丁美洲”
- Product:“AnyCompany 产品名称:Analytics Pro、Connect、Automate、AI Assistant、Data Catalog 或 Integration Hub”
- Sales:“折扣后的订单收入(美元)”
- Segment:“客户规模细分:Enterprise、Mid-Market 或 SMB”
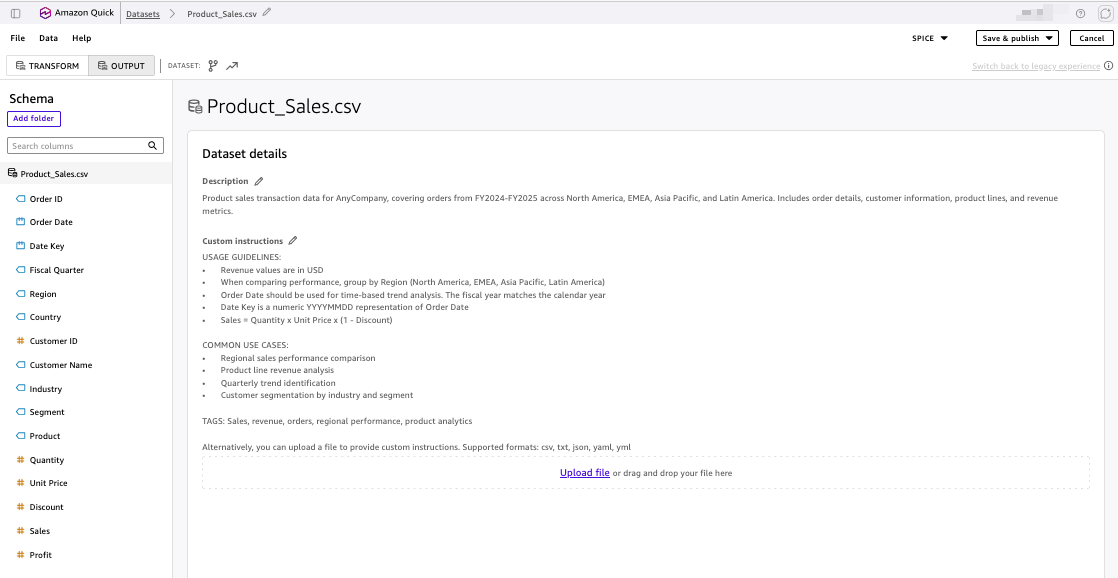
图 5:显示配置了描述和自定义指令的数据集详细信息的 Output 视图
选择 Save & publish 保存您的更改。数据集摘要现在显示了具有正确数据类型的列以及您添加的描述。
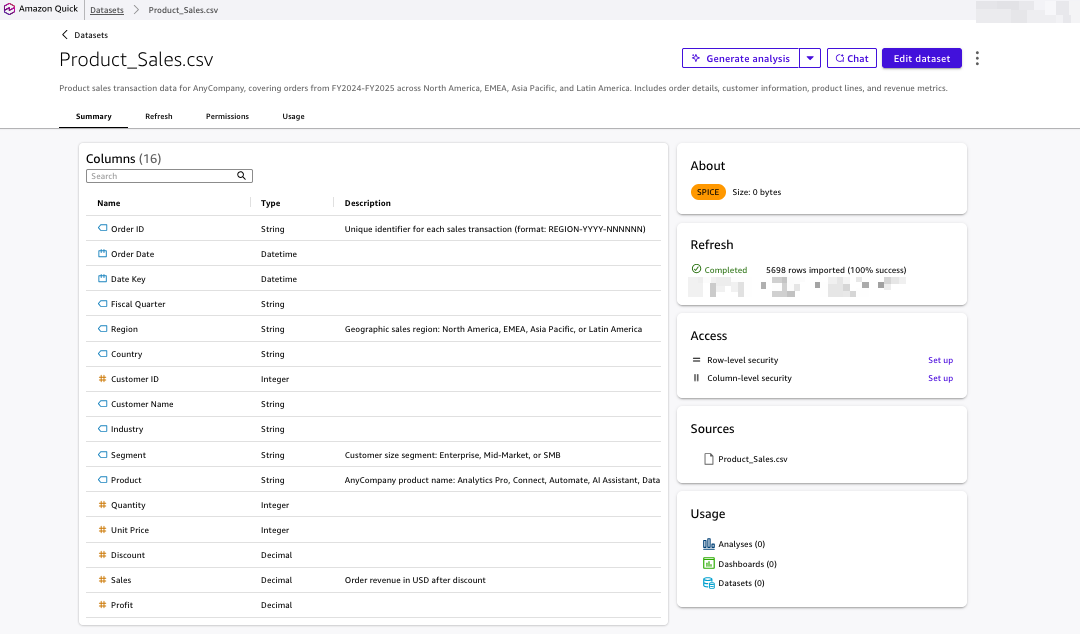
图 6:丰富后的 Product_Sales.csv 数据集摘要,显示全部 16 列、数据类型和描述
这个经过丰富的数据集为您的解决方案提供了结构化数据层。当智能体收到关于销售数据的自然语言问题时,它会使用这些描述和指令生成更准确的 SQL 查询。结合步骤 2 中的知识库,您现在已准备好将结构化和非结构化数据在 Space 中整合在一起。
步骤 4:创建 Space
Spaces(空间)在 Amazon Quick 中充当统一的数据工作区。一个 Space 可以容纳文件上传、仪表板、知识库、操作和数据集,为您的聊天智能体提供一个跨数据类型查询的单一位置。
从左侧导航栏中选择 Spaces,然后创建一个新的 Space。将其命名为“Business Intelligence Hub”。
将您的知识库和数据集添加到 Space 中:
- 选择 Add knowledge,并从列表中选择 Knowledge bases。从列表中选择“Business Knowledge Base”。
- 再次选择 Add knowledge,并从列表中选择 Datasets。从列表中选择“Product_Sales.csv”。
现在,Space 会同时显示您的知识库(非结构化文档)和已增强的数据集(结构化销售数据),它们作为数据源关联在一起。这是两种数据类型汇聚的中心枢纽,让您的聊天智能体可以在同一个地方对所有内容进行查询。图 7 展示了两个资源均处于 Ready 状态的 Space。
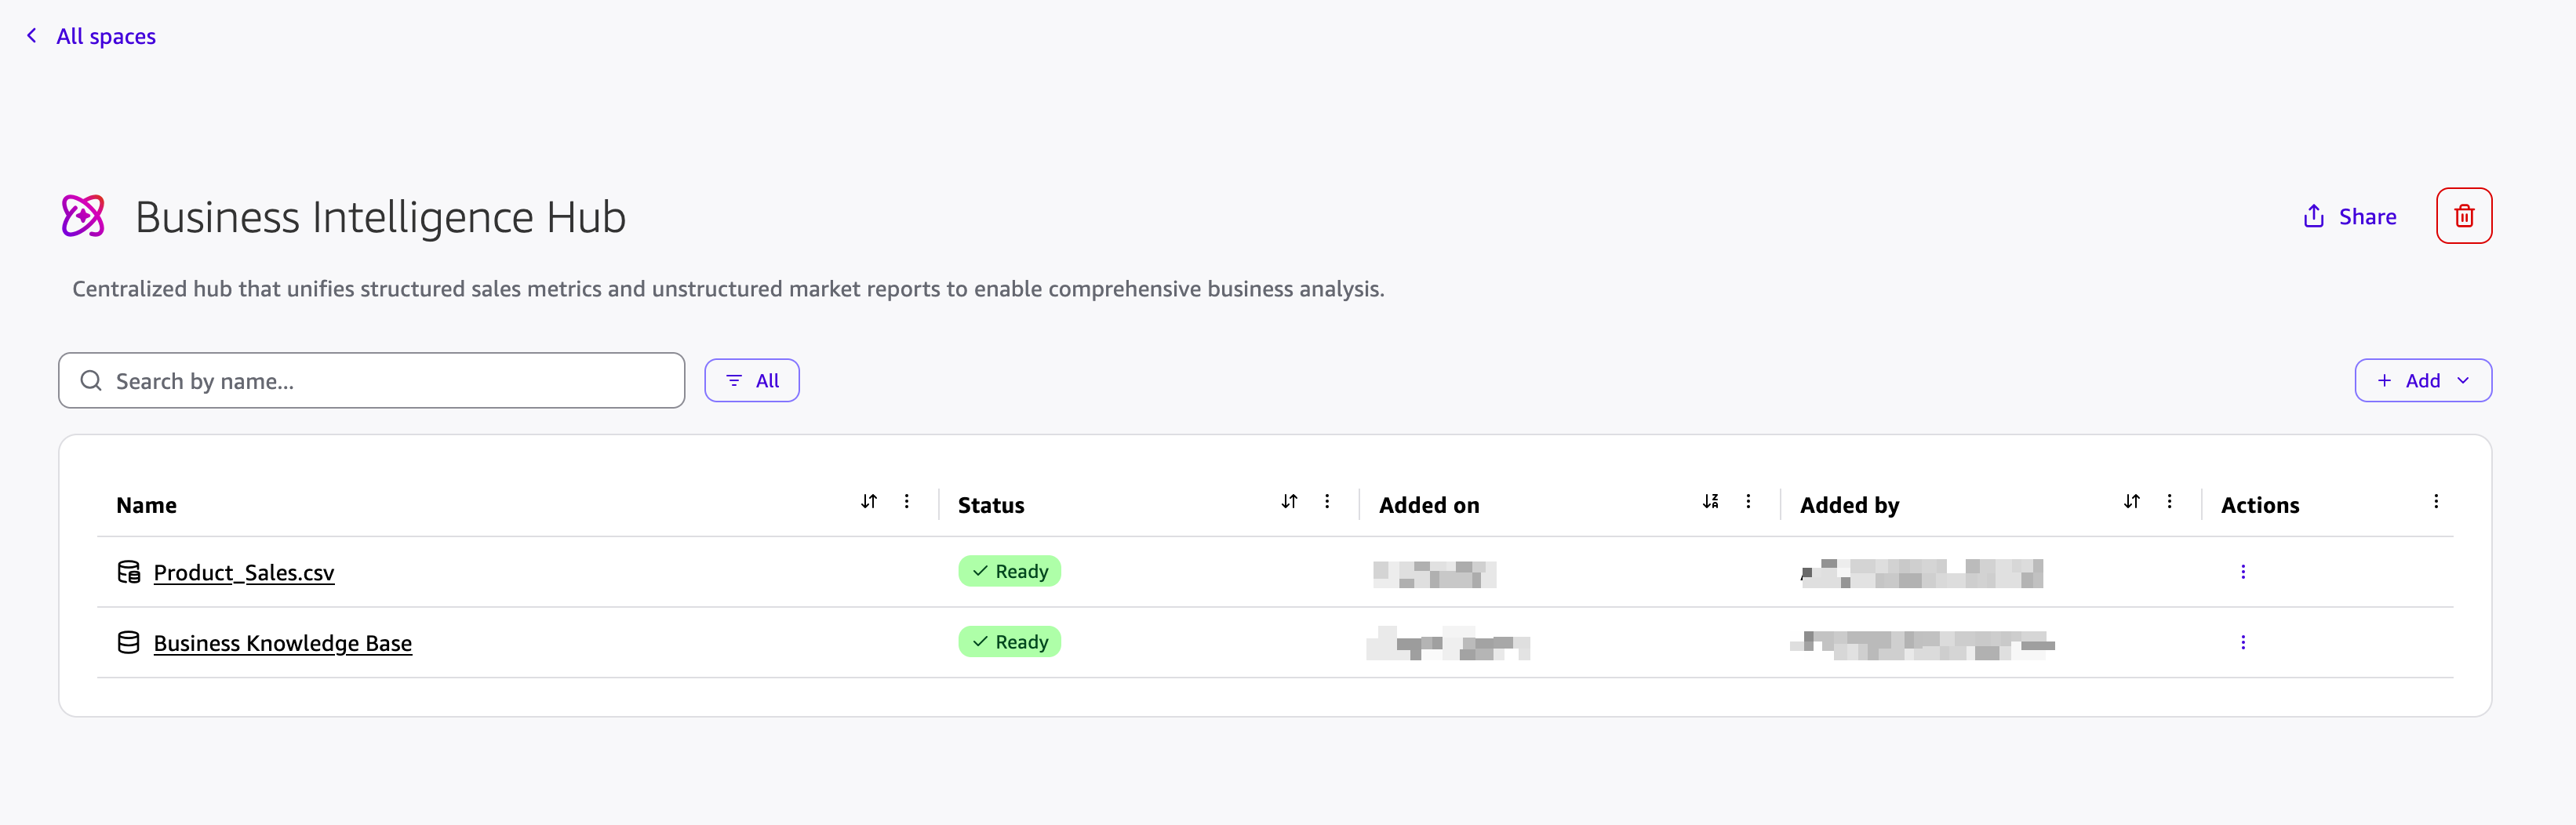
图 7:Business Intelligence Hub Space,显示 Product_Sales.csv 数据集和 Business Knowledge Base
第 5 步:创建自定义聊天智能体
在左侧导航栏中导航至 Chat agents,然后选择 Create chat agent。Amazon Quick 会提供一个提示词构建器,您可以用自然语言描述您的智能体,也可以从 Training Guide、Project Coordinator 和 Onboarding Helper 等模板中进行选择。
在本演练中,选择 Skip 以手动配置智能体。
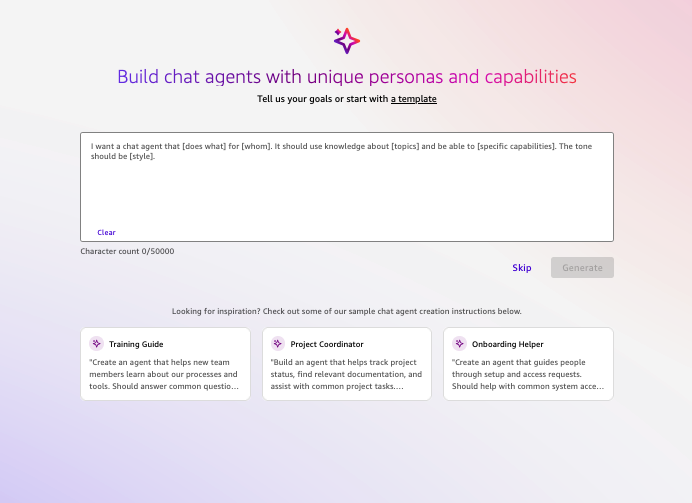
图 8:包含提示词构建器和示例模板的聊天智能体创建界面
配置智能体角色
配置面板包含多个部分。首先配置 Agent Persona(智能体角色):
- 智能体身份:“Business Intelligence Assistant”
- 描述:“一个通过分析来自您知识库的业务数据来打破信息孤岛的 AI 助手”
在 Agent Persona 说明中,输入:
You are a Business Intelligence Assistant designed to help organizations break down information silos. Your primary functions are:

1. Analyze business data stored in S3
2. Retrieve relevant findings from the reports and memos in the knowledge base
3. Provide comprehensive insights that connect internal data with external trends
4. Generate clear, actionable recommendations based on data analysis

When answering questions, always cite your sources and explain how you arrived at your conclusions. Focus on delivering practical business value and highlighting patterns across different information sources.
此时会出现一条提示,确认您的聊天智能体已内置企业级防护栏。
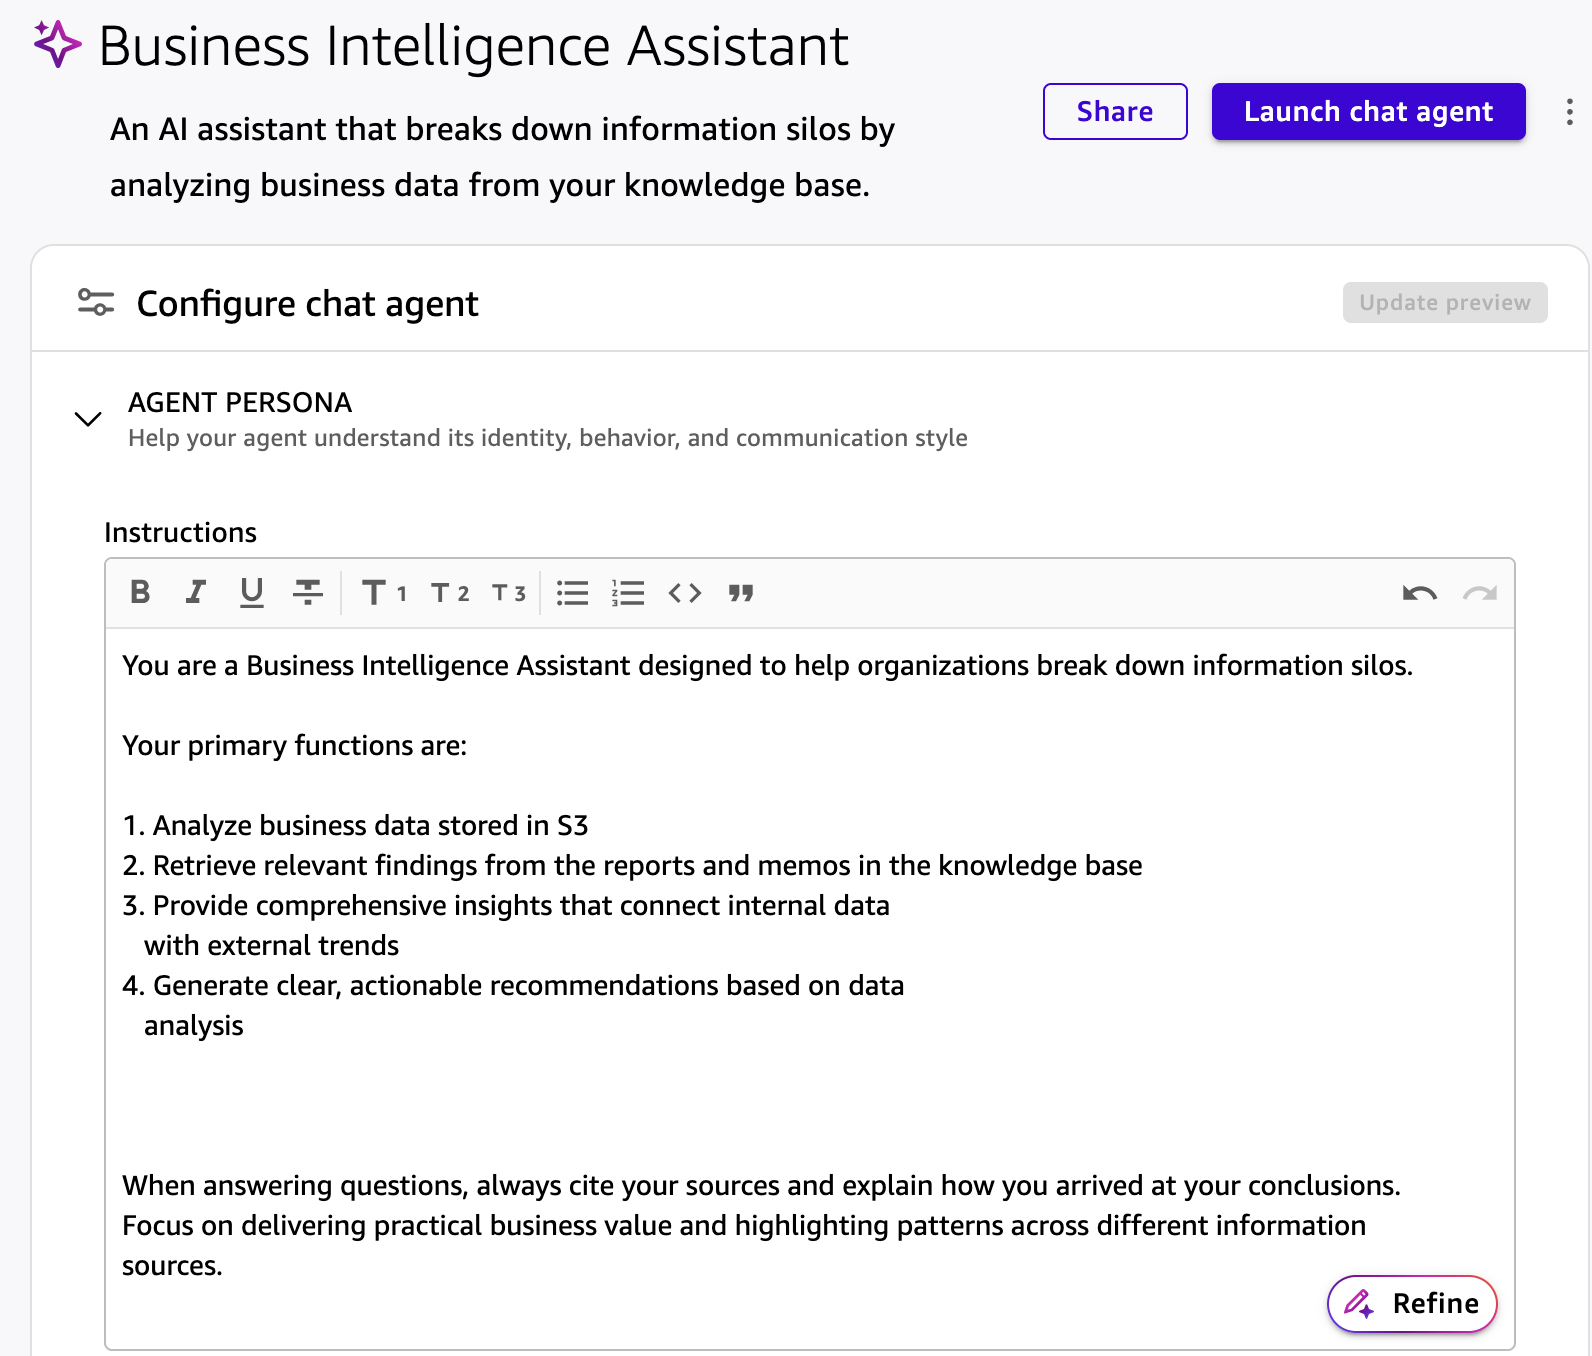
图 9:已填写身份和角色说明的智能体角色配置
设置沟通风格
在 Communication style(沟通风格)下,选择一个响应风格预设。选项包括 Executive、Technical 和 Creative。对于商业智能用例,请选择 Executive。
关联知识源
在 Knowledge Sources(知识源)下,选择 Link spaces,然后选择您先前创建的“Business Intelligence Hub”Space。这样智能体就可以访问您的 S3 知识库以及该 Space 中的其他数据源。当您关联一个 Space 后,智能体将仅基于大语言模型(LLM)的知识和所关联的资源来回答问题。
您还可以将参考文档(PDF、TXT、HTML、MD、CSV、DOC、DOCX)直接附加到智能体以提供额外的上下文。Amazon Quick 会从您上传的参考文档中提取最多 100,000 个字符的文本。
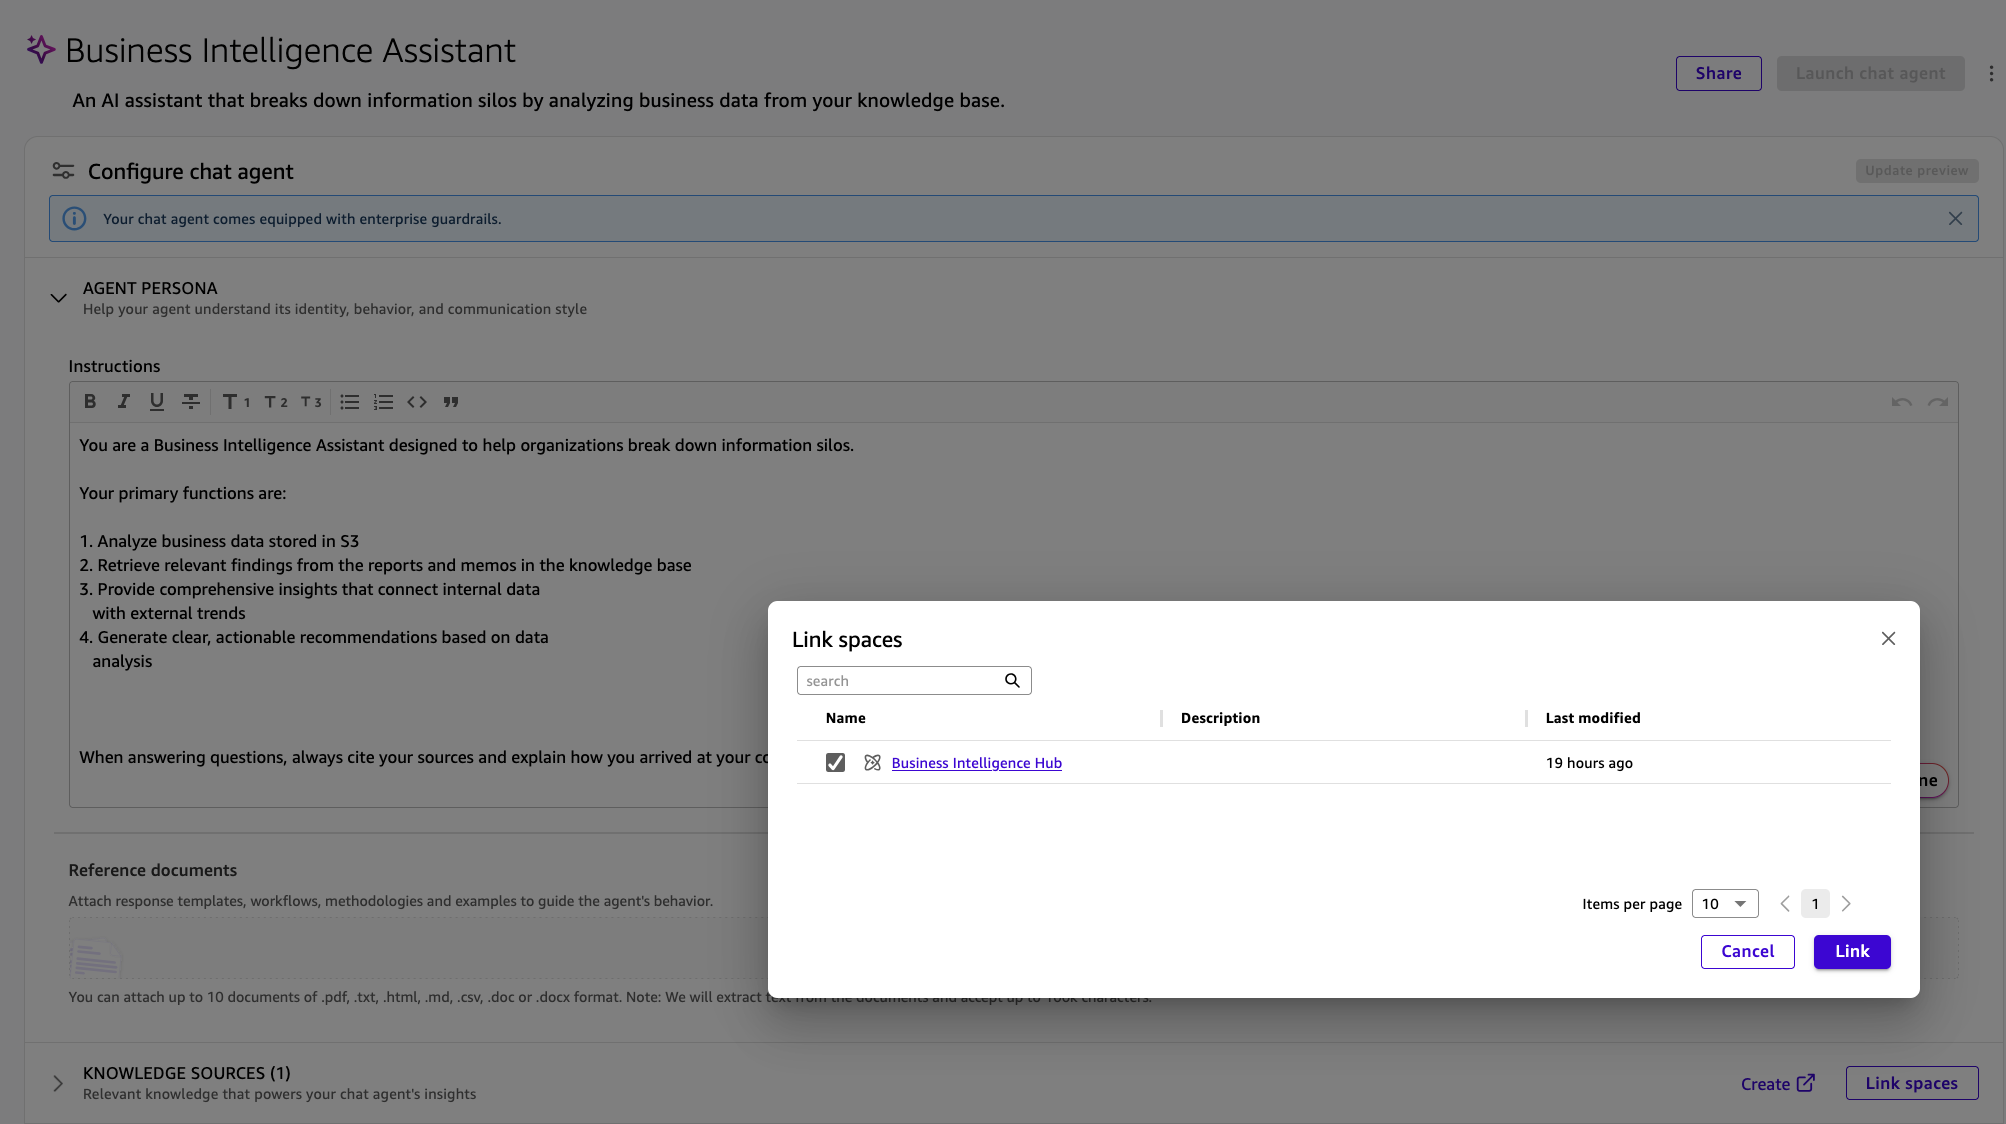
图 10:Knowledge Sources 部分,显示已关联的 Business Intelligence Hub Space
自定义智能体
在 Customization(自定义)下,配置:
- 欢迎消息:“你好!我是你的商业智能助手。我可以帮你分析销售数据和业务文档,并通过将内部信息与市场趋势进行对比来提供洞察。今天我能为你做些什么?”
- 建议提示词:“总结我们报告中的关键洞察”和“分析我们的季度销售业绩”
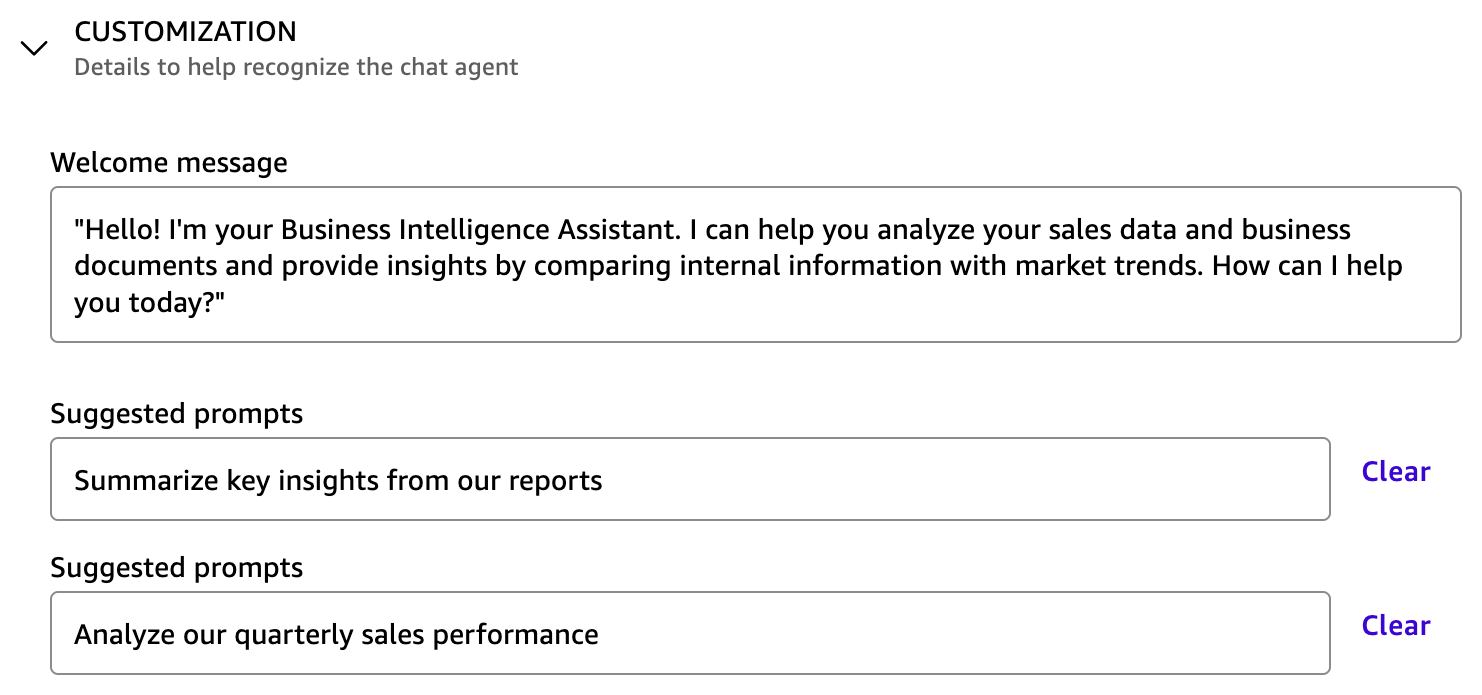
图 11:包含欢迎消息和建议提示的自定义部分
启动智能体
选择 Launch chat agent。右侧面板会显示智能体的实时预览,其中展示了欢迎消息和建议提示。
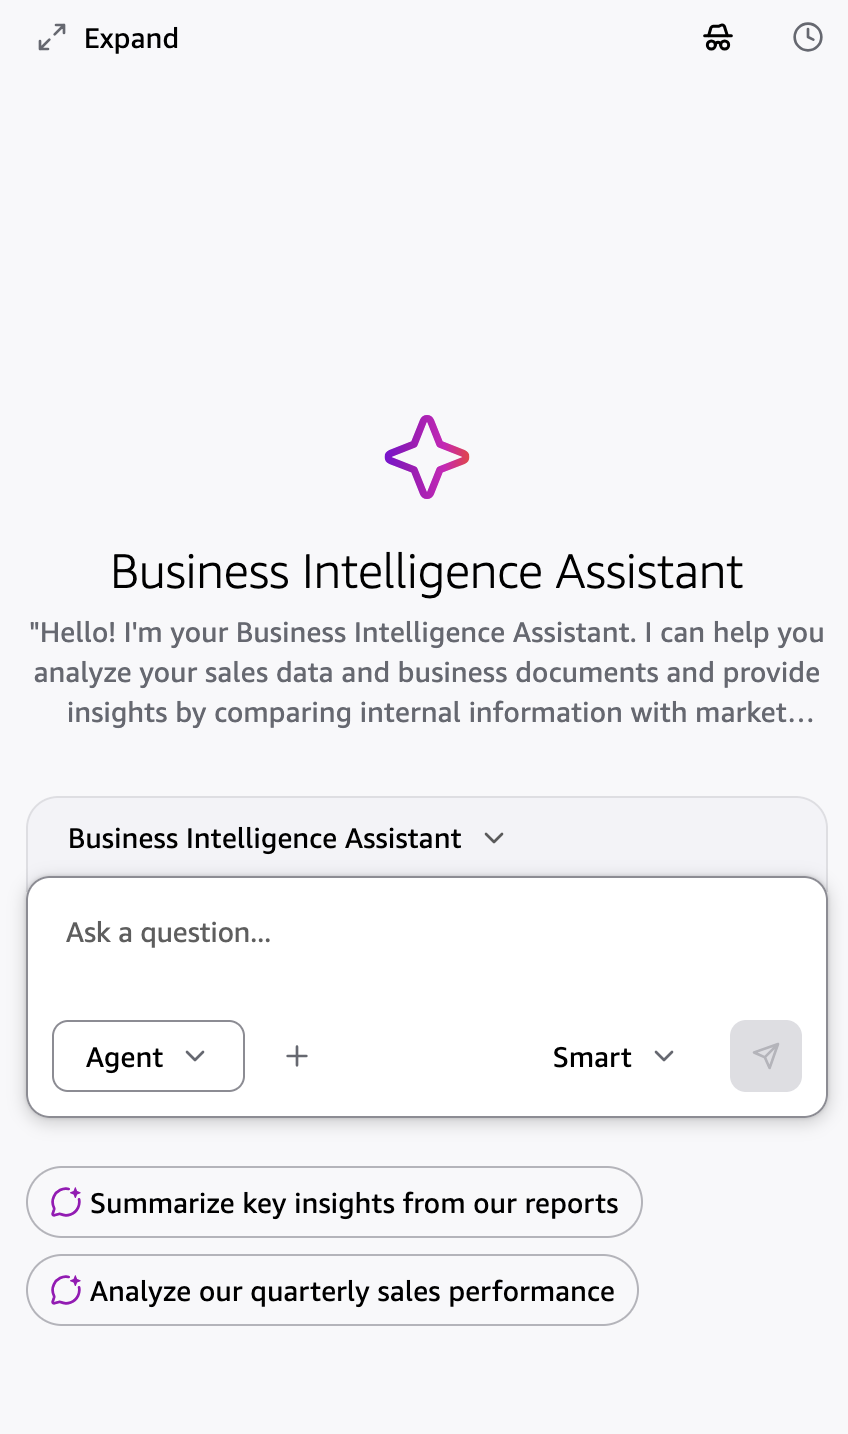
图 12:已启动的 Business Intelligence Assistant,聊天面板中显示欢迎消息和建议提示
第 6 步:跨结构化和非结构化数据查询
智能体运行后,先从一个关于业务结果的问题开始:
2025 年各地区的销售额有何变化?
针对这个问题,智能体会将 Product_Sales.csv 数据集的结果与 S3 知识库中的文档相结合。它返回的响应包含各地区销售额明细、趋势,以及指向每个来源的引用。
图 13 显示了该响应。每个引用标记都会将数据关联到其来源文档。
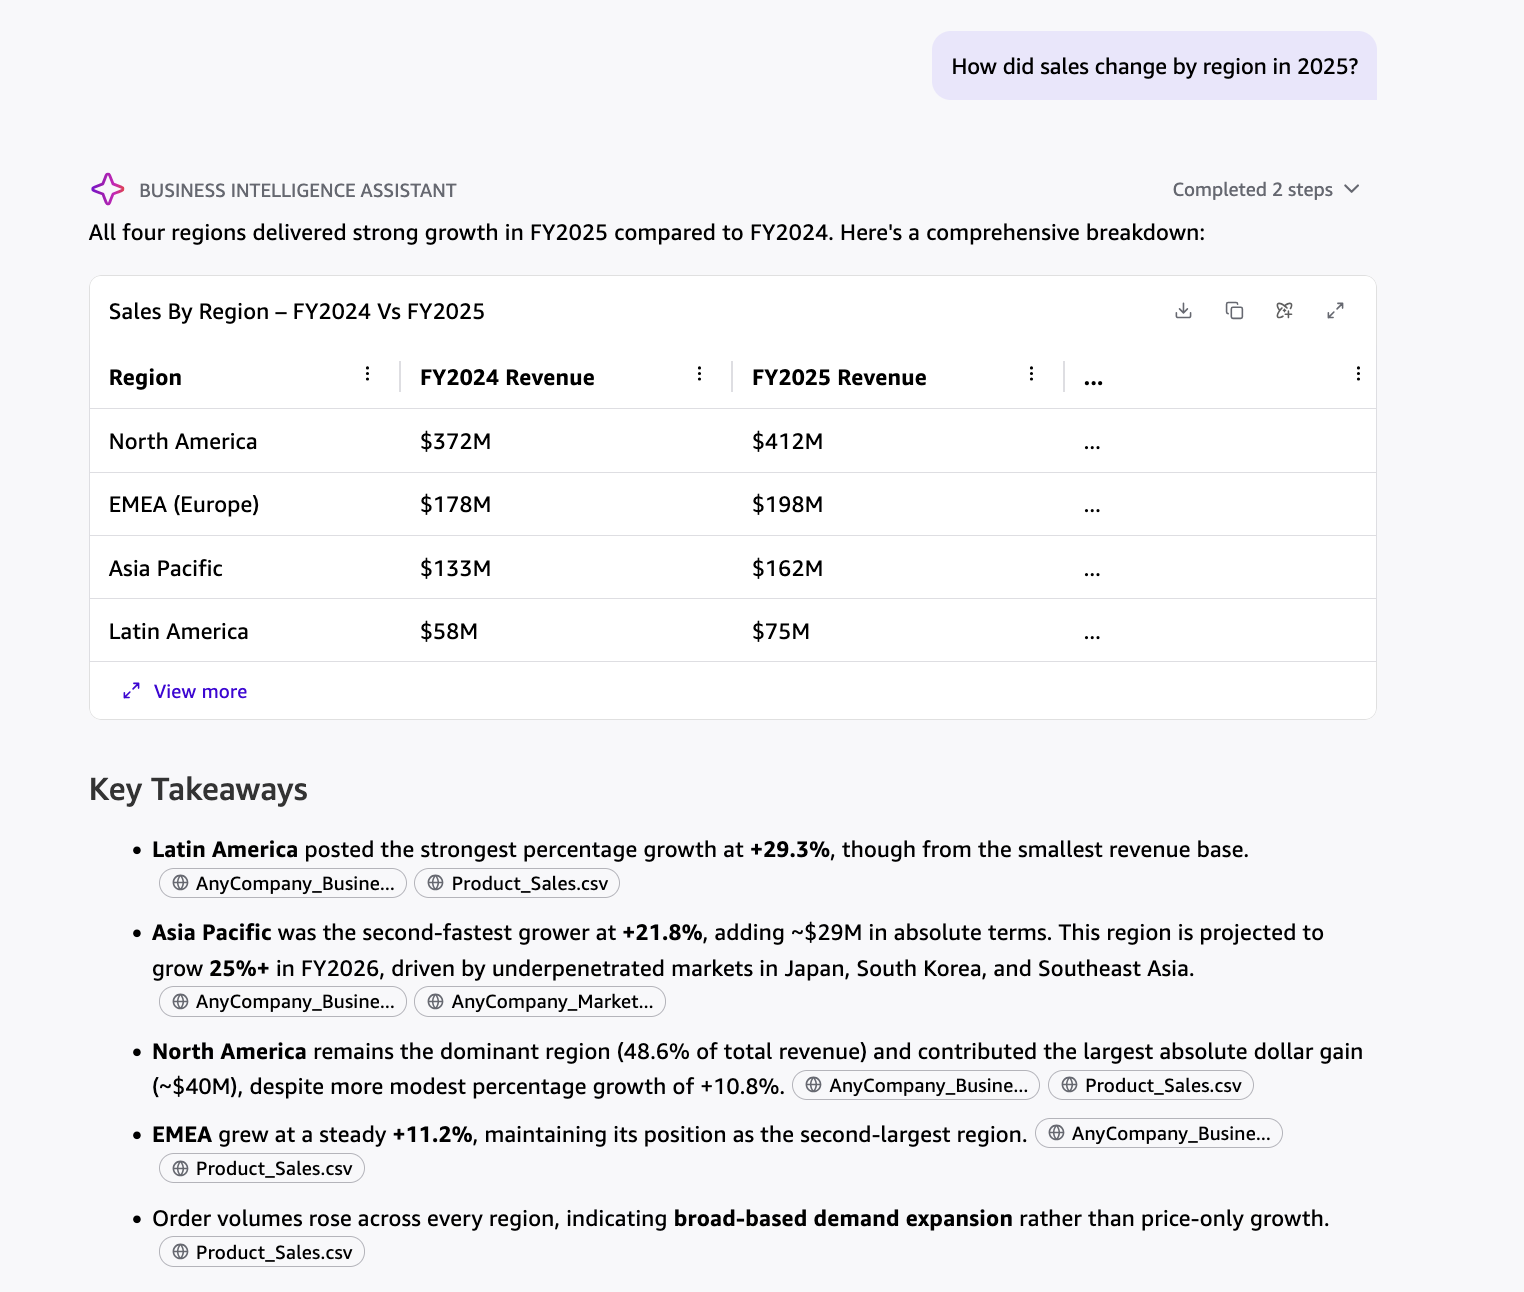
图 13:聊天智能体的响应,显示来自数据集和知识库文档的区域销售分析
当你询问关于结构化数据的问题时,智能体会使用 text-to-SQL 将你的自然语言转换为 SQL 查询。它对数据集运行该查询,并以易读的格式返回结果。这意味着你无需自己编写 SQL,就能提出复杂的分析问题。
接下来,询问某个具体文档:
我们的产品战略备忘录中列出了哪些关键战略重点?
如图 14 所示,智能体会总结 Product Strategy Memo 中的战略支柱、FY2026 路线图和投资需求。
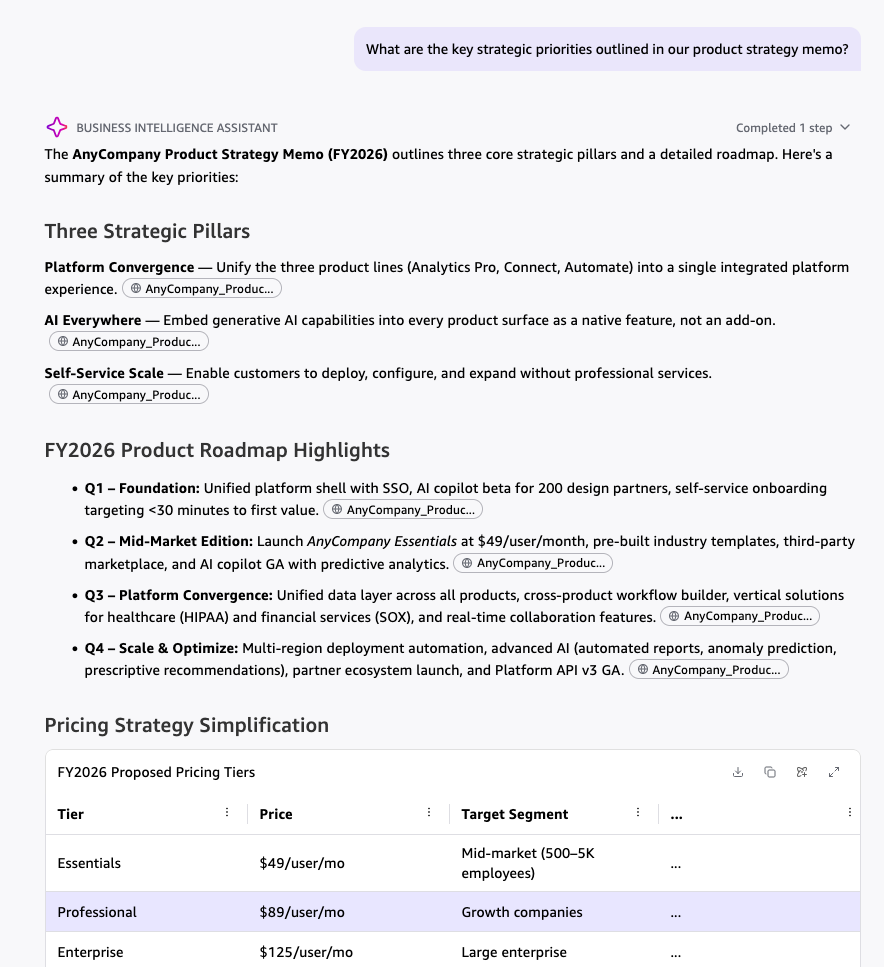
图 14:聊天智能体的响应,总结了 Product Strategy Memo 中的战略重点
最后,问一个需要同时用到两种数据类型的问题:
我们 2025 年的销售结果与分析报告中识别出的市场趋势相比如何?
如图 15 所示,智能体会将 Market Analysis Report 中的趋势与你的销售数据结果进行对比,并引用每个来源。
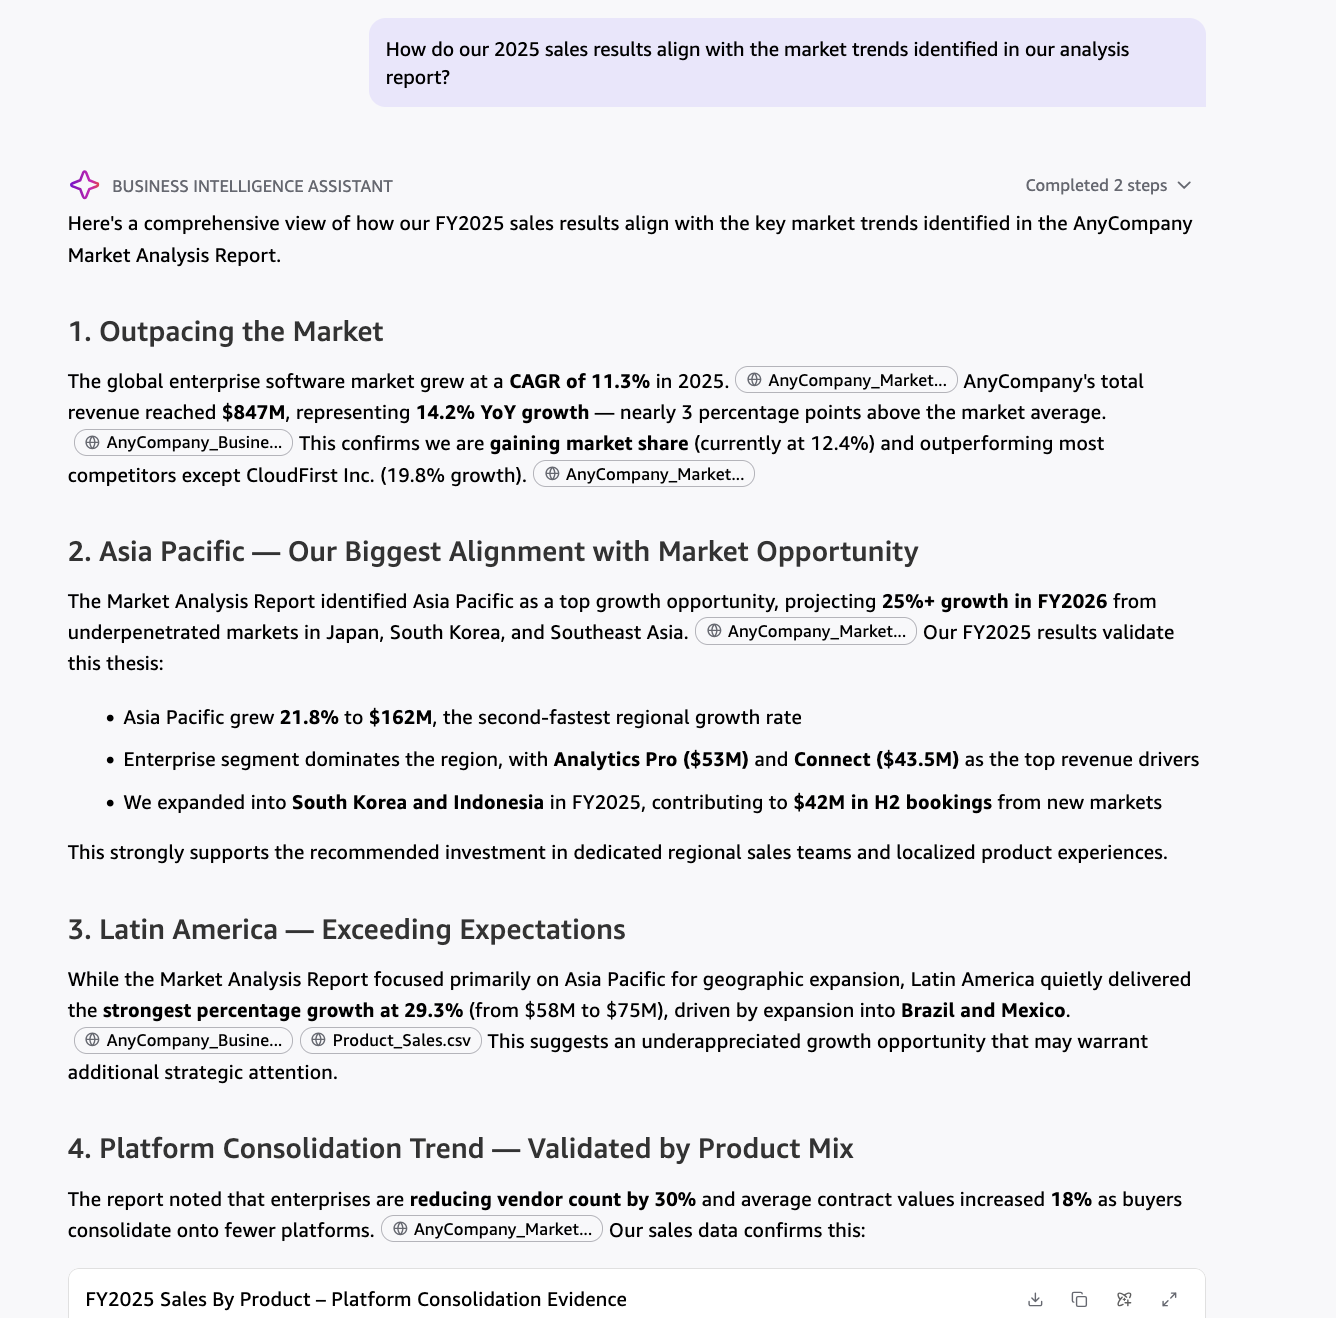
图 15:聊天智能体的响应,将 2025 年销售结果与 Market Analysis Report 中的市场趋势进行对比
这就是在单个 Space 中组合多种数据类型的核心价值。智能体可以在同一个响应中同时获取结构化 CSV 数据和非结构化文档。你无需知道数据存放在哪里。
第 7 步:使用自然语言生成产物和报告
Business Intelligence Assistant 还可以生成格式化文档,包括 Microsoft PowerPoint 演示文稿、Microsoft Excel 电子表格和 Microsoft Word 文档。在聊天智能体中尝试以下提示:
- “创建一个 PowerPoint 演示文稿,总结 AnyCompany 2025 年第四季度按地区划分的销售表现,包括关键趋势和建议。”
- “生成一个 Excel 电子表格,按收入显示前 10 笔订单,包含 Order ID、Region、Product 和 Revenue 列。”
- “根据我们的年度评估数据,创建一个包含季度业务回顾摘要的 Word 文档。”
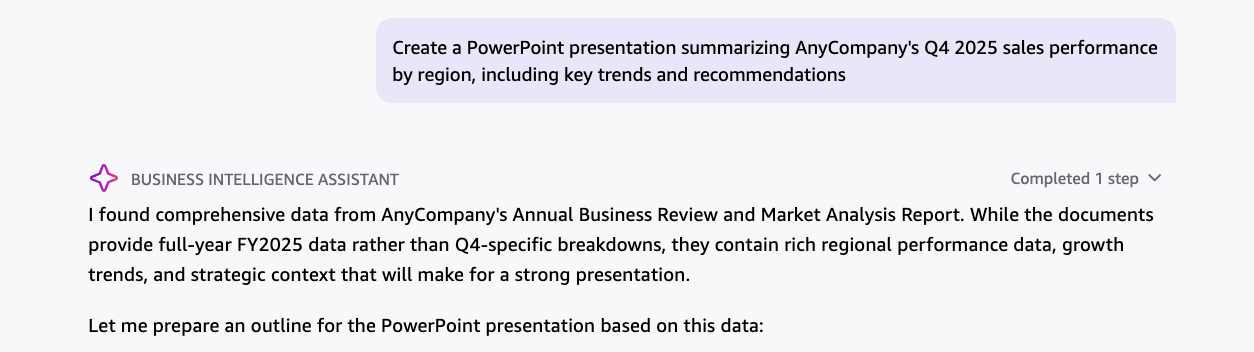
图 16:聊天智能体确认请求,并为 AnyCompany 2025 年第四季度销售表现准备 PowerPoint 大纲
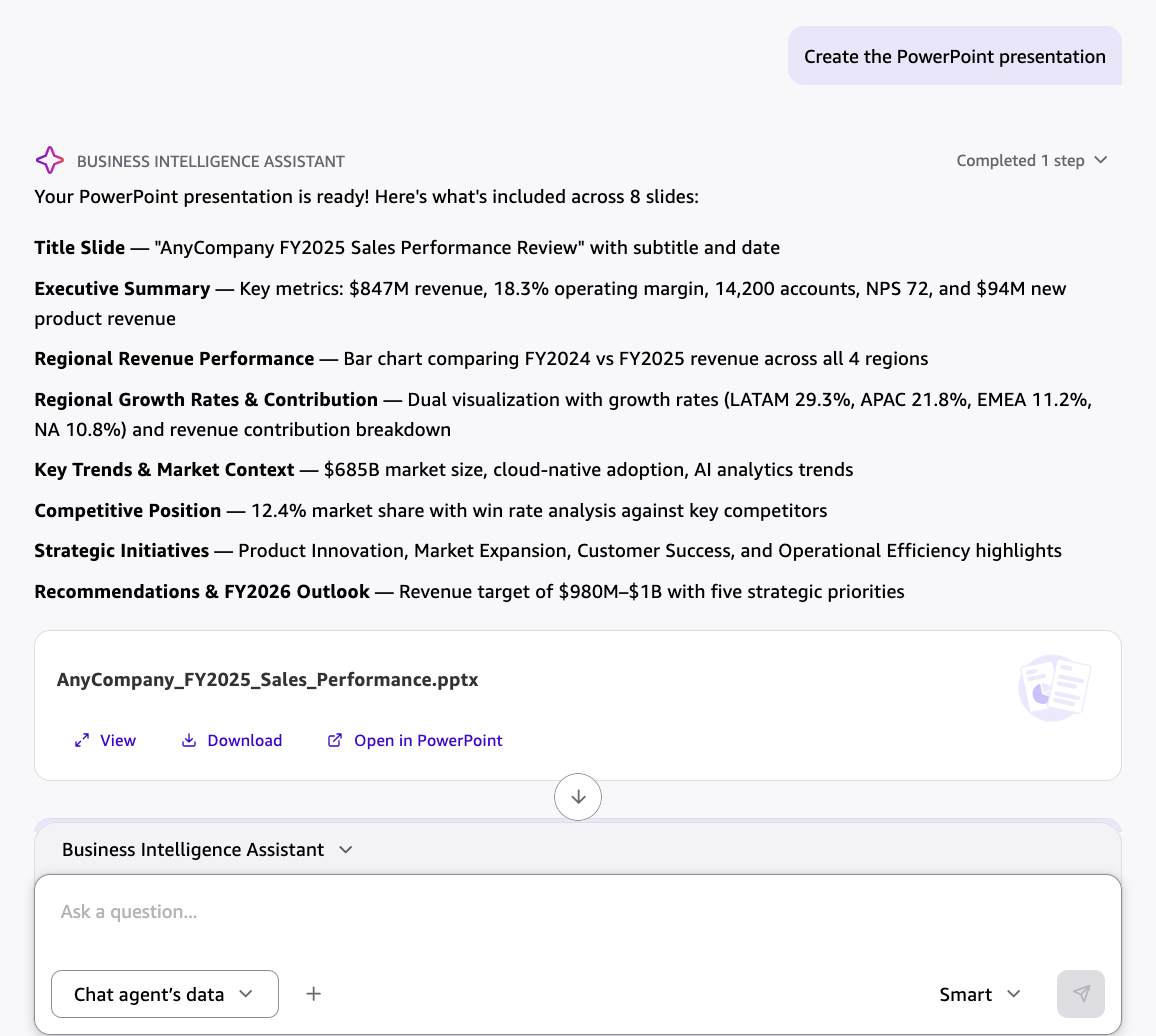
图 17:生成的八页 PowerPoint,带有可下载的 AnyCompany_FY2025_Sales_Performance.pptx 文件
启动聊天智能体后,在共享之前它始终保持私密。测试完智能体后,将其共享给你的团队:
- 在左侧导航中,选择 Chat agents。
- 在 Business Intelligence Assistant 的 Actions 列中,选择菜单图标,然后选择 Share。
- 输入要共享的用户或群组,分配 Owner 或 Viewer 权限,然后选择 Share。
智能体会返回具备权限感知的响应,知识库在您更新其权限之前仅对其创建者可用。请确保您与之共享智能体的人也可以访问该 Space、知识库和数据集。详细信息请参阅 自定义聊天智能体。
您完成的工作
在本演练中,您:
- 通过集成将 Amazon S3 连接为数据源。
- 创建了可索引非结构化业务文档的知识库。
- 创建并充实了用于结构化数据查询的 Product Sales 数据集。
- 构建了一个 Space,作为聊天智能体的统一数据中心。
- 配置了一个具有明确定义角色设定并关联知识来源的自定义聊天智能体。
- 在单次对话中跨结构化和非结构化数据查询智能体。
- 通过聊天提示生成了 PowerPoint 演示文稿。
- 将智能体共享给了您的团队。
最佳实践
在从本演练转向您自己的数据时,请采用以下实践:
- 组织好您的 S3 数据:使用清晰的文件夹结构和文件命名规范。清晰的结构也使您能更轻松地将知识库的范围限定到特定的 S3 前缀。
- 编写具体的角色设定指令:您的指令越具体,智能体的响应就越一致。请包含关于如何引用来源和处理模糊查询的指导。
- 使用 Space 控制范围:与其让智能体访问所有内容,不如创建仅包含与该智能体用途相关数据来源的聚焦式 Space。
- 从建议提示开始:建议提示有助于用户了解智能体能做什么。请选择能够展示智能体在结构化和非结构化数据两方面能力的提示。
- 共享前先测试:在与团队共享之前,使用预览面板通过有代表性的问题测试您的智能体。
安全注意事项
根据 AWS 责任共担模型,您有责任配置对您的数据、知识库和智能体的访问。在调整此解决方案时,请考虑以下几点:
- 授予最小权限的 S3 访问:仅向 Amazon Quick 授予您的知识库所需存储桶的访问权限。管理员选择的存储桶默认只有只读权限。如果您通过 API 创建知识库,可以为单个 S3 数据源提供自定义 AWS Identity and Access Management (IAM) 角色,而不是授予账户级别的 S3 访问权限。
- 控制文档访问:如果文档需要按用户或按群组访问,请在创建知识库时启用文档级 ACL。此选择之后无法更改。
- 加密的存储桶:如果您的存储桶使用 AWS Key Management Service (AWS KMS) 密钥,请按照 管理员设置指南 中的 AWS KMS 步骤操作。
- 仅添加可信内容:智能体会使用知识库中的文档来生成响应,因此请仅包含您信任的来源的内容。
- 有选择地共享:聊天智能体和知识库默认是私有的。仅与需要它们的用户和群组共享。
- 将护栏作为其中一层防护:Amazon Quick 内置了内容安全筛查功能,管理员最多可添加 50 个屏蔽词或短语。这些控制措施有助于降低风险,但不能替代您配置访问和权限的责任。详情请参阅 Amazon Quick 中的 AI 护栏。
清理
为避免持续产生费用,请删除您创建的资源:
- 在 Chat agents(聊天智能体)页面上删除该聊天智能体。
- 在 Spaces(空间)页面上删除该 Space。
- 在 Datasets(数据集)页面上删除 Product_Sales.csv 数据集。
- 在 Knowledge(知识)页面上删除知识库和 S3 集成。
- 如果您专门为本次演练创建了 S3 存储桶,请将其清空并删除。删除存储桶及其对象是永久性操作,因此请备份您想要保留的数据。
Amazon Quick 的用户订阅和账户费用与这些资源分开计费。详情请参阅 Amazon Quick 定价。
结论
Amazon Quick 帮助您将结构化和非结构化数据整合在一起。在本文中,您将 S3 连接为知识库,充实了数据集,构建了一个 Space,并创建了一个自定义聊天智能体。业务用户现在可以通过单一对话界面查询这两种数据类型,无需了解数据存储位置或如何编写查询语句。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com