GS Caltex 用 Amazon SageMaker Canvas 实现 MLOps 生产化(第一部分)
Production MLOps at GS Caltex with Amazon SageMaker Canvas, part 1
韩国能源化工企业 GS Caltex 将 Amazon SageMaker Canvas 与 SageMaker Pipelines 打通,由工艺工程师在 Canvas 中无代码建模,ML 工程师负责部署与调度推理。通过自动化交接并复用已验证的预处理流程和模型,模型部署时间从约 1 周缩短到数小时,并以每 30 分钟一次的 batch 推理替代常驻 endpoint,明显降低推理成本。
GS Caltex 使用 Amazon SageMaker Canvas 和 Amazon SageMaker Pipelines 将工艺工程师的模型连接到生产工作流。这家韩国能源化工公司将模型开发和运维工作分配给具有互补技能的工程师。
工艺工程师利用其工艺知识,在 SageMaker Canvas 中构建和验证模型,而无需编写代码。机器学习(ML)工程师则配置 SageMaker Pipelines 工作流,用于部署和定时推理。
将资产从 SageMaker Canvas 迁移到 SageMaker Pipelines 仍需要集成工作。ML 工程师必须为生产环境设置数据路径、提供模型配置,并连接预处理和推理任务。GS Caltex 在复用 SageMaker Canvas 中已创建资产的同时,实现了这一交接过程的自动化。
GS Caltex 表示,其 ML 工程师现在只需几个小时即可部署模型,而此前大约需要一周。该公司每 30 分钟运行一次批量推理,减少了对持续运行的端点的需求。GS Caltex 表示,这显著降低了其推理成本。
本文介绍 GS Caltex 如何将 SageMaker Canvas 连接到 SageMaker Pipelines,并在生产环境中复用经过验证的预处理流程和模型。
解决方案概览
机器学习运维(MLOps)工作流有两条路径:准备新模型版本以供部署,以及使用已部署的模型运行批量推理。
从经过验证的模型到可重复的工作流
您可以使用 SageMaker Canvas 以可视化方式准备数据、构建模型并生成批量预测。您还可以从 SageMaker Canvas 将经过验证的模型注册到 Amazon SageMaker Model Registry。GS Caltex 构建了一个独立的交接流程,将这些资产转换为可执行的 SageMaker Pipelines 步骤。
工艺工程师了解流程背后的变量和数据,并评估模型的预测是否有用。ML 工程师则将所得资产转化为生产任务,并管理模型版本和执行历史。
| 领域 | 在 SageMaker Canvas 中准备的内容 | 在生产工作流中管理的内容 |
| 数据准备 | 使用 Data Wrangler 构建的预处理流程 | Amazon SageMaker Processing 中的预处理任务 |
| 模型开发 | 已训练的模型和评估结果 | Model Registry 中的模型版本和审批状态 |
| 预测 | 对模型预测结果的验证 | 使用已批准的模型每 30 分钟进行一次批量推理 |
| 运维 | 单个模型的开发和验证 | 步骤执行历史、存储的结果和故障处理 |
参考架构
下图展示了工艺工程师如何将 SageMaker Canvas 资产交接给 ML 工程师进行部署和定时推理。ML 工程师使用 Amazon Simple Storage Service(Amazon S3)存储预处理流程,使用 Model Registry 管理模型版本,然后通过 Amazon EventBridge 调度管道运行。
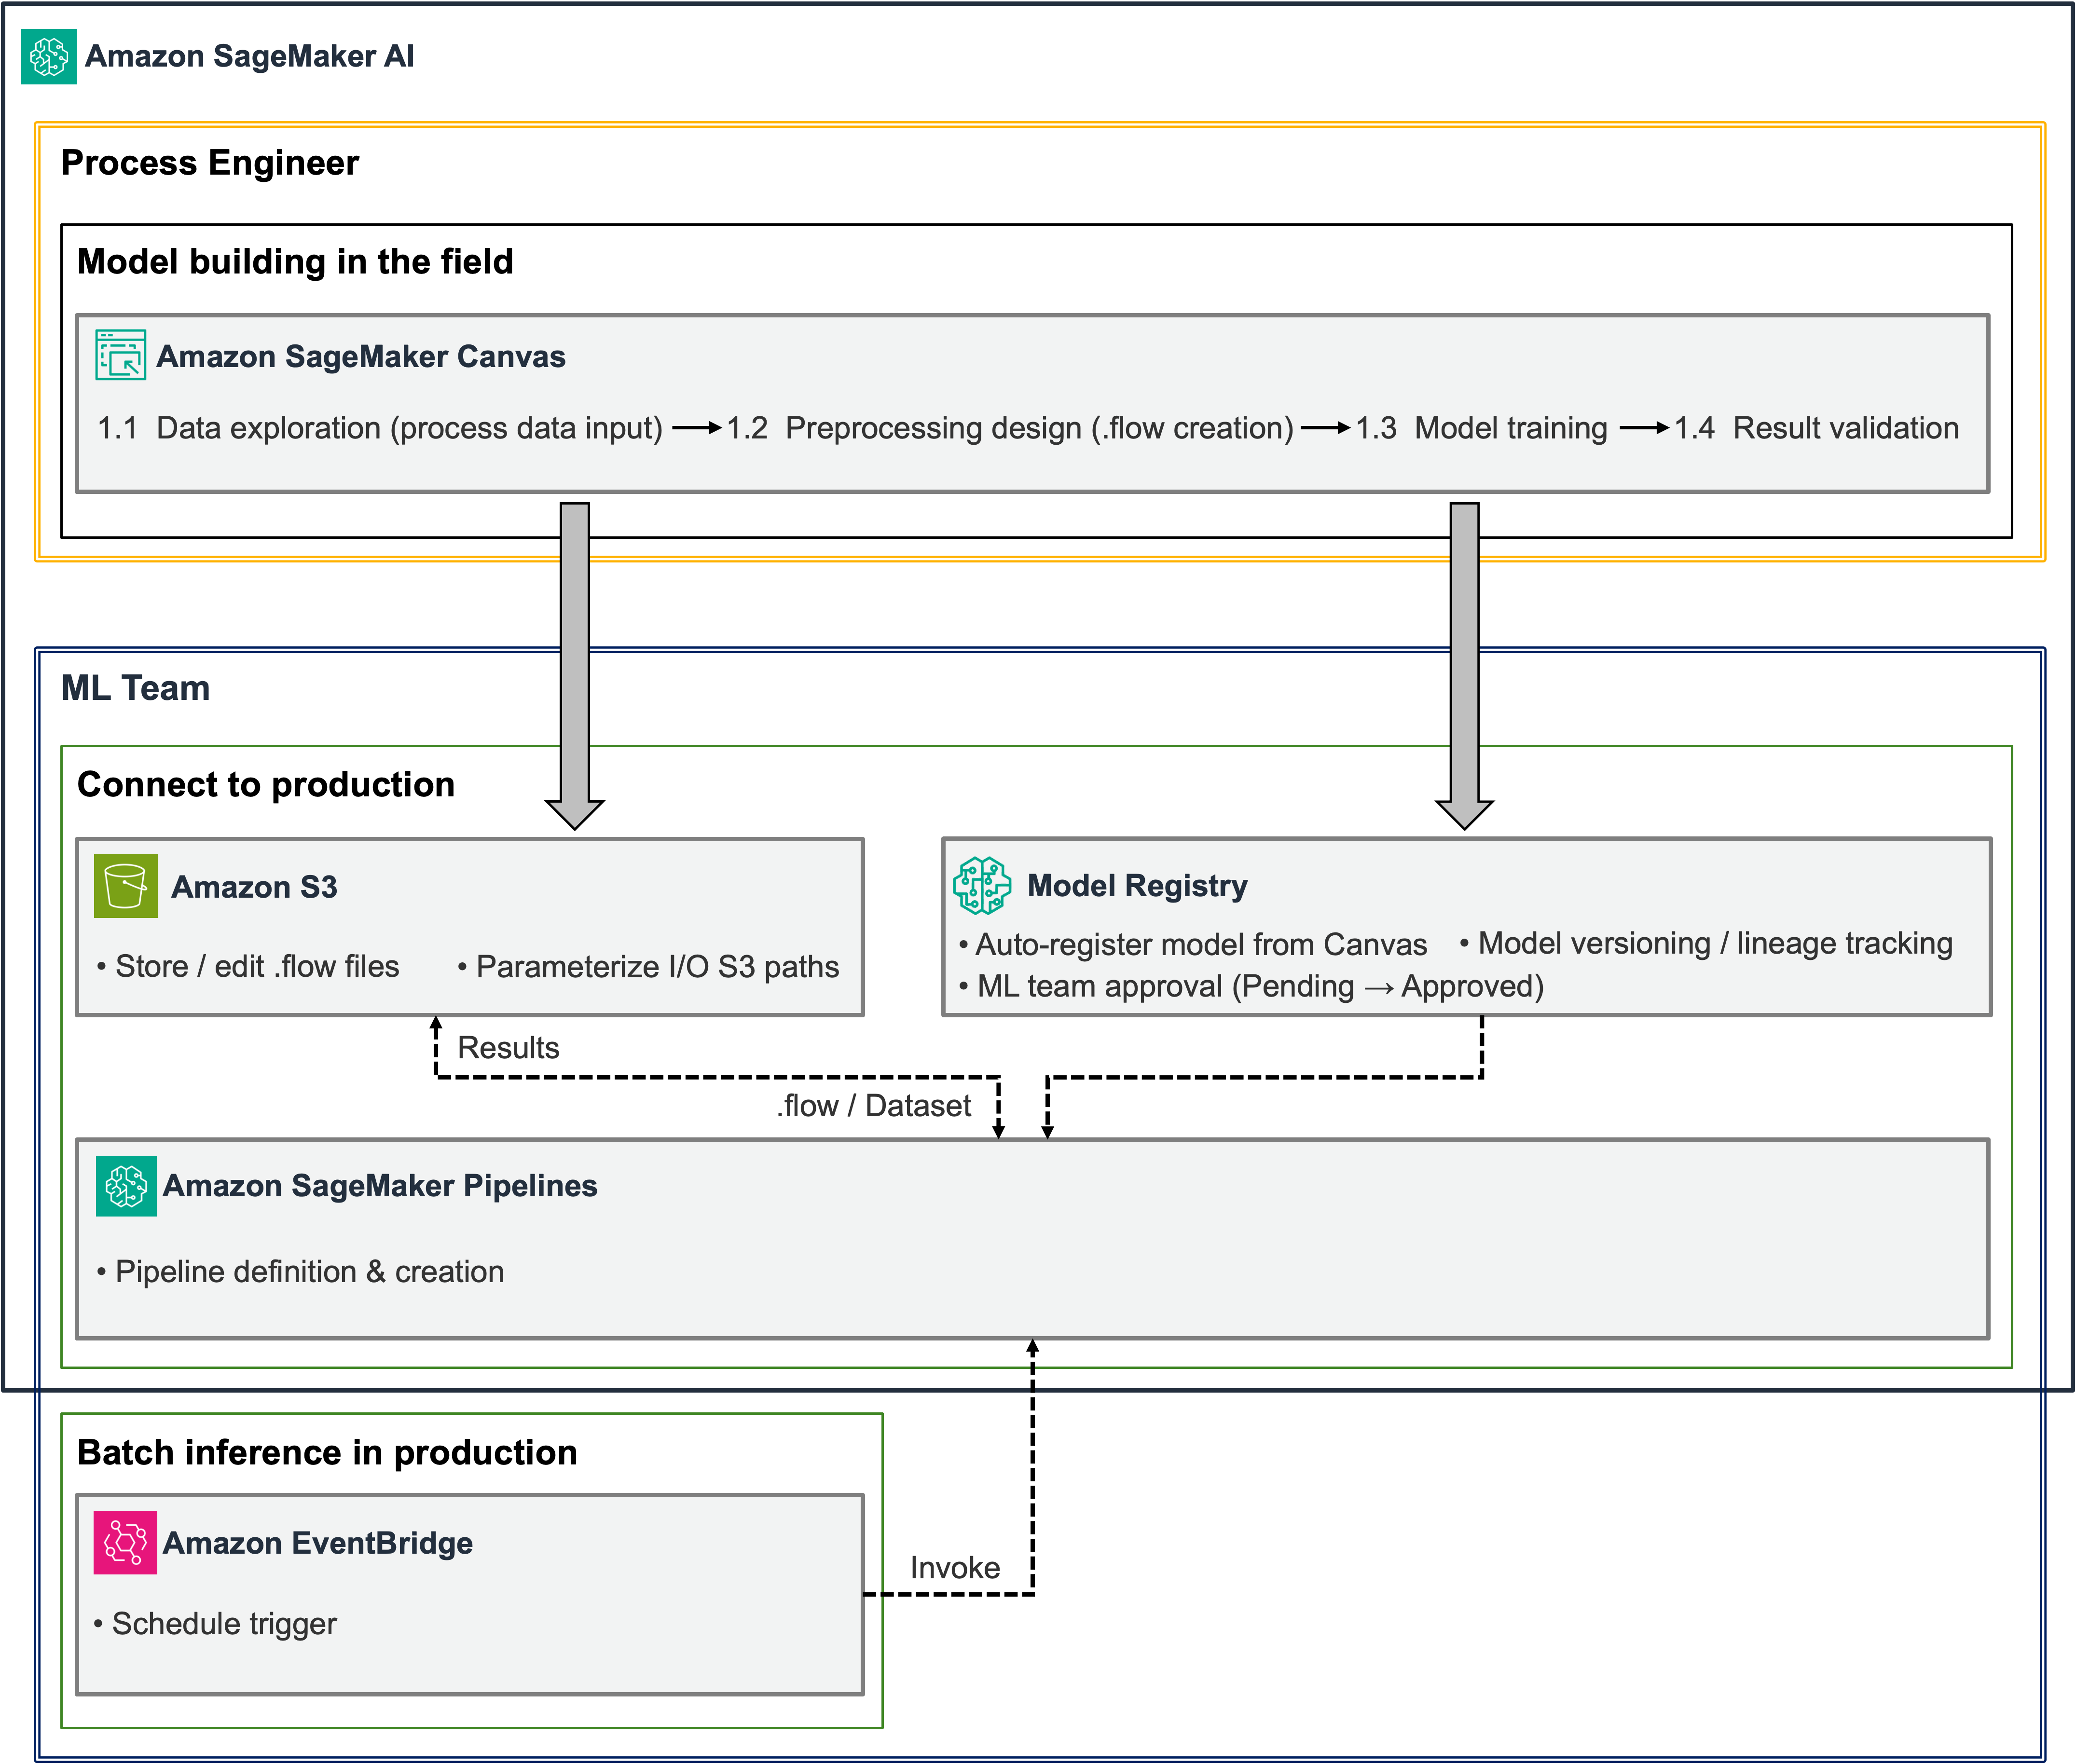
图 1:SageMaker Canvas 资产连接到 SageMaker Pipelines 工作流以进行定时批量推理
ML 工程师接收来自 SageMaker Canvas 的预处理流程和模型,并审查数据格式和预测结果。审查完成后,他们在 Model Registry 中批准该模型并进行部署。这一准备工作在新模型版本部署时进行。后续的推理运行将复用已部署的模型。
Amazon EventBridge 启动每次计划运行。SageMaker Pipelines 从 Amazon Simple Storage Service (Amazon S3) 准备输入数据,运行预处理和 SageMaker Batch Transform,并将结果存储在 S3 中。机器学习工程师可以检查步骤状态和 Amazon CloudWatch 日志来监控工作流。
生产流水线复用了在 SageMaker Canvas 中创建的预处理逻辑和已训练的模型。机器学习工程师配置输入和输出路径,设置执行顺序,并编写将审批和调度连接到工作流的代码。
先决条件
开始之前,请准备以下内容:
- 一个在 SageMaker Canvas 中构建并评估的模型,以及它的Data Wrangler 预处理流程
- 用于推理的 CSV 数据以及用于存储这些文件的 S3 存储桶。
- 一个 SageMaker 执行角色和一个具有启动流水线权限的 Amazon EventBridge 角色
- 一个安装了 Boto3 和 SageMaker Python SDK 2.x 的 Python 环境。
完整的参考实现可在GitHub 仓库中获取。本文中的代码示例侧重于组件之间的连接。该仓库使用了一个示例贷款分类模型,因此请调整配置以匹配你模型的输入和输出格式。
技术实现
以下步骤涵盖预处理复用、模型审批与部署、流水线构建以及计划推理。
1. 使用 SageMaker Processing 运行 SageMaker Canvas 预处理流程
在 SageMaker Canvas 中使用 Data Wrangler 创建的预处理流程会记录数据源和转换步骤。要设置参考实现,请使用 SageMaker Processing 将数据导出到 Amazon S3,然后获取该作业使用的作业设置和 .flow 文件。
在导出设置中,关闭 Auto job configuration(自动作业配置)并选择 SageMaker Processing。导出开始后,在 Amazon SageMaker AI 控制台上打开 Processing 作业详情。记录容器镜像 URI、名为 flow 的输入的 S3 URI、执行角色以及输出设置。使用这些值来配置运行 .flow 文件的流水线步骤。
SageMaker 执行角色必须具有读取所需 S3 数据、写入结果以及访问容器镜像的权限。根据需要处理的数据量选择实例类型和数量。
保留经过流程工程师验证的预处理逻辑,并为生产环境调整数据源、路径和其他设置。根据原始作业配置检查容器镜像和输出节点。
| 检查项 | 操作 |
| 输入位置 | 检查 .flow 文件中数据源引用的 S3 URI。将原始数据上传到其他位置不会更新此引用。 |
| 容器镜像 | 使用在 S3 导出期间创建的 Processing 作业中的镜像,并固定一个能够重现已验证转换的版本。 |
| 输出 ID | 使用导出配置中的输出节点和输出名称。如果所需格式为 {node_id}.{output_name},请与之完全匹配。 |
| 学习到的转换值 | 保留训练期间学习到的值,例如缩放和编码参数。不要在每个推理批次上重新拟合它们。 |
| 验证 | 对比 SageMaker Canvas 和 Processing 对相同输入生成的列、数据类型和转换后的值。 |
某些 .flow 文件包含执行元数据,例如 internal_metadata.dw_job.container_uri。请检查实际的 Processing 作业设置,而不是假设每次导出都包含此字段。如果将工作流迁移到另一个 AWS 区域,请验证容器镜像在该区域是否可用。
该参考实现通过执行将中间输出和最终输出分离,存放在 runs/<execution-id>/ 之下。其 PrepareInput 步骤将数据写入 .flow 文件中引用的固定 S3 位置。请防止共享该输入路径的执行发生重叠。
如果还想为每次执行隔离输入数据,可以添加一个准备步骤,在 .flow 文件的副本中更新源 URI。声明 SageMaker Pipelines 参数并不会自动替换文件内的 URI。
2. 处理训练与推理输入之间的差异
目标列是训练数据与推理数据之间的一个差异。使用训练数据构建的流可以包含期望输入模式中存在目标列的转换。推理数据不包含该已知结果。
参考实现在预处理之前添加了一个 PrepareInput 步骤。如果缺失目标列,该步骤会以占位值添加它。预处理之后,DropTargetColumn 会删除该列。请使占位值的数据类型和列位置与训练模式一致,并仅按原始顺序将期望的特征传递给模型。
PrepareInput -> PreprocessNewData -> DropTargetColumn
             -> BatchPredict -> AssembleResults
仅在占位目标不影响特征值时才使用此方法。如果流根据目标筛选行、从目标派生特征或应用目标编码,则需要额外处理。在这些情况下,应分离推理所需的转换和学习到的状态。
验证应涵盖列的顺序和数量、数据类型、缺失值处理以及行数。删除目标列后,检查其余列是否与训练期间使用的特征顺序一致。
3. 注册、审批和部署模型
将经过验证的 SageMaker Canvas 模型版本注册到 Model Registry(模型注册表)。注册的版本可以包含模型文件、推理配置和评估结果。ML 工程师会在更改审批状态之前审查这些信息。
模型文件(例如 model.tar.gz)必须与正确的推理容器和环境设置配合使用。Model Registry 中的模型包将这些信息组合在一起。在这种批处理架构中,部署会从一个已审批的包创建 SageMaker 模型资源,供 Batch Transform 引用。
以下示例检查一个已经过审批的包,然后创建模型资源。在部署期间提供 model_package_arn、model_name 和 sagemaker_role_arn。此示例为每个版本使用唯一的模型名称。
import boto3

sm_client = boto3.client("sagemaker")
package = sm_client.describe_model_package(
    ModelPackageName=model_package_arn
)

if package["ModelPackageStatus"] != "Completed":
    raise RuntimeError("Model package is not ready")
if package["ModelApprovalStatus"] != "Approved":
    raise RuntimeError("Model package is not approved")

sm_client.create_model(
    ModelName=model_name,
    ExecutionRoleArn=sagemaker_role_arn,
    PrimaryContainer={"ModelPackageName": model_package_arn},
)
Model Registry 记录审批状态,但不会对每次推理请求强制执行审批检查。请在部署代码中检查该状态,并在流水线配置中保留所选包的 ARN 和模型名称。如果审批被撤销,请更新使用该模型的调度和执行配置。
注册和部署在模型版本发布时进行。每 30 分钟运行一次的流水线会使用该模型创建 Batch Transform 作业,因此不需要在每次运行时重新注册模型。
4. 连接预处理、推理和结果组装
推理流水线包含五个步骤。
| 步骤 | 功能 | 输入与输出 |
PrepareInput |
如有需要,添加占位目标列 | 新推理数据 -> 补充了目标列的数据 |
PreprocessNewData |
运行 SageMaker Canvas 预处理流程 | 已准备的输入和 .flow -> 转换后的数据 |
DropTargetColumn |
移除目标列和 CSV 表头 | 转换后的数据 -> 不含表头的特征 CSV |
BatchPredict |
使用已批准的模型运行批量推理 | 特征 CSV -> 预测文件 |
AssembleResults |
将预处理数据与预测结果合并 | 预处理数据和预测文件 -> 最终结果 CSV |
在连接各步骤之前配置每个作业。在下面的示例中,prepare_args、preprocess_args、drop_target_args 和 assemble_args 保存对使用 PipelineSession 的处理器调用 run() 返回的步骤参数。处理器和 transformer 共享 pipeline_session 对象。使用之前部署的 model_name 配置 transformer。
from sagemaker.workflow.pipeline import Pipeline
from sagemaker.workflow.steps import ProcessingStep, TransformStep

prepare = ProcessingStep(
    name="PrepareInput", step_args=prepare_args
)
preprocess = ProcessingStep(
    name="PreprocessNewData",
    step_args=preprocess_args,
    depends_on=[prepare],
)
drop_target = ProcessingStep(
    name="DropTargetColumn",
    step_args=drop_target_args,
    depends_on=[preprocess],
)

# The DropTargetColumn job defines an output named "features".
features_uri = (
    drop_target.properties.ProcessingOutputConfig
    .Outputs["features"].S3Output.S3Uri
)
predict = TransformStep(
    name="BatchPredict",
    step_args=transformer.transform(
        data=features_uri,
        content_type="text/csv",
        split_type="Line",
    ),
)
assemble = ProcessingStep(
    name="AssembleResults",
    step_args=assemble_args,
    depends_on=[predict],
)

pipeline = Pipeline(
    name="canvas-process-inference",
    steps=[prepare, preprocess, drop_target, predict, assemble],
    sagemaker_session=pipeline_session,
)
pipeline_arn = pipeline.upsert(role_arn=sagemaker_role_arn)["PipelineArn"]
以下执行图展示了示例贷款模型推理工作流中的五个步骤。它们准备输入、应用预处理、移除目标列、运行批量推理并组装结果。截取此截图时,执行处于 Executing 状态。
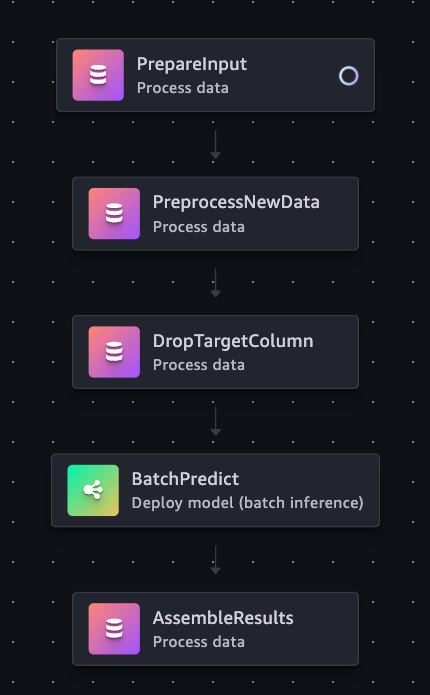
图 2:示例贷款模型的 SageMaker Pipelines 执行图
使用 depends_on 控制执行顺序,并通过步骤输出属性传递数据。例如,assemble_args 必须接收预处理数据的位置和 predict.properties.TransformOutput.S3OutputPath。输出名称 "features" 属于 DropTargetColumn。Data Wrangler 步骤使用其预处理流程中定义的输出 ID。
在参考实现中,AssembleResults 按行位置合并预处理数据和预测结果。在生产环境中使用之前,添加检查以确保文件顺序和行数一致,如果不一致则停止生成结果。如果预处理会对行进行排序或移除,请维护源记录 ID 与预测结果之间的显式映射。
5. 每 30 分钟调度一次推理
GS Caltex 每 30 分钟运行一次推理。以下示例使用 Amazon EventBridge 规则来调度 SageMaker Pipelines 执行。在附加调度之前,先创建流水线并通过手动运行进行验证。
import boto3

events_client = boto3.client("events")
rule_name = "canvas-process-inference-every-30-minutes"

events_client.put_rule(
    Name=rule_name,
    ScheduleExpression="rate(30 minutes)",
    State="ENABLED",
)

result = events_client.put_targets(
    Rule=rule_name,
    Targets=[{
        "Id": "canvas-process-inference",
        "Arn": pipeline_arn,
        "RoleArn": eventbridge_role_arn,
    }],
)
if result["FailedEntryCount"]:
    raise RuntimeError(result["FailedEntries"])
将 eventbridge_role_arn 设置为一个信任 Amazon EventBridge 服务主体 events.amazonaws.com 的角色,并具有对目标流水线的 sagemaker:StartPipelineExecution 权限。pipeline_arn 值用于标识上一步创建的流水线。
表达式 rate(30 minutes) 以 30 分钟为间隔调度运行。若要在整点和半点运行,请使用 cron(0/30 * * * ? *)。在输入准备步骤中决定每次运行处理哪个数据窗口,并将其记录到执行中。
运维注意事项
在启用调度运行之前,请检查总成本、执行时间,以及无效或不匹配数据的处理方式。
评估整个工作流的批量处理成本
Amazon SageMaker Pipelines 是一种无服务器的工作流编排服务。它管理执行顺序和依赖关系,无需您预置或维护工作流服务器。处理作业和批量转换作业使用单独的计算资源,并按实例类型和时长计费。
预置的实时端点适合需要持续低延迟响应的请求。批量转换适合可以一起处理一组记录的工作负载。它会在作业完成时释放该作业的计算资源,因此您无需为每个模型持续保持推理端点运行即可运行预测。
| 注意事项 | 预置的实时端点 | 结合批量转换的 SageMaker Pipelines |
| 资源生命周期 | 实例保持可用以服务请求 | 资源在每个作业开始时预置、结束时释放 |
| 成本驱动因素 | 端点运行时间和容量 | 作业时长、频率、实例数量以及配套服务 |
| 适合的工作负载 | 即时响应与持续的在线请求 | 按计划的时间间隔处理累积的数据 |
| 添加模型 | 端点容量与持续的托管成本 | 额外的处理、任务时长和并发限制 |
30 分钟的计划每天产生 48 次计划运行。在估算总运行时间时,应包括预处理、实例启动、推理和后处理。成本比较还应考虑工作流所使用的 Processing、S3、CloudWatch 及其他服务。
使用每个工作负载的实测用量评估其成本,包括所使用的支持服务以及每个计划作业的完整运行时间。
检查运行时间和重叠执行
每 30 分钟启动一次运行的计划并不能保证每次运行都能在该时间间隔内完成。使用有代表性的数据测量完整的流水线运行时间,包括实例启动和重试失败作业所需的时间。
决定如何处理在上一次执行尚未完成时就到达的计划运行。控制流水线内的并行步骤并不能阻止独立的流水线执行相互重叠。检查活动执行,防止对同一输入窗口的重复处理,并为每次运行分开输出路径。
记录每次运行的输入数据窗口、预处理流程版本、模型包 ARN、流水线执行 ARN 和输出位置。这些细节有助于重现结果和调查错误。
验证输出和失败行为
在启用计划之前,请完成以下检查:
- 通过 SageMaker Canvas 和 Processing 运行一个验证数据集。比较输出列、数据类型、行数和关键转换值。
- 检查添加占位目标(target)不会改变特征值,并且该目标已从模型输入中移除。
- 使用已批准的模型版本运行 Batch Transform,并验证源记录与预测之间的关联。
- 确认无效的输入架构或预处理失败会阻止下游推理和结果发布。
- 测量运行时间和成本,测试重叠执行和同一输入窗口的重新处理,然后启用 30 分钟计划。
为作业失败和处理延迟添加 CloudWatch 警报,并根据需要添加数据质量或模型监控。根据实测运行时间和数据特性设置初始阈值,并在模型或数据量发生变化时重新审视这些阈值。
采用方法与结果
通过分阶段推广,团队可以先验证交接过程,再将其在各个模型间标准化。以下各节介绍一种采用方法以及 GS Caltex 报告的结果。
从模型开发走向常规运行
首先为某一个模型验证通往生产环境的路径,然后将各次部署中重复的步骤标准化。以下顺序是基于 GS Caltex 经验的建议采用方法。
| 阶段 | 目标 | 范围 |
| 爬行(Crawl) | 在生产环境中重现开发结果 | 验证 SageMaker Canvas 模型,将其注册到 Model Registry,并手动运行流水线 |
| 行走(Walk) | 建立可靠的计划运行 | 检查审批、按所需间隔安排运行、添加失败警报,并按执行管理输出 |
| 奔跑(Run) | 在各个模型间复用运营流程 | 引入通用模板、持续集成和持续交付(CI/CD)、变更验证,以及运营职责交接的流程 |
随着自动化的扩展,工艺工程师仍需继续评估预测结果对工艺是否有用。机器学习工程师负责管理管道的执行与变更。
GS Caltex 的成果
GS Caltex 减少了将 SageMaker Canvas 模型接入生产环境所需的重复性工作。机器学习工程师现在只需几个小时即可部署模型,而之前大约需要一周时间。他们还复用了工艺工程师在 SageMaker Canvas 中验证过的资产。
在看到自己的模型投入生产使用后,工艺工程师开始提议在其他工艺中应用这些方法。机器学习工程师花费在重复集成工作上的时间减少了,得以专注于管道的运行和监控。
| 成果 | 报告的结果 |
| 模型部署时间 | 之前约需一周。现在只需几个小时 |
| 推理频率 | 每 30 分钟一次 |
| 成本影响 | 显著节省成本 |
| 工程工作 | 工艺工程师提议了新的应用;机器学习工程师专注于管道的运行和监控 |
清理测试资源
对于测试部署,请先禁用 Amazon EventBridge 规则并移除其目标。待正在运行的管道执行和作业完成后,删除测试管道及其 SageMaker 模型资源。
如果您为测试创建了实时端点,也请将其删除。从 S3 中移除输入、中间和预测文件,并根据保留策略清理 CloudWatch 日志。在删除模型文件和 Model Registry 版本之前,请检查是否有其他执行或审计要求仍依赖于它们。
结论
在 GS Caltex,工艺工程师在 SageMaker Canvas 中创建并验证模型,机器学习工程师则利用这些资产在 SageMaker Pipelines 中运行生产工作流。这种交接减少了重复的集成工作。GS Caltex 表示,机器学习工程师现在只需几个小时即可完成模型部署,而之前大约需要一周。
交接内容需要包括预处理流程、输入 schema、推理配置和审批流程,以及模型文件。请验证该工作流能够重现预期结果,并能按所需的计划可靠运行。
要试用这种方法,可以从您在 SageMaker Canvas 中验证过的一个模型入手,并使用该 GitHub 仓库。有关定义和运行工作流的详细信息,请参阅 SageMaker Pipelines 开发人员指南。先通过手动执行检查预处理和批量预测结果,然后按应用程序所需的时间间隔安排运行。
在第 2 部分中,我们将展示 GS Caltex 如何使用 Amazon Bedrock 将现有模型自动迁移到此管道上。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com