在 Amazon SageMaker HyperPod 上检测与恢复分布式训练中的静默数据 corruption(SDC)
Detecting and recovering from silent data corruption on Amazon SageMaker HyperPod
AWS 发布在 Amazon SageMaker HyperPod 上检测静默数据 corruption(SDC)的方法:在 PyTorch DDP 训练循环中加入三项检查,包括 all-reduce 前后的 NaN/Inf 梯度检查、环回重放审计和优化器更新后的权重指纹对比,覆盖计算路径、all-reduce 和权重存储三类故障落点。
静默数据损坏(SDC)是指诸如 GPU 之类的硬件返回一个错误但看似合理的数值且不报任何错误的情况。在分布式训练中,这个错误数值会流入每个副本的梯度和权重。损失值可能在数小时内看起来仍然正常,等团队注意到无法解释的发散或性能变弱的模型时,算力已经被浪费了。这种情况会在大规模场景下发生:在 Meta 使用多达 16K 块 H100 GPU 进行 Llama 3 405B 预训练 的 54 天里,419 次意外作业中断中有 6 次被归因于静默数据损坏,而这还只是那些中断了作业并被追溯到 SDC 的案例。
Amazon SageMaker HyperPod 已经可以更换报告故障的节点:健康监控智能体会监视 GPU 错误,深度健康检查会对节点进行压力测试,自动节点恢复机制会换掉坏硬件。但 SDC 能绕过所有这些功能,因为硬件从不报告任何问题。检测必须来自训练作业本身。
在这篇文章中,我们在 PyTorch DistributedDataParallel(DDP)训练循环中添加三项检查来检测 SDC。当某项检查触发时,我们会将可疑的 rank 映射到其所在节点,遏制损坏的影响,并让 SageMaker HyperPod 更换该节点。每项检查覆盖故障可能出现的不同位置:
- 非有限梯度检查会在发生的那一步捕获 GPU 前向或反向传播中的 NaN、Inf 和溢出,以及梯度 all-reduce 引入的 NaN 或 Inf。
- 环形重放审计捕获有限但错误的数值。在审计步骤中,每块 GPU 会重新计算来自另一个节点的微批次,并逐位比较损失值、通过指纹比较梯度。
- 权重指纹比较通过在更新后比较每个副本的权重,来捕获优化器步骤和存储权重中的损坏。
我们在一个拥有 4 个 ml.p5.48xlarge 实例(32 块 NVIDIA H100 GPU)的 SageMaker HyperPod 集群上,用软件注入故障的方式测试了这些检查,并在三个实例上重复了每项测试——这是这些检查所需的最低数量。该解决方案的完整代码可在随附的 GitHub 代码库中获取。
静默数据损坏是如何发生的,以及为什么常规检查会漏掉它
SDC 源于制造缺陷(漏过厂商筛选的边缘晶体管)和特定计算单元的硅老化,最常见的是张量核心中的乘加运算通道,而这恰恰是训练重度使用的硬件模型。这类边缘电路在大多数时候计算正确,只在压力条件下出错:高温、电压跌落或特定的操作数模式。由于算术逻辑路径没有 ECC 或奇偶校验(与内存不同),错误结果——比如 4.0001 而不是 4.0000——永远不会被标记,而是随激活值和梯度流入每个副本的权重。
它之所以如此难以捕获,是因为 SDC 位于计算路径中,而你已有的每项完整性检查防护的都是不同的边界:
| 检查 | 防护对象 | 为何漏掉 SDC |
| ECC | 内存 | 捕获内存中的位翻转,而不是错误的计算。张量核心的计算结果上没有 ECC。 |
| Xid 错误(NVRM) | GPU 驱动/硬件故障 | GPU 在检测到故障时会抛出 Xid 错误。而 SDC 按定义不会抛出任何错误,因此 /aws/sagemaker/Clusters/ HMA 日志中不会出现任何记录。 |
| DCGM 深度健康检查 | 硬件故障 | 会漏掉需要你的工作负载的操作数、热状态或时序才能触发的缺陷。它在空闲节点上、在你的作业之外运行。 |
| NVLink / PCIe / EFA 校验和 | 传输 | 验证到达的字节与发送的一致,而不是验证它们计算是否正确。 |
| 检查点校验和 | 存储往返 | 一个已损坏但数据一致的检查点,其校验和依然能通过。 |
捕获 SDC 的方法是检查计算本身的结果。
解决方案概览
该循环有四个步骤。前两步由你的训练任务完成,后两步使用 Kubernetes 和 SageMaker HyperPod 功能:
步骤 1.检测:训练循环中的三项检查通过比较数据并行副本,点名可疑 GPU。
步骤 2.定位:在由 Amazon Elastic Kubernetes Service (Amazon EKS) 编排的 SageMaker HyperPod 集群上,Kubernetes 节点名称包含实例 ID,因此将可疑 rank 映射到节点只是一次查询。
步骤 3.遏制与关联:停止作业,封锁节点,并在 SageMaker HyperPod 可观测性仪表板中查看其 GPU 指标。
步骤 4.确认与恢复:在告警不明确时进行确认,审查后替换节点,并从可疑窗口之前保存的检查点恢复。
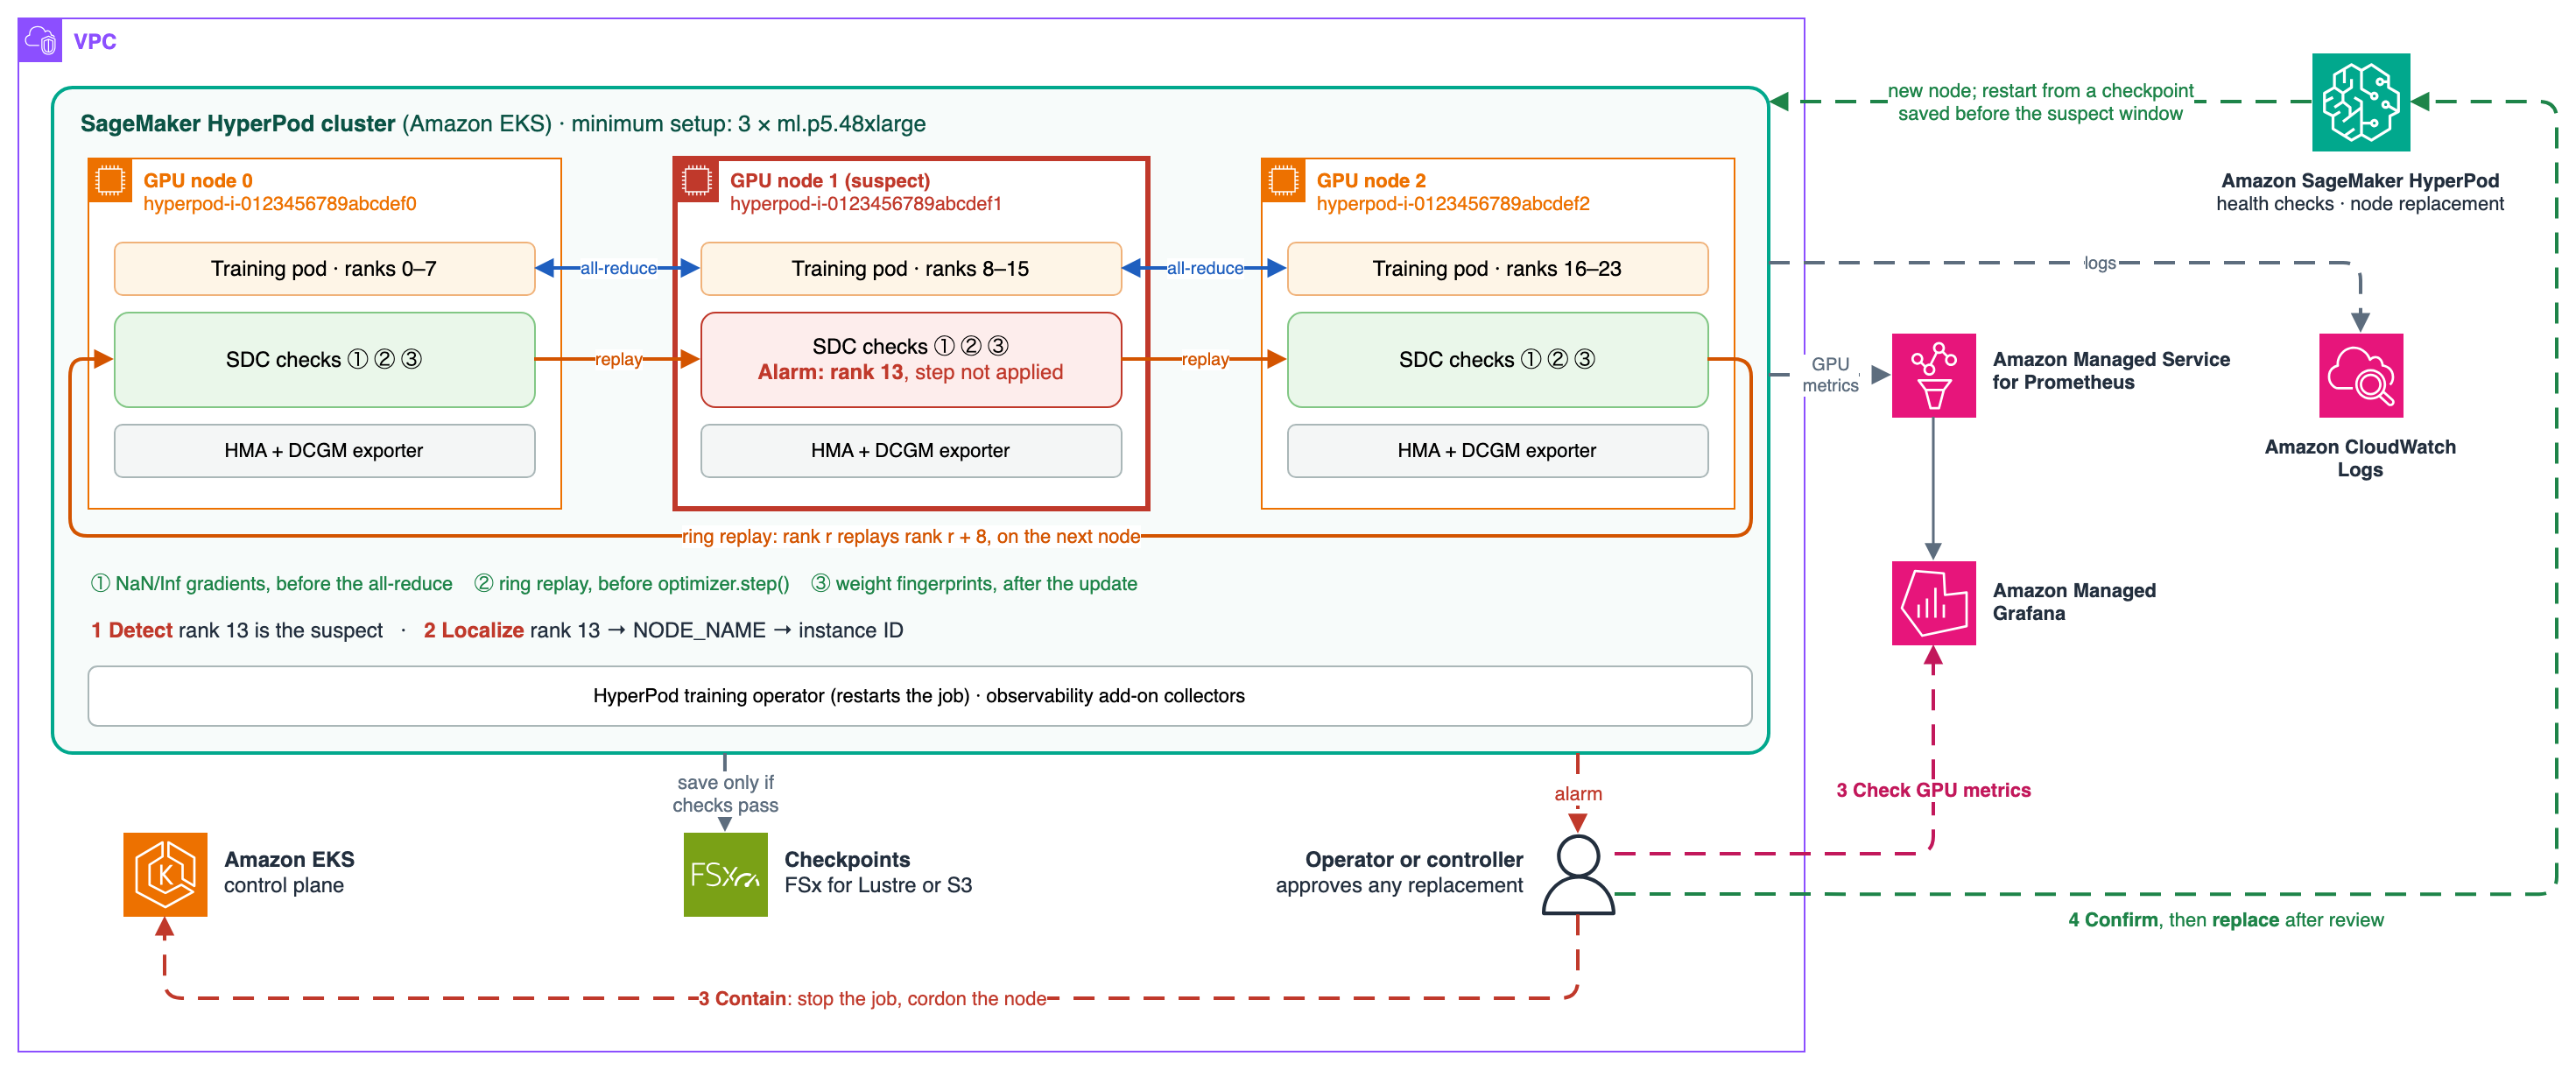
图 1:一个 SageMaker HyperPod EKS 集群,包含三个运行训练 pod 和 SDC 检查的 p5 节点。节点 1 对 rank 13 发出告警,建议的步骤会封锁该节点、检查 GPU 指标、替换节点并重启训练
把循环看作分层的会有所帮助,每层增加的东西各不相同:
| 层 | 来源 | 它增加了什么 | 能否捕获真正静默的 SDC? |
| 1. 非有限梯度检查 | 你的训练脚本 | 在 all-reduce 之前,点名本地梯度为 NaN 或 Inf 的 GPU,并在归约后的梯度为 NaN 或 Inf 时停止该步 | 只有那些变成 NaN、Inf 或溢出的故障 |
| 2. 环形重放审计 | 你的训练脚本 | 每个 GPU 重算另一个节点的 micro-batch,并比较 loss 位与梯度指纹 | 能,针对审计步骤中改变 loss 或梯度的有限计算路径故障 |
| 3. 权重指纹比较 | 你的训练脚本 | 在更新后,点名权重与严格多数副本不同的那个副本 | 能,针对单个副本上的优化器步骤和存储权重故障。对计算路径故障和分片权重无效 |
| 4. 定位 | 你的训练脚本,使用 SageMaker HyperPod 节点名称 | 将可疑 rank 从 Kubernetes 节点名称映射到实例 ID | 不适用:它的作用是定位 |
| 5. DCGM 关联 | HyperPod 可观测性附加组件 | 可疑 GPU 在告警前后的 DCGM 指标 | 只有故障同时出现在硬件计数器中时才能确认。干净的遥测数据并不能洗清一个节点。 |
| 6. 深度健康检查 | StartClusterHealthCheck (DCGM L4) |
对可疑节点按需执行的硬件诊断 | 它能捕获自身测试模式所触发的硬件缺陷。用于分诊,而非证明 |
| 7. 惯犯历史 | 你在保留的告警和遥测数据之上构建的查询 | 反复告警的节点 | 部分有效:它能提前浮现出值得检查的节点 |
层 1–3 是唯一能检测静默 SDC 的层,它们位于你的训练代码中。层 4 将它们的告警转换为实例 ID,而 HyperPod 层则佐证告警并形成闭环。
前提条件
要跟随本文操作,你需要:
- 一个由 Amazon EKS 编排、至少有三个 GPU 节点的 SageMaker HyperPod 集群。环形审计在每次完成比较时需要三个不同的节点,权重比较需要每个权重有三个副本才能找出异常的那个。参见 使用 Amazon EKS 编排 SageMaker HyperPod 集群。
- 一个 PyTorch DDP 训练任务,其中每个副本运行自己的优化器步骤,并配有可为给定步骤重建任意 rank 微批次的数据管道,例如带种子的采样器。
- 共享存储上的检查点,例如 Amazon FSx for Lustre 或 Amazon Simple Storage Service (Amazon S3)。替换节点会销毁其根卷和辅助卷,包括本地 NVMe 上的所有内容。
- 用于关联步骤的 SageMaker HyperPod 可观测性附加组件。如果需要 ECC、NVLink 和限流计数器,请开启高级 DCGM 指标。
- 通过
kubectl访问集群,并拥有sagemaker:StartClusterHealthCheck和sagemaker:BatchReplaceClusterNodes的 AWS Identity and Access Management (IAM) 权限。参见手动隔离、替换或重启节点。
第 1 步:在训练循环中通过三项检查进行检测
数据并行会同时训练模型的多个副本,称为副本。每个副本在批次的不同切片上进行训练。每次反向传播后,all-reduce 会对各副本的梯度取平均,每个副本在 optimizer.step() 中应用相同的平均值。下面是三个副本上的一个权重,学习率为 0.1:
| 副本 0 | 副本 1 | 副本 2 | ||
| 起始权重 | 0.500 | 0.500 | 0.500 | 相同 |
| 本地梯度 | 0.20 | 0.40 | 0.30 | 不同(数据不同) |
| 平均后的梯度 | 0.30 | 0.30 | 0.30 | 相同,在 all-reduce 之后 |
| 步骤后的权重 | 0.470 | 0.470 | 0.470 | 相同 |
本地梯度不同,因为每个副本看到的数据不同。而在优化器步骤之后,权重必须完全一致,逐位相同。
故障落在哪里决定了哪项检查能发现它。如果副本 1 计算出的本地梯度是 4.00 而不是 0.40,all-reduce 会把这个错误传播到每个副本:三个副本都应用同样的错误更新,它们的权重仍然一致。只有副本 1 的本地梯度看起来不同,且仅在 all-reduce 之前。反之,如果副本 1 在优化器步骤期间或之后损坏了权重,它的权重就不再与其他副本一致。有一个例外:某个副本权重中的 NaN 或 Inf 会通过下一次 all-reduce 传播到每个副本,此后副本之间又恢复一致。all-reduce 内部本身的故障(例如某个 GPU 加错一个部分和)也会同样传播到每个副本。
因此,计算路径上的故障必须在优化器步骤之前、在坏梯度还能被丢弃时捕获,而更新过程中的故障以及更新之后存储权重中的故障则要在其后捕获。有限错误值需要重算:跨副本比较梯度范数只能捕获 NaN 和 Inf(参见为什么不比较本地梯度范数?)。这样就得到对每个 DP rank 的三项检查,在每个训练步骤内按固定顺序执行:
- 非有限梯度检查 – 在 all-reduce 之前,标记任何本地梯度为 NaN 或 Inf 的 rank。这可以在故障发生的步骤捕获 GPU 前向或反向传播中爆掉的值,并指出具体是哪个 GPU。在 all-reduce 之后,也要在更新之前检查归约后的梯度是否为 NaN 或 Inf。
- 环形重放审计 – 在审计步骤中,优化器步骤之前,每个 rank 会重放另一个节点上某个 rank 的微批次。它逐位比较 loss,并在确定性内核下比较每个参数的梯度指纹。这可以捕获计算路径中的有限错误值。
- 权重指纹比较 – 在优化器步骤之后,每隔 N 步以及每次保存检查点之前,比较每个副本的权重指纹。这可以捕获优化器步骤中和存储权重中的故障。
本步骤中的代码适用于 PyTorch DDP。关于张量、流水线或上下文并行,请参阅 Beyond DDP。
执行顺序
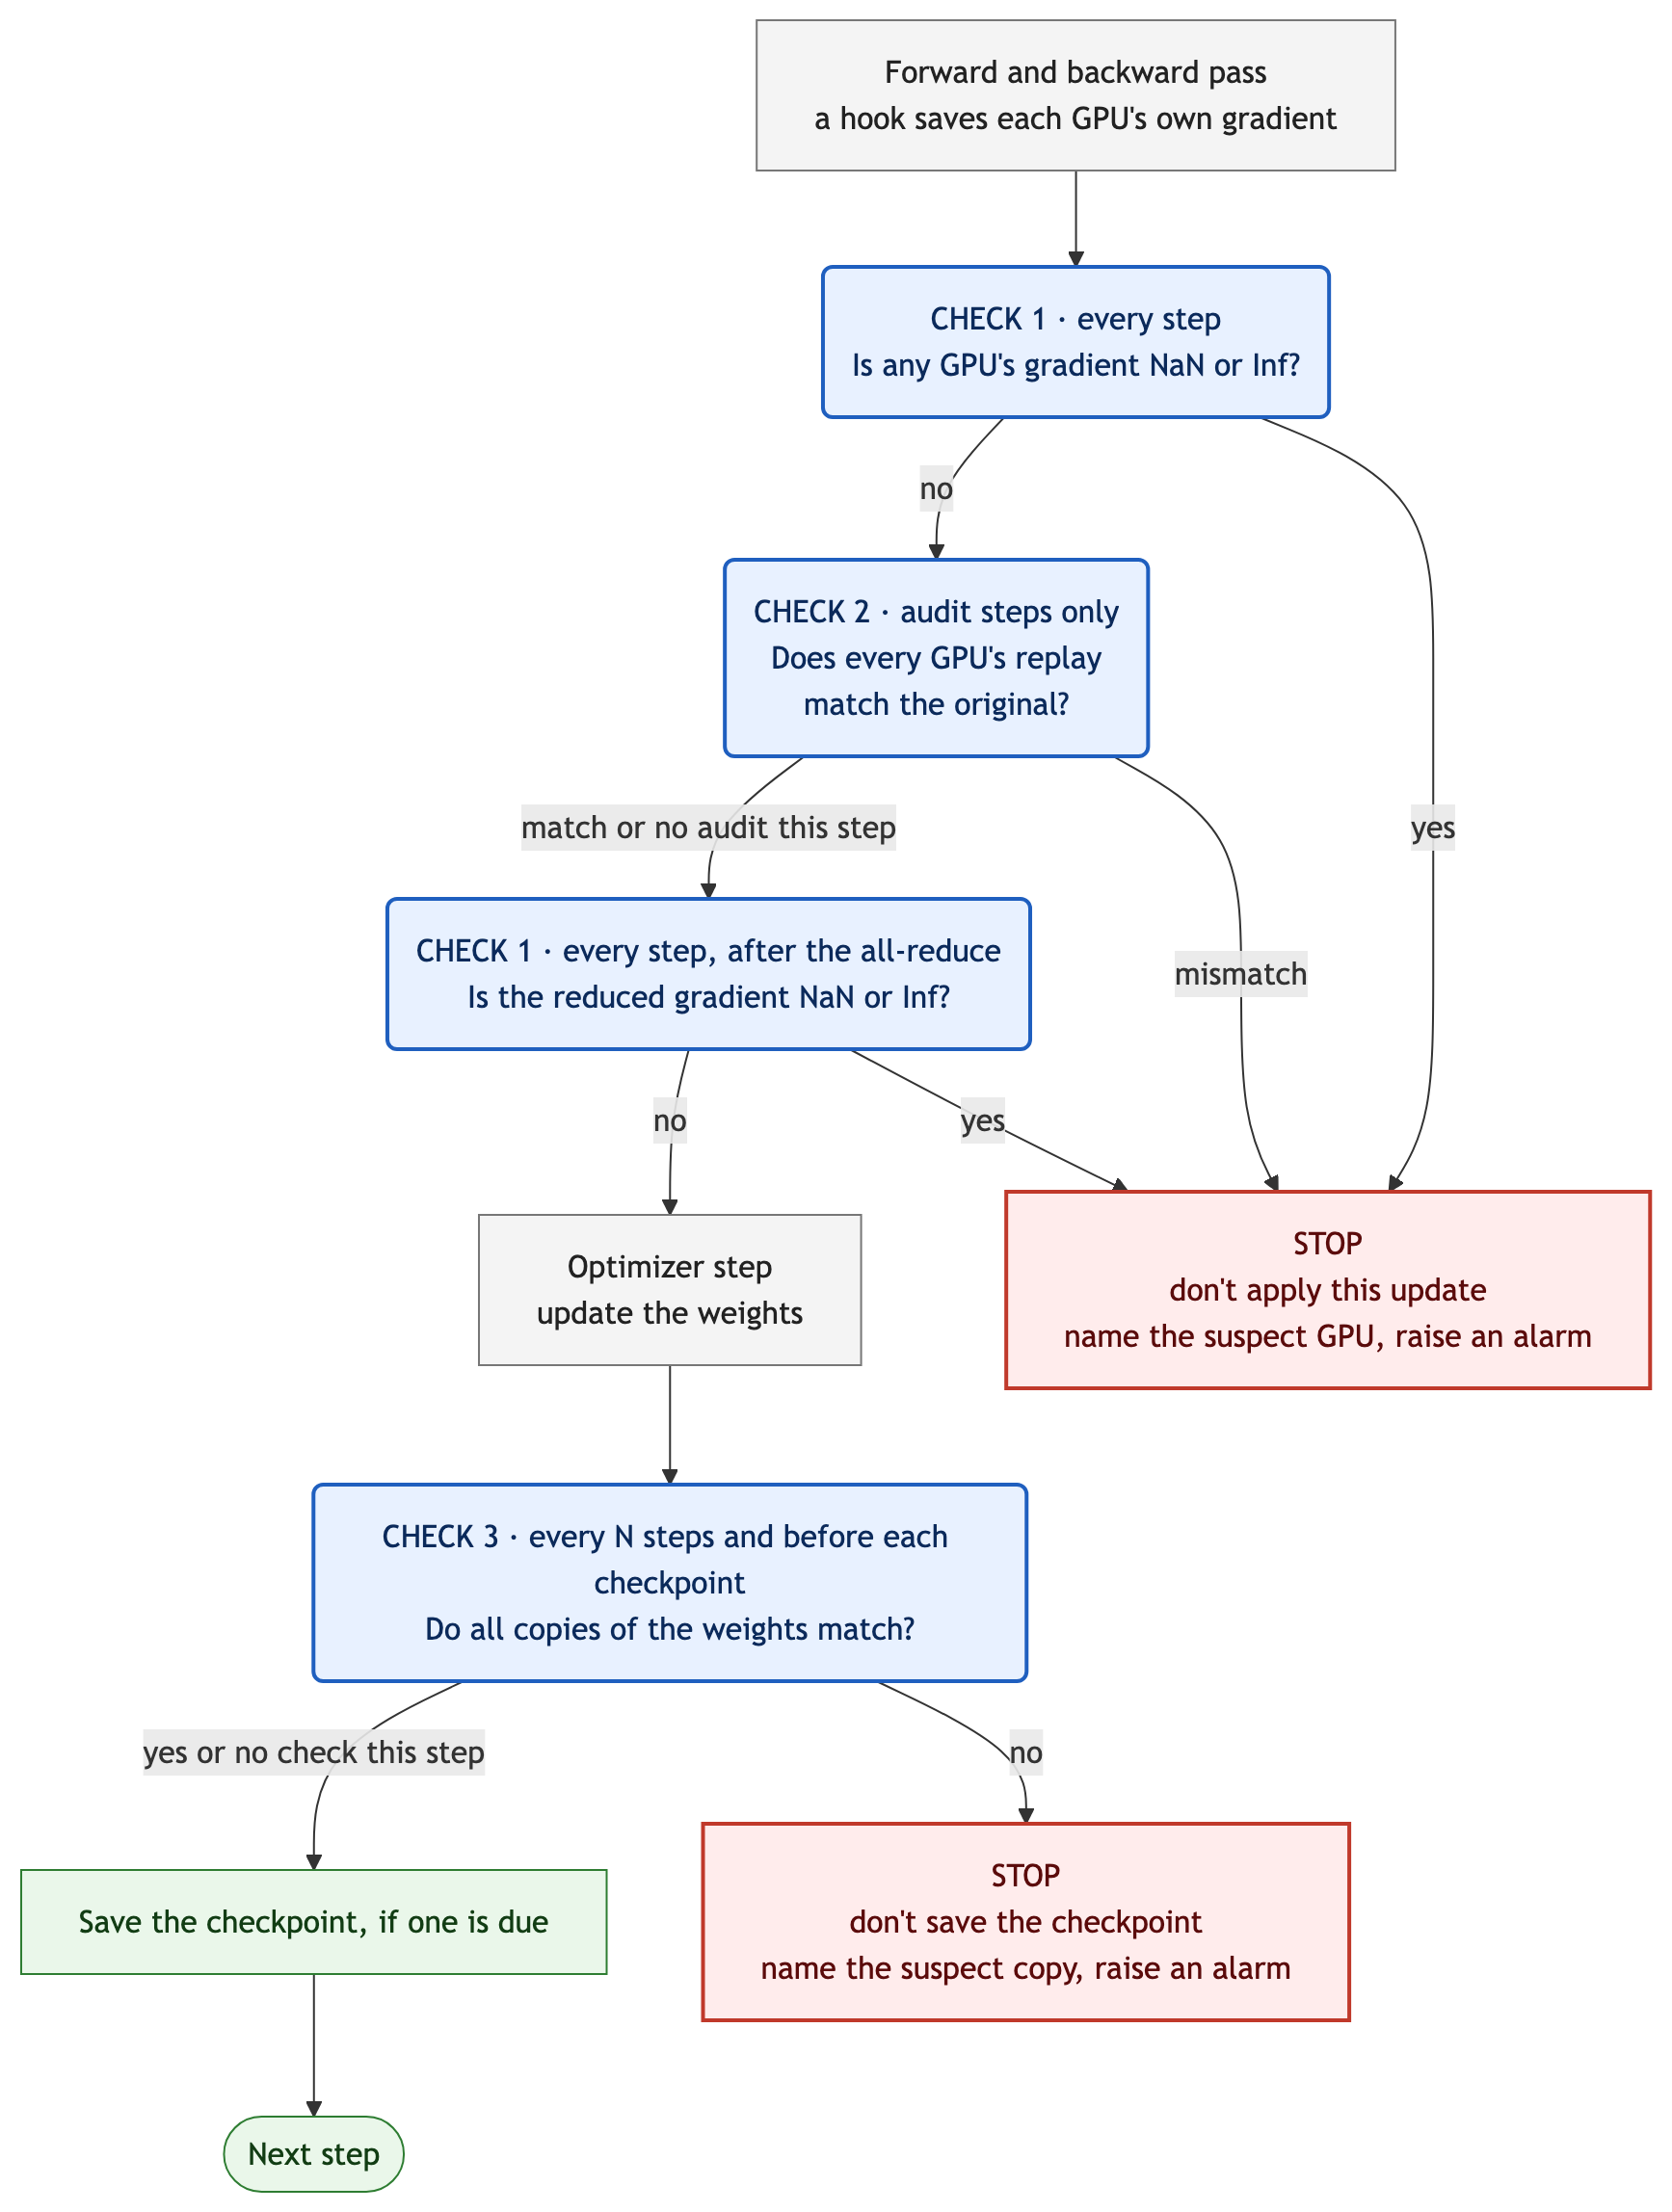
图 2:单个训练步骤的流程图。检查 1(NaN/Inf 梯度,在 all-reduce 之前和之后)和检查 2(环回重放,在审计步骤上)在优化器步骤之前运行,一旦触发就中止该步骤。检查 3(权重指纹)在优化器步骤之后运行,并阻止保存检查点
为什么不比较本地梯度范数?
一种自然的初始设计——也是我们最初采用的——将本地梯度范数偏离该步骤中位数超过 k 个中位数绝对偏差(MAD)的秩标记出来。我们在 32 块 H100 上训练一个 9.53 亿参数模型,在 4 个实例上的三次无故障运行的每一步(22,800 步,参见 Fault-free runs)都记录了每个秩的本地梯度范数,结果表明这个测试行不通:
- 健康分布太宽—— 每个秩看到的数据不同,因此健康的本地范数在前 800 步内就已达到 224 MAD,在所有健康步骤中达到 1,240 MAD。
- 宽松的阈值看不到任何有限故障—— 在 k = 336(前 800 个健康步中最高分数的 1.5 倍)时,它在剩余的 22,000 个健康步骤中产生了 11 次误报。而且没有任何有限故障接近该阈值:即使把一个激活值乘以 10,000,故障秩的分数也从未超过 6.9。
通过指纹进行比较
检查 2 和检查 3 会跨 GPU 比较张量。发送完整的张量代价太高,因此每个张量被压缩成一个指纹:其原始位模式的两个 64 位和,一个是普通和,一个是按位置加权的和。对于元素少于 2³²、每个元素不超过 4 字节的张量,对张量中一到两个元素的任何改动都会改变指纹。这覆盖了我们注入的每一个权重故障。更大的改动原则上可能相互抵消,因此指纹相等只是张量相等的有力证据,而非证明。按位置加权的和很重要:在我们的测试中,交换两个权重值再加上对两个值的补偿性改动,普通和保持不变,只有加权和才能发现它们。
_INT_VIEW = {1: torch.uint8, 2: torch.int16, 4: torch.int32, 8: torch.int64}

@torch.no_grad()
def fingerprints(tensors, chunk=1 << 24):
    # ... picks the device and allocates out: one row of two int64 per tensor
    for k, t in enumerate(tensors):
        if t is None:
            continue
        bits = t.detach().contiguous().view(-1).view(_INT_VIEW[t.element_size()])
        for i in range(0, bits.numel(), chunk):  # chunked to bound temporary memory
            b = bits[i:i + chunk].to(torch.int64)
            pos = torch.arange(i + 1, i + 1 + b.numel(), dtype=torch.int64, device=dev)
            out[k, 0] += b.sum()
            out[k, 1] += (b * pos).sum()
    return out
检查 1:NaN/Inf 梯度,在 all-reduce 之前和之后
DDP 通信钩子在每个秩的梯度被平均之前记录其本地梯度。它存储每个梯度桶的范数平方,并在确定性的审计步骤上存储每个参数梯度的指纹(供检查 2 使用)。然后它把梯度桶交给 PyTorch 标准的 all-reduce。
反向传播之后,nonfinite_ranks 从每个秩收集一个标量,并返回本地梯度范数为 NaN 或 Inf 的秩。第一个被标记的秩就是故障秩。如果应用了该步骤,NaN 将在下一步传播到每个秩。
def local_stats_hook(stats, bucket):
    stats.sq.append(bucket.buffer().float().pow(2).sum())
    if stats.record_fingerprints:  # per parameter, before allreduce_hook divides in place
        rows = [stats.row[p.data_ptr()] for p in bucket.parameters()]
        stats.fp[rows] = fingerprints(bucket.gradients())
    return allreduce_hook(stats.dp_group, bucket)

def attach(ddp_model, dp_group):
    stats = LocalStats(dp_group, list(ddp_model.module.parameters()))
    ddp_model.register_comm_hook(state=stats, hook=local_stats_hook)
    return stats

def nonfinite_ranks(stats):
    """After backward: global ranks whose local gradient norm is NaN or Inf."""
    local = torch.stack(stats.sq).sum().sqrt().reshape(1)
    n = dist.get_world_size(stats.dp_group)
    gathered = [torch.empty_like(local) for _ in range(n)]
    dist.all_gather(gathered, local, group=stats.dp_group)
    bad = ~torch.isfinite(torch.cat(gathered).cpu())
    return [dist.get_global_rank(stats.dp_group, r) for r in bad.nonzero().flatten().tolist()]
train() 还会在 all-reduce 之后检查梯度。在归约过程中产生的 NaN 或 Inf 会以同样的方式到达每个副本,因此副本仍然一致,检查 3 会放行它们。如果没有这项检查,NaN 会变成每个副本上的 NaN 权重,而该步骤应保存的检查点就会带着它们被保存并标记为通过。clip_grad_norm_ 已经计算了归约后梯度的范数,因此这项检查每步只增加一次单元素的 all-reduce。归约中的有限误差仍然会通过所有检查。
如果你使用 fp16 和梯度缩放器进行训练,请排除缩放器已经跳过的溢出步骤。bf16 没有这些步骤。
检查 2:环回重放,在优化器步骤之前
在 optimizer.step() 之前,每个副本都持有相同的权重。因此,在反向传播和优化器步骤之间,任何 rank 都可以重算任何其他 rank 的 micro-batch,而且在使用确定性内核时,结果必须完全一致到每一个比特。
在审计步骤中,每个 rank r 会重算 rank r + 8 的 micro-batch:也就是 8 个位置之后,在 p5 实例上恰好相隔一个节点。它使用未封装的模块,因此不会进行任何 all-reduce,并在之后恢复梯度、模块的缓冲区以及随机数状态。一次重放无论由多少个 rank 执行都会阻塞整个作业,所以审计所有 rank 与审计一个 rank 所耗的时间相同。
这样,每个 rank 都会出现在两次比较中:它自己的 micro-batch 被某个同伴重放,以及它为别人重放的 micro-batch。
- 两次比较都不匹配:该 rank 在两次计算中都算错了,因此它就是罪魁祸首。
- 只有一次不匹配:任何一方都可能是错的。
confirm会在原地解决这一问题:目标之后第 8 个位置的 GPU(位于第三个节点上)和目标本身各自再次重放目标的 micro-batch。这也能区分目标能够复现的持久性故障与无法复现的瞬时故障。
def ring_audit(module, compute_loss, rebuild_batch, step, stats, local_loss, offset, with_grads):
    # ... g is the DP group, n its size, and me this rank's position in it
    target = dist.get_global_rank(g, (me + offset) % n)
    replay = _replay(module, compute_loss, rebuild_batch(step, target), with_grads)
    # ... v = [this rank's own loss bits and gradient fingerprints, its replay of target]
    dist.all_gather_into_tensor(out, v, group=g)
    table = out.view(n, 2, -1).cpu()  # per DP rank: [own result, its replay of its target]
    pairs = [(dist.get_global_rank(g, (r + offset) % n), dist.get_global_rank(g, r))
             for r in range(n) if not torch.equal(table[(r + offset) % n, 0], table[r, 1])]
    return pairs, table

def localize(pairs):
    hits = Counter(r for p in pairs for r in p)
    culprits = sorted(r for r, c in hits.items() if c >= 2)
    ambiguous = [p for p in pairs if not set(p) & set(culprits)]
    return culprits, ambiguous

def confirm(module, compute_loss, rebuild_batch, step, pair, table, stats, offset, with_grads):
    # ... the third GPU (target + offset) and the target replay the target's micro-batch again
    third_r, self_r = v.cpu()
    orig, peer = table[ti, 0], table[ri, 1]
    if torch.equal(third_r, orig):
        return {"pair": pair, "third": third, "suspect": replayer, "kind": "replayer computed wrong"}
    if torch.equal(third_r, peer):
        kind = ("persistent" if torch.equal(self_r, orig) else
                "transient" if torch.equal(self_r, third_r) else "unclear")
        return {"pair": pair, "third": third, "suspect": target, "kind": kind}
    return {"pair": pair, "third": third, "suspect": None, "kind": "unattributable"}
只有当这三块 GPU 位于三个不同的节点上时,这次确认才是独立的。check_topology 会在训练开始前,从每个 pod 的 NODE_NAME 出发对每一对进行验证,否则就抛出错误。
选择审计模式:
- 默认内核:仅比较损失值。这要求前向传播的损失值可以逐比特复现,而我们的测试中确实如此:健康的重放与原始损失逐比特一致。梯度无法用这种方式比较,因为注意力机制的默认反向传播不是确定性的。这种模式能捕获改变损失值的前向传播故障。
- 确定性内核(
deterministic_audits=True):整个审计步骤使用确定性算法和数学注意力内核运行。此时梯度指纹也能匹配,因此审计还能捕获仅出现在反向传播中的故障。没有确定性实现的算子会抛出错误,而不是产生误报。在我们的模型上,一次确定性审计步骤的代价是默认版本的 2.4 倍。
绝不要只让嫌疑者自己重放它的工作。一块有持久性缺陷的 GPU 可以复现它自己的错误答案。
检查 3:优化器步骤之后的权重指纹
在 optimizer.step() 之后,每个副本的权重必须完全一致,因此无需调节容差。每个 rank 会对每个权重张量计算指纹,并收集所有 rank 的指纹。
只有当某个 rank 的张量副本与严格多数(超过一半)的副本不同时,才会点名该 rank。如果只有两个副本,或者出现没有严格多数的分裂局面,比较只会报告不一致,而不会点名任何 rank。
def find_divergent_ranks(params, dp_group):
    local = fingerprints(params).flatten()
    # ... all-gathers every rank's fingerprints into table: [dp_size, num_tensors, 2]
    differs = (table != table[0]).any(dim=2).any(dim=0)
    if not differs.any():
        return {"diverged": False, "suspects": []}
    suspects = set()
    for k in differs.nonzero().flatten().tolist():
        copies = [tuple(row) for row in table[:, k].tolist()]
        value, count = Counter(copies).most_common(1)[0]
        if 2 * count <= n:
            return {"diverged": True, "suspects": None}  # no strict majority for tensor k
        suspects.update(r for r, c in enumerate(copies) if c != value)
    return {"diverged": True,
            "suspects": sorted(dist.get_global_rank(dp_group, r) for r in suspects)}
每 N 个步骤以及每个检查点步骤运行一次。这是唯一在更新之后运行的检查,因此也是唯一能在损坏副本写出检查点之前将其阻止的检查。在测试中,某次更新之后立即被损坏的权重在下一个检查点步骤被捕获,保存没有发生。如果没有这个强制检查,保存就会从损坏的副本继续进行,而环形审计要到五步之后的下一次审计才会发现问题。
在 9.53 亿参数的模型上,每次检查耗时 31.1 毫秒:若每 10 个步骤运行一次,占一个步骤的 2%。
把检查放进训练循环
train 按图 2 的顺序执行每一步,并在第一个警报处停止。它在前向传播之前就判断某一步是否为审计步骤,因为确定性比较要求原始计算本身也是确定性的。当检查 1 或 2 触发时,它会将梯度清零并直接返回,不进行裁剪也不应用更新,因此坏梯度永远不会到达权重或优化器状态,且精确状态仍保留以供确认。裁剪之后,它会检查约减后的梯度是否为 NaN 或 Inf,如果是,则在更新之前返回。只有当没有任何警报触发时,它才保存检查点。
def train(ddp_model, stats, optimizer, batches, compute_loss, rebuild_batch, save_checkpoint,
          sched, start_step=0):
    # ... setup, including check_topology(dp_group, sched.peer_offset)
    for step, batch in enumerate(batches, start_step):
        audit = step % sched.audit_every == 0  # 0. decide first
        det = audit and sched.deterministic_audits
        # ... resets the hook's per-step state
        with deterministic() if det else nullcontext():
            loss = compute_loss(ddp_model, batch)  # 1. forward, backward
            loss.backward()
        nonfinite = nonfinite_ranks(stats)  # 2. non-finite check
        pairs, table = [], None
        if audit or nonfinite:  # 3. ring replay
            pairs, table = ring_audit(module, compute_loss, rebuild_batch, step, stats,
                                      loss, sched.peer_offset, with_grads=det)
        if nonfinite or pairs:  # 4. gate
            optimizer.zero_grad(set_to_none=True)  # step not applied
            culprits, ambiguous = localize(pairs)
            verdicts = [confirm(module, compute_loss, rebuild_batch, step, p, table, stats,
                                sched.peer_offset, with_grads=det) for p in ambiguous]
            return {"step": step, "check": "compute", "nonfinite": nonfinite,
                    "mismatched_pairs": pairs, "culprits": culprits, "verdicts": verdicts,
                    "suspect_window": _window(last_audit, step, start_step),
                    "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
        if audit:
            last_audit = step
        grad_norm = torch.nn.utils.clip_grad_norm_(params, sched.max_grad_norm)
        bad = (~torch.isfinite(grad_norm)).to(torch.int32).reshape(1)  # reduced gradient
        dist.all_reduce(bad, op=dist.ReduceOp.MAX, group=dp_group)
        if bad.item():
            optimizer.zero_grad(set_to_none=True)  # step not applied
            return {"step": step, "check": "reduced gradient", "suspect_window": [step, step],
                    "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
        optimizer.step()
        optimizer.zero_grad(set_to_none=True)
        ckpt = step % sched.ckpt_every == 0
        if step % sched.check_every == 0 or (ckpt and sched.check_on_checkpoint):
            wc = find_divergent_ranks(params, dp_group)  # 5. weight check
            if wc["diverged"]:
                return {"step": step, "check": "weights", "suspects": wc["suspects"],
                        "suspect_window": _window(last_weights, step, start_step),
                        "last_audit_pass": last_audit, "last_weight_check_pass": last_weights}
            last_weights = step
        if ckpt:  # 6. checkpoint
            save_checkpoint(step, tags={"last_audit_pass": last_audit,
                                        "last_weight_check_pass": last_weights})
    return None
警报的 suspect_window 是自触发检查的上一次执行以来的步数范围。从出现起每一步都处于活跃状态的故障必定始于该范围内。间歇性故障可能更早,而没有任何检查看到的故障可能存在于任意检查点,因此应把这些标签视为该步骤检查已通过记录,而不是保存状态无恙的证明。
训练脚本像这样调用它:
# ... imports, and the model, optimizer, and dataset setup
import sdc_order as S

stats = S.attach(ddp_model, dp_group)  # registers the comm hook, once
sched = S.Schedule(audit_every=10, deterministic_audits=True, check_every=10,
                   ckpt_every=100, peer_offset=8)  # 8 = GPUs per node

def compute_loss(model, batch):  # used for training AND replay
    x, y = batch
    with torch.autocast("cuda", dtype=torch.bfloat16):
        logits = model(x)
    return F.cross_entropy(logits.float().flatten(0, 1), y.flatten())

def rebuild_batch(step, rank):  # exactly the micro-batch `rank` trained on
    return dataset.micro_batch(step, rank)

# ... batches(start) yields this rank's micro-batches and sets the learning rate
alarm = S.train(ddp_model, stats, optimizer, batches(start), compute_loss, rebuild_batch,
                save_checkpoint, sched, start_step=start)
if alarm is not None:
    report_sdc(alarm)  # metric + log line; Step 2 maps the rank to a node
    sys.exit(3)
重放依赖于以下几点:
- 精确的微批次:
rebuild_batch(step, rank)必须返回与该 rank 训练时完全相同的微批次,例如通过带种子的采样器实现。 - 相同的损失函数:
compute_loss在训练和重放中必须是同一个函数,包括 autocast 在内,且其内部的任何随机性(如 dropout)都必须按每步和每个 rank 设置种子。 - 模型中不使用集合通信或影响输出的状态:确认重放仅在两个 rank 上运行,即目标 rank 和第三块 GPU,因此前向或反向传播中调用集合通信的模型(例如 SyncBatchNorm)会在歧义警报时挂起。前向传播既读取又更新的缓冲区会让健康的重放产生差异。
- 确定性设置:在训练进程启动之前设置
CUBLAS_WORKSPACE_CONFIG=:4096:8,并确保模型中的每个算子都有确定性实现。 - 对等节点偏移:逐节点对 DP rank 进行编号,使
peer_offset等于每节点 GPU 数时,每个重放者都位于另一个节点上。check_topology会拒绝不满足此条件的布局。 - 此处未测试:未使用的参数、梯度累积、BatchNorm 以及有副作用的 forward hook。存在未使用参数时,请设置
deterministic_audits=False,它只比较损失值。
audit_every 是成本与稳健性之间的主要调节项:
- 检测延迟:持续性的有限故障若也发生在审计运行的核中,会在
audit_every步内被捕获。确定性审计运行确定性核和数学注意力核,因此仅限于其他步骤所使用的默认核的故障永远不会被审计。 - 被污染的更新:在审计捕获之前,最多可以有
audit_every− 1 次被污染的更新被应用。它们都落在警报的suspect_window之内。 - 一次性故障:发生在单个非审计步骤且不再复现的有限故障完全不会被捕获。
把 ckpt_every 设为 audit_every 和 check_every 的公倍数,这样每个检查点步骤都会在更新之前被审计、在更新之后被指纹化。
我们在 953M 模型和 32 块 H100 上,对每种调度测量了每步 1,000 个连续步骤的端到端平均步时。所有带检查的调度同时每 10 步运行一次权重检查:
| 调度 | 平均步时 | 相对纯 DDP |
| 纯 DDP,无检查 | 157.4 ms | — |
| 检查,无审计 | 169.0 ms | +7.4% |
| 每 10 步进行确定性审计 | 211.9 ms | +34.7% |
| 每 10 步进行默认核审计 | 177.0 ms | +12.5% |
| 每 100 步进行确定性审计 | 173.3 ms | +10.1% |
| 每 100 步进行默认核审计 | 169.3 ms | +7.6% |
每种方案的成本中约有 7 个百分点与审计无关:每一步的梯度钩子和两次 NaN/Inf 检查,以及每 10 步一次的权重检查。生产环境的合理起点是每 100 步做一次确定性审计,此处成本为 10%。它仍能在 100 步内捕获持续性故障,包括仅反向传播的故障,代价是可能需要回滚多达 99 次被污染的更新。当需要更快检测时,例如在新算力上进行预热训练或观察可疑节点时,可改为每 10 步审计一次。请在自己的模型上实测成本:确定性注意力使用 math 内核,其成本随序列长度的平方增长。
在无故障运行中,15,320 次审计步和 3,080 次权重检查均未触发警报,这将误报率限制在约每 5,100 次审计步 1 次(95% 置信度)。
第 2 步:将可疑 rank 定位到某个节点
rank 是一个逻辑 ID。要对它采取行动,你需要实例和物理 GPU。在 HyperPod EKS 上,Kubernetes 节点名是带有 hyperpod- 前缀的实例 ID。通过 Kubernetes downward API 将其传递给你的 pod:
env:
- name: NODE_NAME  # on HyperPod EKS, spec.nodeName is "hyperpod-<instance-id>"
  valueFrom:
    fieldRef:
      fieldPath: spec.nodeName
在任务启动时,记录一张表,将每个 rank 映射到其节点、实例和 GPU UUID:
import os
import torch
import torch.distributed as dist

node = os.environ["NODE_NAME"]  # "hyperpod-i-0123456789abcdef0"
instance_id = node.removeprefix("hyperpod-")  # "i-0123456789abcdef0", what the Replace API takes
gpu_uuid = "GPU-" + str(torch.cuda.get_device_properties(torch.cuda.current_device()).uuid)
info = {"rank": dist.get_rank(), "node": node,
        "instance_id": instance_id, "gpu_uuid": gpu_uuid}
table = [None] * dist.get_world_size()
dist.all_gather_object(table, info)
if dist.get_rank() == 0:
    print("rank_map", table)  # log at every job start
如果任务已在没有 downward API 的情况下运行,你可以从外部用 kubectl get pod <pod> -o jsonpath='{.spec.nodeName}' 将 pod 映射到其节点。
第 3 步:控制影响范围并检查 GPU 指标
当警报触发时,先停止任务。然后在调查期间通过封锁(cordon)该节点,阻止新工作落到可疑节点上:
kubectl cordon <node-name> # marks the node unschedulable; existing pods keep running然后在 SageMaker HyperPod 可观测性插件中打开 GPU 健康仪表板,筛选到可疑节点和 GPU,查看警报触发的时间。该 GPU 上可纠正 ECC 错误、PCIe 重传、降频或温度的上升会增强硬件故障的判断信心。仪表板干净并不能洗清该节点:纯 SDC 往往在硬件遥测数据中不留痕迹。
第 4 步:确认后更换节点
在第 1 步的检查运行的情况下,警报已经指明了可疑 GPU。当你看到症状但没有警报(例如损失激增),或者想在更换任何东西之前排除软件问题,先从简单的解释入手。大多数损失激增并非 SDC,在数据 bug 上追查 SDC 会浪费数天时间:
Loss anomaly / suspected corruption
- Reproduces with the same seed on DIFFERENT nodes? -> deterministic bug, not SDC
- Goes away, or follows one node, when you move the job? -> strong SDC candidate
- DP replicas that must be bitwise identical disagree? -> strong SDC signal
- One rank's step replayed on another node gives different bits? -> strong SDC signal
- One rank's pre-all-reduce gradient is NaN or Inf? -> SDC candidate (use the first step it fired)
- Fleet-wide and gradual? -> likely recipe or optimizer
- Started at a data, config, or library change? -> usually software, but not proof
区分 SDC 与软件问题的关键测试是:问题是否跟随硬件:
- 可复现的故障并不能排除 SDC – Meta 将一个出故障的工作负载固定在单个核心上,对特定输入每次都得到相同的错误答案。
- 故障始于软件变更也不能排除 SDC – Google 将一起事故追溯到一次正确的库更新,该更新开始在缺陷核心上使用很少被使用的指令。
- 不要指望全局损失指向任何地方 – 前向故障首先改变故障 rank 自身的损失,然后 all-reduce 将其梯度传播到每个副本。按 rank 检查和重放才能给你定位信息。
判断警报的含义
| 警报 | 含义 | 建议操作 |
check == "weights", suspects == [r] |
更新后 rank r 的副本与严格多数不一致 | 保持 r 所在节点封锁。审查后更换 |
check == "weights", suspects is None |
副本不一致,但无严格多数 | 情况不明确:保持相关节点封锁。检查 DCGM 并运行深度健康检查 |
culprits == [r] |
r 的两次环形比较结果均不匹配。此判定假设在彼此重放的 GPU(即本地索引相同的 GPU)中最多只有一块故障 GPU。若有两块,健康的 GPU 也可能被点名 | 保持隔离。经审查后更换,或在故障重复出现后更换 |
| 判定:持久性故障 | 目标 GPU 复现了它自己的错误答案,且第三块 GPU 也认同重放结果 | 保持隔离。经审查后更换 |
| 判定:瞬时性故障 | 目标 GPU 重试后得到了正确答案,并与第三块 GPU 一致。间歇性故障也可能呈现同样的现象 | 保持隔离,直到以该节点为目标完成一次审计或深度健康检查并通过。若再次发生则更换 |
| 判定:重放 GPU 计算出错 | 出错的是重放的 GPU,而非目标 GPU | 将该重放 GPU 视为嫌疑对象,并再次确认 |
| nonfinite 集合,无不匹配的配对 | 反向传播中出现了损失函数未显示的 NaN 或 Inf,或梯度范数超出 float32 的范围(大于约 1.8 × 10¹⁹) | 结果不明确:以嫌疑 GPU 为目标进行审计,或检查 DCGM 并运行深度健康检查 |
check == "reduced gradient" |
all-reduce 之后梯度为 NaN 或 Inf,但每个 rank 的本地梯度都是有限的。没有点名具体 rank | 结果不明确:保持作业停止,检查 DCGM 并对作业中的每个节点运行深度健康检查,然后从告警步骤之前保存的检查点恢复 |
| 判定:无法归因或不明确 | 三块 GPU 的结果无法相互印证 | 结果不明确:检查 DCGM 并对涉及的节点运行深度健康检查 |
在生产环境中,在你就自己的工作负载验证过这些检查的精确度之前,每次更换节点都应保留人工审批。我们这样的合成测试并不能证明这一点。
确认不明确的告警
深度健康检查是处理不明确告警的主要工具。其压力测试能捕捉硬件报告的故障,而细微的数据依赖性故障往往能通过。在嫌疑实例组上运行深度健康检查:
aws sagemaker start-cluster-health-check \
    --cluster-name <cluster-name> \
    --deep-health-check-configurations '[{"InstanceGroupName":"<instance-group>","InstanceIds":["i-0123456789abcdef0"],"DeepHealthChecks":["InstanceStress"]}]'
更换节点
当你准备更换节点时,有两种选择。两者都会触发相同的 SageMaker HyperPod 恢复流程,详见 手动隔离、更换或重启节点。
如果开启了自动节点恢复,你可以给节点打上标签,让 SageMaker HyperPod 来更换它,这对自动化很方便:
kubectl label node <node-name> \
    sagemaker.amazonaws.com/node-health-status=UnschedulablePendingReplacement --overwrite
如果想使用 API,请运行:
aws sagemaker batch-replace-cluster-nodes --cluster-name <cluster-name> --node-ids <instance-id>在使用 Karpenter 进行自动扩缩容的集群上,BatchReplaceClusterNodes 会终止该节点,但只有在有待处理的 pod 需要时才会创建替换节点。替换节点加入后,训练作业通过 SageMaker HyperPod 训练控制器或作业的重启策略重启,你的训练脚本从告警的 suspect_window 开始之前保存的最新检查点恢复。加载检查点后立即调用 find_divergent_ranks,并在第一步之前完成。更换节点会销毁该节点的根卷和辅助卷,因此请将检查点保存在共享存储上。
将工作流自动化
手动步骤是为了便于理解。在生产环境中,把它们封装进一个在你自己的集群和账户中运行的小型控制器:
- 触发: 训练作业将该告警报告为 Kubernetes 事件、一个小型自定义资源(例如 SDCReport{rank, job, step, check}),或者针对
sdc_nonfinite_grad、sdc_replay_mismatch和sdc_divergent_tensors等指标的 Amazon CloudWatch 告警。 - 解析: 控制器通过 Kubernetes API 将 rank 映射到 pod 再到节点,然后通过去掉
hyperpod-前缀将节点映射到实例 ID。 - 遏制: 控制器将该节点隔离。
- 判定(Decide): 它应用第 4 步中的表格。环形审计已就地确认了歧义对,因此警报携带判定结果。对于歧义结果,它会运行一次节点范围的深度健康检查。
- 恢复(Recover): 对于替换操作,它会请求人工批准,然后调用
BatchReplaceClusterNodes,或在启用了自动节点恢复的情况下设置节点健康标签。随后它依赖训练操作器和你的检查点重载,并将每一步记录到 CloudWatch 中。
可以将它构建为一个轻量级 Kubernetes 操作器,或者作为一条 Amazon EventBridge 规则,在 CloudWatch 警报触发时调用 AWS Lambda 函数。
用例:在 SageMaker HyperPod 上测试这些检查
我们在一个由 Amazon EKS 编排的 SageMaker HyperPod 集群上运行了两次测试,分别使用 4 个和 3 个 ml.p5.48xlarge 实例(每个配备 8 块 NVIDIA H100 80GB HBM3 GPU),以及来自 AWS Deep Learning Containers 训练镜像的 PyTorch 2.9.0(CUDA 13.0)。模型是一个 9.53 亿参数的 Llama 风格解码器,含 16 层、隐藏层大小 2,048、16 个注意力头、32,000 词元词表,以及 2,048 词元的序列。每块 GPU 每步处理 2 个序列(32 块 GPU 上每步 131,072 个词元),权重、梯度和优化器状态均为 fp32,计算采用 bf16 自动混合精度。我们使用 AdamW 训练,在 100 步线性预热后学习率为 3 × 10⁻⁴,betas 为 (0.9, 0.95),权重衰减 0.1,梯度裁剪 1.0。数据是合成的:一个复制任务,词元服从 Zipf 分布且前半部分重复,按 rank 和步数设定随机种子,以便任何微批次都可重建。
故障场景
故障注入在一层上,即 16 个解码器块中第 8 块的 MLP 下投影,发生在选定的 rank 和步数上:
- 前向故障改变该层的输出但保留其梯度路径,例如前向传播中一次错误的乘法。
- 仅反向故障改变该层输入或权重的梯度。
- 权重故障在优化器步骤之后立即改变某块 GPU 上存储的权重的副本:一位翻转、两个值的交换,或对两个值进行互相抵消的改动。
- 持久性故障会在故障 GPU 计算的所有内容中反复出现,包括它为其他 rank 执行的重放。瞬时性故障只触发一次。
每个场景都从 400 步预热后拍摄的快照重启,步数从该快照起计。除非另有说明,审计每 10 步运行一次(使用确定性内核),权重检查每 10 步一次,检查点每 20 步一次。表格展示的是 4 实例的结果。在 3 实例上,每个场景都触发了相同的警报,发生在相同的步数,来自相同的检查,指名相同的 rank。只有对等 rank 发生了变化。
| 注入的故障 | 结果 | 由哪个检查发现 |
| rank 13 前向输出中的一个元素为 NaN,仅发生在第 25 步(不是审计步) | 在第 25 步触发并指名 rank 13。环形重放也已运行。由 rank 21 和 rank 13 确认:rank 13 上为瞬时故障。第 25 步未被应用。疑似窗口:第 21–25 步 | 检查 1 |
| rank 13 前向输出中的一个元素 ×1,000,从第 23 步起每步都发生 | 第 23–29 步通过了检查 1 并被应用。第 30 步的审计在 (13, 5) 和 (21, 13) 之间不匹配并指名 rank 13。第 30 步未被应用。疑似窗口:第 21–30 步 | 检查 2 |
| 仅在第 30 步这一审计步上出现相同的 ×1,000 | 一对不匹配:(13, 5)。由位于第三个节点上的 rank 21 以及 rank 13 确认:rank 13 上为瞬时故障 | 检查 2 |
| 第 5 号名次(rank 5)上持续存在的 ×1,000 故障,它会重放 rank 13 的微批次 | 配对 (13, 5) 和 (5, 29) 不匹配。指认了 rank 5。若 rank 5 只重放 rank 13 一次,就会把健康的 rank 13 指为嫌疑对象 | 检查 2 |
| rank 13 上的其他前向故障,从第 23 步起每一步:一个元素 ×10,000、整个输出上 10% 的乘性噪声、一个 bf16 元素的第 3 位翻转、以及一个输出列 ×1.1 | 每项都在第 30 步指认了 rank 13。位翻转和 ×1.1 列在默认内核审计下也被发现 | 检查 2 |
| 从第 23 步起每一步(仅反向传播),流入 rank 13 那一层的梯度中的一个元素,或其权重梯度中的一个元素,×1,000 | 仅凭梯度指纹,就在第 30 步指认了 rank 13 | 检查 2 |
| 上述权重梯度故障,使用默认内核审计 | 50 步内没有报警。第 20 步和第 40 步的检查点被打上了审计通过和权重检查通过的标签,因为损失未受影响,且每份副本都应用了相同的损坏更新 | 未捕获 |
| 在 rank 13 和 rank 22 上同时存在的持续前向 ×1,000 故障 | 配对 (13, 5)、(21, 13)、(22, 14) 和 (30, 22) 不匹配。指认了 rank 13 和 rank 22 | 检查 2 |
| 在第 31 步更新之后,rank 0 上一个 fp32 权重元素的第 22 位翻转,每 5 步保存一次检查点 | 检查点第 35 步的强制权重检查指认了 rank 0,保存没有发生。嫌疑窗口:第 31–35 步 | 检查 3 |
同样的故障,使用 check_on_checkpoint=False |
第 35 步的保存照常进行,用的是 rank 0 的损坏副本。其标签显示最后一次通过权重检查是在第 30 步。环形审计在第 40 步指认了 rank 0,依据是配对 (8, 0) 和 (0, 24) | 检查 2 |
| 在第 31 步更新之后,rank 0 上一个权重张量中的两个值互换,或在两个值的位模式上分别加上 +4,096 和 −4,096,无审计,每 10 步做一次权重检查 | 每项都在第 40 步的权重检查时指认了 rank 0,尽管该张量的普通位求和并未改变 | 检查 3 |
| 在恢复快照(作为加载检查点的替身)之后,rank 7 上一个注意力权重第 22 位翻转 | find_divergent_ranks 在第一步之前运行,指认了 rank 7 |
检查 3 |
无故障运行
为了测量误报率,我们在两种集群规模上均无故障地训练,每种规模使用三个调度。每个调度每 10 步运行一次权重检查,不保存任何检查点,且每次运行的时长固定为若干分钟,因此每步都审计的两个调度贡献了大部分审计步数:
| 实例数 | 审计 | 分钟 | 步数 | 审计步数 | 权重检查 | 报警 |
| 4 | 确定性内核,每步 | 45 | 4,600 | 4,600 | 460 | 0 |
| 4 | 默认内核,每步 | 22.5 | 5,400 | 5,400 | 540 | 0 |
| 4 | 确定性内核,每 10 步 | 45 | 12,800 | 1,280 | 1,280 | 0 |
| 3 | 确定性内核,每步 | 15 | 1,600 | 1,600 | 160 | 0 |
| 3 | 默认内核,每步 | 7.5 | 2,000 | 2,000 | 200 | 0 |
| 3 | 确定性内核,每 10 步 | 15 | 4,400 | 440 | 440 | 0 |
| 总计 | 150 | 30,800 | 15,320 | 3,080 | 0 |
15,320 个审计步中 0 次报警,根据三分法则,每个审计步误报率的 95% 置信上界为 3 / 15,320,约五千分之一。NaN/Inf 检查在任何无故障步骤上也未触发。为什么不比较本地梯度范数?中的梯度范数分析仅使用了 4 实例的运行。
超越 DDP
权重比较并不局限于 DDP。find_divergent_ranks 接受任意数据并行组,因此它也适用于张量并行、流水线并行、上下文并行、HSDP 以及专家混合——这些布局都保留了每个权重的独立副本。在 ZeRO-1 或完整 FSDP 分片下它无法发挥作用,因为每个分片的更新只在单一 rank 上计算。本文中的检查和训练循环仅在 DDP 下测试过。
要在其他布局中使用它,请用持有相同分片副本的组调用 find_divergent_ranks。只有两个副本时,它能检测到不一致,但无法指出有故障的副本。
如果你希望服务替你检查节点,SageMaker HyperPod 还提供 MultiNodeTraining 深度健康检查。它在一批 GPU 节点上运行一个简短的、固定的分布式训练作业,无需更改代码,并替换那些训练损失变为 NaN 或 Inf、发散或未在时间内完成的节点。创建实例组时,请将其与 InstanceStress 和 InstanceConnectivity 一起选择,或使用 StartClusterHealthCheck 按需运行。它是对本文中检查的补充:在你的作业落到节点之前,用它筛选新节点和替换节点;而作业内检查则用于捕捉你自身训练中那些从未变成 NaN 或 Inf 的错误值。详情请访问 SageMaker HyperPod 深度健康检查。
清理
为避免产生持续费用,请删除为测试创建的资源。如果你创建了 HyperPod 集群,请使用 aws sagemaker delete-cluster --cluster-name <cluster-name> 删除它。这只会移除 HyperPod 资源。请在删除 HyperPod 集群之后,再单独删除 EKS 集群、其插件以及任何 Amazon FSx 卷。参见 删除 SageMaker HyperPod 集群。
结论
在本文中,我们展示了如何在数据并行训练中检测静默数据损坏,以及如何将可疑节点交给 SageMaker HyperPod 进行替换。三项检查覆盖了故障可能出现的三个位置:对每个 rank 的梯度和归约后的梯度进行 NaN/Inf 检查、将每个 GPU 的工作与另一个节点上的 GPU 进行比较的环回放,以及更新后的权重指纹比较。在优化器步骤之前运行前两项检查,不要应用未通过检查的步骤,并在每次保存检查点之前比较权重。SageMaker HyperPod EKS 集群上的节点名称可将可疑 rank 转换为实例 ID。然后隔离该节点,回滚到可疑时间窗口之前的检查点,并让节点健康标签或 Replace API 完成恢复。
要开始使用,请查看 SageMaker HyperPod 针对 Amazon EKS 的弹性功能,并尝试配套代码仓库。要深入了解,请参阅深度健康检查和可观测性插件。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com