Natera 基于 Amazon Bedrock AgentCore 构建实验室运维智能体系统 SWARM
How Natera designed an agentic AI system for lab ops with Amazon Bedrock AgentCore
Natera 与 AWS 合作构建实验室运维智能体系统 SWARM,将工单平均首次响应时间从 17.4 小时降至约 8 分钟(约 130x),96.2% 的工单实现自动化首次响应。
Natera 是无细胞 DNA(cfDNA)检测领域的领导者,保持实验室仪器持续运转对其至关重要,因为设备停机会中断样本处理。由 Ariel Jirau 领导的 Natera 实验室工程团队与 AWS 合作,构建了 SWARM(Systematic Workflow Analytics and Resolutions Manager,系统化工作流分析与解决方案管理器),这是一套面向实验室运营的智能体 AI 系统。
本文介绍 Natera 团队如何使用 Amazon Bedrock AgentCore 构建一套面向实验室运营的智能体 AI 系统,以规模化地捕获和运用机构知识。文中描述了从知识库构建到自动化系统部署和评估的完整架构,你可以将相同的模式应用到自己的运营工作流中。
SWARM 将首个响应时间缩短约 130 倍,并在所有支持工单中实现 96.2% 的自动化覆盖率,使工程师在工单一到达时就能立即获取机构知识。
挑战:知识连续性
Natera 的实验室运营依赖涵盖多个设备系列的各种精密仪器,每类设备都有自己的故障模式、供应商文档和解决方案模式。负责维护这些基础设施的服务工程团队围绕个人深度专长来组织,而不是标准化的操作手册。当一位花了多年时间诊断某一特定仪器系列的高级技术人员离职时,他掌握的机构知识实际上就丢失了。当时没有任何系统可以规模化地捕获、组织或运用这些专长。
面对三个 Jira 队列每天超过 65 张工单、平均首次响应时间 17.4 小时的情况,仪器停机延迟了实验室样本和患者报告。仅靠招聘更多工程师无法跟上步伐。SWARM 必须在几分钟内作出响应,在各种设备类型上提供准确的诊断,并通过结构化的评估循环持续改进。
Natera 为什么选择 Amazon Bedrock AgentCore
Natera 团队选择基于 Amazon Bedrock AgentCore 构建 SWARM,这是 AWS 推出的一项全托管、可扩展的服务,旨在规模化地构建、部署、连接、保护和运行 AI 智能体。这一决定基于三个核心需求:
- 无需人工干预即可自主处理海量支持工单。
- 与 Jira 和 Confluence 等现有运营工具深度集成。
- 内置安全性和可观测性(加密、AWS Identity and Access Management(IAM)集成以及分布式追踪),无需团队自行构建和维护定制基础设施。
“我们需要一个托管运行时,让我们可以把工程精力集中在诊断准确性上,而不是基础设施的繁琐工作上——AgentCore 满足了这一需求,还提供了内置的身份管理,以及无需重写智能体逻辑即可更换模型的灵活性,”Jirau 说。
AgentCore 提供与多项服务的原生集成,包括全托管 NoSQL 数据库服务 Amazon DynamoDB、Amazon Simple Queue Service (Amazon SQS),以及作为 Amazon CloudWatch 一项能力的 AWS X-Ray。
SWARM 的工作原理:两个智能体,一个技能库
SWARM 使用两个互补的运行时,共享同一个技能库。swarm-agent 会在工程师打开工单之前自主生成结构化的诊断报告,而工程师则使用 swarm-hive 进行实时交互、上传图片并探索其他故障排查路径。
“该系统不会取代工程师——而是在工单一到的那一刻,就让他们能够获取机构知识的全部深度,”Jirau 说。
四层结构连接整个架构:
- 事件层通过 Amazon EventBridge 和 Amazon SQS 路由 Jira 工单。
- 智能体层托管 swarm-agent、swarm-hive 和技能库,并将诊断报告返回给工程师。
- 上下文层利用供应商手册、历史工单和运营数据。
- 可观测性与交付层捕获追踪、日志和指标。
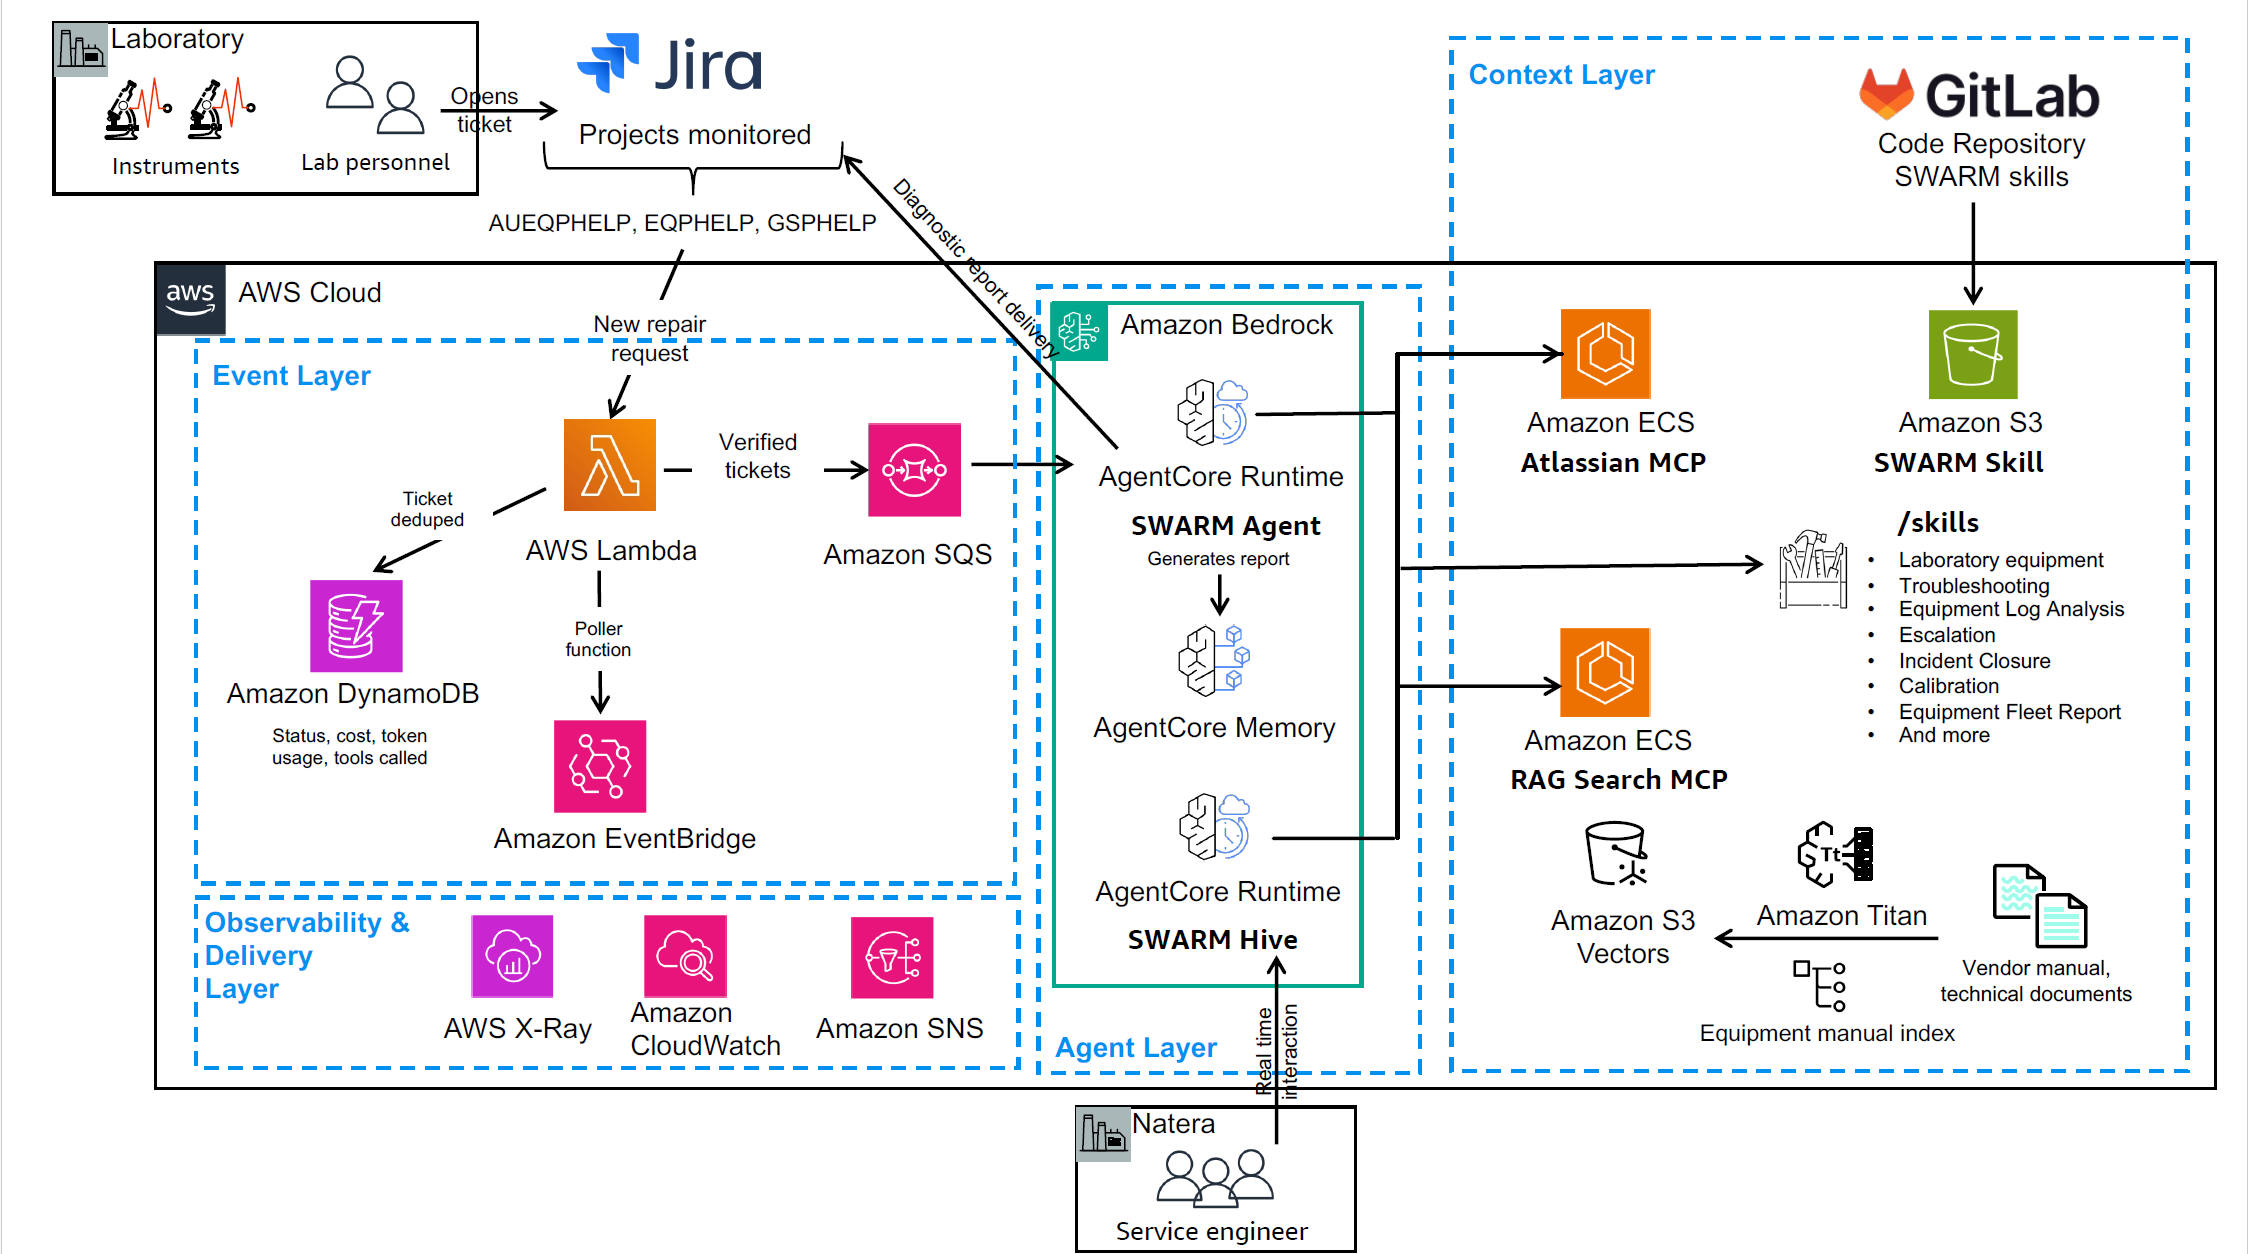
图 1:Natera 的 SWARM 在 Amazon Bedrock AgentCore 上的架构
安全架构
Natera 团队的第一个架构决策是在哪里运行智能体。团队需要一个托管的运行时来处理容器编排、扩缩容和安全性,而无需维护自定义基础设施。他们选择了 Amazon Bedrock AgentCore 的一项功能 AgentCore runtime,因为它在安全的托管环境中托管 swarm-agent 和 swarm-hive,内置身份管理和监控,无需构建和运维自定义的智能体执行层。无论你选择哪种框架,都可以采用这种模式。
团队选择了无密钥的部署模型,因为 SWARM 运行在临床环境中,凭据泄露是不可接受的。OpenID Connect (OIDC) 和 AWS Security Token Service (AWS STS) 生成按部署范围限定的临时凭据,管道中不保存长期密钥。AWS Identity and Access Management (IAM) 在组件层面强制实施最小权限。Amazon Virtual Private Cloud (Amazon VPC) 配合私有子网和 VPC 端点,使流量不经过公共互联网。AWS Secrets Manager 以 30 天为周期自动轮换仅存的少量凭据。
GitLab CI 运行器通过向账户中配置的 IAM 身份提供者出示 OIDC 令牌来完成对 AWS 的身份验证。AWS STS 将该令牌兑换为范围限定在部署角色的短期凭据(管道中不存储长期访问密钥)。有关设置细节,请参阅 IAM OIDC 提供者文档。
下面的示例演示了这一模式:用于 GitLab CI 的 IAM OIDC 信任策略遵循如下结构:
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Principal": {
        "Federated": "arn:aws:iam::ACCOUNT_ID:oidc-provider/gitlab.com"
      },
      "Action": "sts:AssumeRoleWithWebIdentity",
      "Condition": {
        "StringEquals": {
          "gitlab.com:sub": "project_path:YOUR_PROJECT:ref_type:branch:ref:main"
        }
      }
    }
  ]
}
这些基础设施级的安全控制与 SWARM 的数据治理策略协同工作,共同构成了在受监管的临床环境中运行 AI 系统所需的完整合规态势。
合规与数据治理
SWARM 在一份商业伙伴协议(BAA)下运行于符合 HIPAA 要求的 AWS 服务之上,这体现了 Natera 作为临床实验室运营方的义务。每次智能体调用都会记录审计日志(一种可检索的记录,满足数据访问可追溯性要求)。任何可识别患者身份的信息都不会进入向量索引或语言模型。工单中只包含设备和工作流元数据。在 HIPAA 或类似监管框架下构建的团队,应在设计知识库管道之前确认 BAA 覆盖范围和数据隔离要求。
知识库与文档管道构建
Natera 团队早期的原型使用不依赖设备特定元数据的通用检索,结果不稳定,因此他们构建了一个针对技术设备文档定制的自定义文档处理流水线。Amazon Titan Text Embeddings 生成用于语义搜索的向量表示,Amazon Bedrock Knowledge Bases 提供完全托管的检索增强生成(RAG),将文档转换为向量嵌入并以 100 个为一批存储,这个批量大小是在索引吞吐量与 API 速率限制之间权衡后选定的。对于包含表格和图表的高度结构化源文档,投入构建自定义解析流水线而非依赖默认分块,能够在每一次诊断中累积提升准确性。
Amazon Bedrock 服务(包括 Amazon Titan Text Embeddings 和 Amazon Bedrock AgentCore)已在多个 AWS 区域可用。欲了解最新信息,请参阅 Amazon Bedrock 支持的区域和 Amazon Bedrock AgentCore 支持的区域。
Natera 团队使用采用 cl100k_base 编码的 tiktoken 分词器来衡量分块边界。以下示例展示了这种模式,分块配置遵循标准结构:
# Document chunking configuration
chunk_size = 1000  # tokens
chunk_overlap = 150  # tokens
encoding = tiktoken.get_encoding("cl100k_base")
batch_size = 100  # documents per embedding API call
有关批量摄取模式的更多信息,请参阅 Amazon Bedrock Knowledge Bases 文档。
“诊断准确性首先是一个数据质量问题,”Jirau 说,“为得分最低的仪器系列补齐缺失的厂商手册后,准确性从 71% 提升到了 75%,期间没有对模型做任何改动。”
这塑造了 Natera 团队的改进方法:当准确性停滞不前时,团队会先检查数据覆盖情况,然后再进行模型调优,因为厂商文档的缺口是漏诊最常见的原因。该流水线会重新处理新增或更新的文档并刷新向量索引,且不会中断正在运行的操作。
技能库架构
Natera 团队面临一个关键的架构选择:将逻辑直接嵌入智能体提示词中,还是构建一个独立的、带版本管理的技能库。Natera 选择了库的方式,因为它使 SWARM 可审计、可改进。
“当诊断出错时,我们需要定位到某个具体的技能,而不是调试整个系统——这就是我们从一开始就构建带版本管理的技能库的原因,”Jirau 说。
该技能库包含 33 个技能:24 个仪器专用技能覆盖 Natera 支持的全部设备系列,另有 9 个横切工作流技能,可广泛适用于各类工单类型。每个技能都有明确的接口,可独立测试,并按照与整个系统相同的标准进行评估,被视为生产级软件,而非嵌入式的提示词逻辑。
该技能架构遵循清晰的分工:Python 处理确定性任务,例如解析 Jira 字段或格式化 HTML 报告;而大语言模型(LLM)技能处理语言推理,例如解读症状、匹配厂商文档以及生成诊断叙述。对于构建多技能智能体的团队而言,在确定性 Python 技能与 LLM 驱动的推理技能之间做这样的划分,是影响最大的决策之一。
智能体运行时部署
Natera 将诊断工作拆分为两个独立的运行时,因为自主后台分析和交互式工程协作在延迟和上下文需求上有着根本的不同。群体智能体(swarm-agent)为吞吐量而生。它根据设备类型和症状选择技能,查询知识库,并生成一份结构化 HTML 报告,包含主要原因假设、按优先级排序的故障排除步骤以及置信度标签。报告会在几分钟内交付到 Amazon Simple Storage Service (Amazon S3),并关联到 Jira 工单。群体蜂巢(swarm-hive)则专为深度设计:工程师可以进行交互式追问、上传图片并探索替代路径,AgentCore memory——Amazon Bedrock AgentCore 的一项能力会在不同会话间保留每位工程师的对话上下文。
由于 swarm-hive 接受工程师的自由格式输入,提示词会通过 Amazon Bedrock Guardrails 进行内容过滤。
事件驱动的 Jira 集成
SWARM 通过 Amazon EventBridge Scheduler 和一个轮询式的 AWS Lambda 函数(一项响应事件运行代码的无服务器计算服务)与 Jira 集成,避免了 webhook 配置。通过验证的工单进入 Amazon SQS 队列以确保可靠交付。DynamoDB 使用工单 ID 作为分区键并配合基于存活时间(TTL)的过期机制来处理去重,同时存储每次运行的状态、成本和令牌用量等元数据,为评估循环提供数据。这种 EventBridge-to-SQS 模式将智能体运行时与工单系统的可用性解耦。
下面的示例展示了这一模式。去重表采用极简架构,并基于 TTL 过期:
dynamodb.create_table(
    TableName='swarm-deduplication',
    KeySchema=[
        {'AttributeName': 'ticket_id', 'KeyType': 'HASH'}
    ],
    AttributeDefinitions=[
        {'AttributeName': 'ticket_id', 'AttributeType': 'S'}
    ],
    TimeToLiveSpecification={
        'Enabled': True,
        'AttributeName': 'ttl'
    }
)
可观测性设计
包含大量交互组件的智能体系统,如果没有逐次调用的追踪信息,调试会非常困难,因此 Natera 团队在首次生产部署之前就把可观测性构建进了 SWARM。如果你在生产环境中运行智能体,逐次调用追踪是必不可少的:没有它,调试一次错误的诊断就意味着猜测是哪个技能出了问题。
在临床实验室环境中,仪器停机会直接影响患者报告的出具,因此追踪、告警和审计每一次智能体操作的能力并非“锦上添花”,而是监管和运营上的硬性要求。
SWARM 的可观测性栈使用 Amazon CloudWatch 为每次运行捕获可搜索的日志,提供清晰的运行健康状况记录。AWS X-Ray 追踪从工单接入到诊断报告的每一次运行,记录每次工具调用的时间和成本,当某些操作缓慢或昂贵时,团队可以精确定位到具体的技能,而不是靠猜测。Amazon Simple Notification Service 通过电子邮件发送故障告警,而一个 Slack 追踪器让整个团队实时掌握智能体的活动情况。
持续评估方法论
SWARM 采用持续评估循环,而不是在部署时只测试一次,这对于处理不断变化的文档或不断演进的工作流的系统尤其关键。在处理的每张工单上,智能体都会提供根因假设、排障步骤排名以及自评置信度标签。工程师记录他们的发现和修复内容,评估器将每条响应评为准确、部分准确或错误,并按仪器类别细分。团队会审查结果以找出智能体表现不佳之处,应用修复(通常是通过更新知识库),然后重新运行评估集以确认改进。
SWARM 的自评置信度标签与实际准确率呈现出方向性关系。标记为高置信度的工单在 154 个评估案例中达到 74% 的准确率,而中等和低置信度的工单分别在 78 个和 37 个案例中均达到 65% 的准确率。请注意,中等和低置信度目前的准确率相同。低置信度的 37 个案例样本量太小,无法得出有统计意义的结论,Natera 团队预计随着评估数据集的扩大,这两个层级将出现分化。
高置信度与其余层级之间的区分,为工程师在阅读诊断报告时判断每条诊断应赋予多大权重提供了有用的信号。
SWARM 性能
Natera 团队对 SWARM 进行了 524 张支持工单的评估,以建立性能基准。在评估集中的 524 张工单中,有 269 张获得了高、中或低置信度标签,并有相应的工程师验证的解决方案可供对比。其余工单要么被标记为无置信度,要么在分析时缺少经过验证的解决方案。
平均首次响应时间从 17.4 小时降至约 8 分钟(快了约 130 倍)。这些测量数据是在 90 天的生产评估期内从 Jira 工单元数据中收集的。覆盖率同样重要:96.2% 的工单获得了自动化首次响应,而无需工程师启动诊断流程。覆盖率的衡量标准是在工程师审查之前收到 SWARM 生成的诊断报告的传入工单百分比。
在生产环境中构建智能体式 AI 的经验教训
SWARM 中的几项架构决策可直接适用于构建类似系统的团队。
- 将分块大小和重叠视为可调参数。正确的取值取决于源文档的结构。
- 从一开始就在你的技能库中构建可追溯性。当诊断出错时,你希望能够指向某个具体的技能,而不是调试整个系统。
- 如果你的工作负载混合了批处理和交互式查询,请将它们分离到不同的运行时中。
开始使用
亲自尝试这些模式,请访问 AgentCore 示例代码库、在 AWS 上构建智能体式系统或Amazon Bedrock AgentCore 入门指南,了解如何安全地大规模部署智能体。面临机构知识流失、高容量运营工作流或临床合规要求等类似挑战的医疗健康和生命科学组织会发现,Natera 用 SWARM 开发的架构模式为在 AWS 上构建智能体式 AI 系统提供了可复制、经过生产验证的基础。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com