智能体自动化如何构建超越“节省工时”的商业论证
Beyond hours saved: Building the business case for agentic automation
AWS 提出面向智能体自动化的 Agentic Value Model 商业论证框架,指出传统 RPA 时代的“节省工时×人力成本−构建成本”ROI 模型漏掉了大部分价值。
智能体自动化——即能够推理并适应环境以完成任务的软件——正出现在 AI 卓越中心(AI CoE)的路线图中。但公司用来论证自动化投资合理性的标准方法——节省工时乘以人力成本再减去构建成本——本是为机器人流程自动化(RPA)这类基于规则的工具设计的。这一模型忽略了智能体创造的大部分价值。
在本文中,我们介绍一个框架,AI 卓越中心的领导者可以用它来构建一份能够体现智能体自动化全部价值的商业论证。你将了解为什么 RPA 时代的 ROI 模型有所不足、如何衡量它遗漏的价值,以及哪些工作流值得用智能体来自动化。
为什么传统商业论证有所不足
经典的投资回报率(ROI)模型是为稳定、高吞吐、基于规则的工作而构建的:统计交易数、测量分钟数、乘以综合人力费率、减去构建成本。RPA 正是凭借这些条件赢得了自己的地位。
这个模型预设了它所面向的世界。它假设流程是稳定的,因此忽略了流程变化时维护自动化的成本。它假设任务是基于规则的,因此没有为例外情况设置任何条目。它假设这项工作就是全部工作,因此从不计算人工监督的成本。它还把省下的工时视为入账的价值,而腾出的产能往往被积压工作重新填满,从未体现在损益表(P&L)上。在把省下的工时转化为成果的工作上投入不足,正是麦肯锡所说公司一直在犯的错误:成功的 AI 转型遵循“1:3:5 模式”,即“每投入一美元于智能体技术,组织就要在流程再造上花费三美元,在能力建设与推广上花费五美元。然而,大多数公司把这个公式完全颠倒了” (麦肯锡,“Agentic AI change management: Closing the adoption gap”,2026)。
我们假设自动化的价值存在于任务之中,但在智能体自动化中,大部分价值存在于任务之外:判断、例外处理、跨系统协调。真正的收益来自围绕智能体重新设计工作流,而不是把智能体塞进一个一成不变的流程中。
旧模型遗漏的价值维度
更好的商业论证应衡量四个价值维度,外加一个决定这些价值能否体现在损益表上的条件。我们称之为智能体价值模型(Agentic Value Model)。
时间节省。这仍然重要,但智能体把这一维度扩展到固定规则 RPA 难以处理、或只能通过大量例外逻辑来处理的工作上。衡量方式不变,智能体只是把它应用到更大范围的工作上。
例外处理。例外情况承载着大量成本。AWS 指南给出了规划参考范围:纠正一个错误的成本可能是原始交易的 1.5–4 倍,而人为错误可能占运营成本的 2–15% (AWS Prescriptive Guidance,“Assessing your current human-process costs”)。返工倍数用来为团队捕获的例外定价,错误百分比则为漏网的例外定价。仅计人工成本的方案会把两者都忽略掉。
决策质量。智能体可以在大规模应用统一策略的同时记录决策依据,不过一致性和错误率需要持续衡量。正如 AWS 所指出的,“低频高价值的决策或许值得借助智能体来提升决策质量,而非降低成本” (AWS Prescriptive Guidance,《Understanding agentic AI economics》)。在信贷、定价或风险领域,一个更好的决策带来的价值可能远超一年省下的几分钟。
变更韧性与维护经济学。这一点是把双刃剑。脚本很脆弱:当界面或上游系统变更时,它们就会失效,需要有人重建。智能体可以在不重写的情况下吸收一部分变化,但它们把维护工作转移到了评估、提示词、监控和模型运维上,而不是消除维护,且运行智能体本身也有成本。这种论证应把避免的脆弱脚本维护成本与持续的智能体运营成本相抵,因此在频繁变更的流程中,算术可能偏向智能体;而在一成不变的流程中则未必。
统领这四个方面的前提条件是价值实现:每一项收益都需要一个明确的机制,把运营改进转化为经济价值,并有一位负责任的负责人。对于释放的劳动力而言,这意味着把支出减少,或将产能重新投入到具体、可衡量的成果上。
以一个理赔分拣流程为例,采用示意性数字。它每年处理 200,000 件理赔,每件约 12 分钟(不含返工),完全负担的人力成本为每小时 45 美元,基础成本约为 180 万美元。将其中常规的 70% 自动化,可以释放约 28,000 小时,即大约 126 万美元的产能——这还是在计入这些理赔仍需的监督时间之前。大多数论证正是在这里出错的,因为释放工时不等于省钱。只有当公司雇用更少的人,或削减外包、加班或承包商支出时,支出才会真正降低。否则,同样的人仍在工资单上,损益表(P&L)永远看不到那 126 万美元。如果通过自然减员和降低加班费实现了一半,那么论证中应计入约 63 万美元,而非全额。
更常见的结果是将人员重新部署,此时的价值就是他们新产出的成果。对于每一个被释放的小时,要么计入重新部署的价值,要么计入现金成本的削减,两者只取其一。然后再加上纯人力论证看不到的部分。在需要纠正的 8%(16,000 件理赔)中,假设纠正成本是约 9 美元处理成本(12 分钟,每小时 45 美元)的 3.5 倍,则年度纠正风险敞口约为 50.4 万美元。这是基线,不是智能体的价值。价值在于智能体消除的那部分:40% 的降幅,再乘以 75% 的实现系数,得出的建模收益接近 15.1 万美元。这还没算上一个更好的欺诈标记决策的价值。由于 12 分钟的基线不含返工,这一池子与释放的产能不会重叠。如果你的基线包含了返工时间,那么这些节省只能计入一个池子。这样的论证才能得出财务部门可以背书的数字。
为了保持计算的一致性,应按同样的方式衡量每个价值池,并把成本相抵,如下表所示。
| 价值池 | 基线 | 预期增量 | 实现系数 | 负责人 |
| 释放的产能 | 小时数 × 完全负担费率 | 自动化百分比 | 仅在重新投入到具体成果或支出下降时计入 | 运营负责人 |
| 异常与错误成本 | 纠正成本 + 错误损失 | 预期降幅 | 捕获比例 | 质量负责人 |
| 决策质量 | 更优决策的价值 | 每项决策的提升 | 可归因份额 | 领域负责人 |
| 变更韧性与维护经济学 | 脚本的修复成本 + 停机时间 | 避免重建、更快适应变更 | 避免重建的份额,智能体成本在公式中一次性扣除 | 工程负责人 |
把整个事情用一行来表述,将每项收益分配到且仅分配到一个池中,以杜绝重复计算:年度净价值 = 已实现产能价值 + 避免的纠正与错误成本 + 决策结果提升 + 避免的维护与停机成本,减去按年摊销的实施成本,减去智能体运行时、集成、评估、监督、治理与变革管理成本,减去智能体引入的任何新错误造成的损失。智能体未能消除的错误本来就在避免成本项之外,因此不要再次扣减。对于多年期项目,实施成本应在支出当年记账而非按年摊销,收益随采用增长而爬坡,并对各年度现金流折现为净现值(NPV)。
Amazon Quick Automate——Amazon Quick 内的自动化服务——的三个早期部署展示了这些维度如何发挥作用。Kitsa 是一家临床试验站点甄选公司,实现了跨数十万个网站自动提取超过 50 个数据点。它报告了 91% 的成本节省,以及在 96% 覆盖率下数据获取速度提升 96%,并将低置信度的案例转给人工审核(时间节省与异常处理)。正如 Kitsa 联合创始人兼 CTO Rohit Banga 在 AWS Machine Learning Blog 文章中指出的,大规模统一高质量站点数据打破了一个核心瓶颈。这使其 Site Finder Agent 能够以更高的精度权衡更多站点。
dLocal 是一家跨境支付提供商,在受控评估中实现了最多 75% 的商家合规审查自动化。这让专家得以专注于复杂、高风险的案例(决策质量),并增加了针对策略漂移的持续检查——这是定期人工审查会错过的(变更韧性)。dLocal 报告称,过去花费数小时做例行检查的专家,如今把时间用在需要监管判断的案例上。
而 Genpact 跨多个 SAP 系统实现供应链风险自动化,报告将中断影响分析从 2–3 天缩短到几分钟。这正是那种没有任何单一记录系统所能拥有的跨系统协调(时间节省与决策质量)。这些部署没有一个能证明全部四个池,这正是为什么必须分别评估每一项的规模。
一个优先级排序框架
对每个候选工作流在两个轴上打分。第一个轴是任务复杂度,即它需要多少推理、上下文和适应性。第二个轴是决策风险,即出错的代价,它决定了你可以授予多大的自主权。两个轴都来自 AWS 的经济学指南,它们共同构成一个指导委员会可以使用的二维矩阵。
低复杂度、低风险:继续使用 RPA,因为智能体在这里只增加成本而不增加价值。高复杂度、低风险是产能布局,因此应为实现吞吐量和异常吸收而自动化。高复杂度、高风险是决策质量布局,因此应保留人在回路中,并以更好的决策作为依据。低复杂度、高风险是护栏布局,因此应围绕该步骤加固控制,而不是添加它并不需要的推理能力。
一个实用的判断捷径:如果一个人需要跨系统流转并在每一步解读模糊的上下文,就应该评估智能体方案。如果流程路径始终是确定性的,RPA 可能仍然更便宜。使用智能体价值模型来决定衡量什么,并使用这个矩阵来决定优先处理什么。
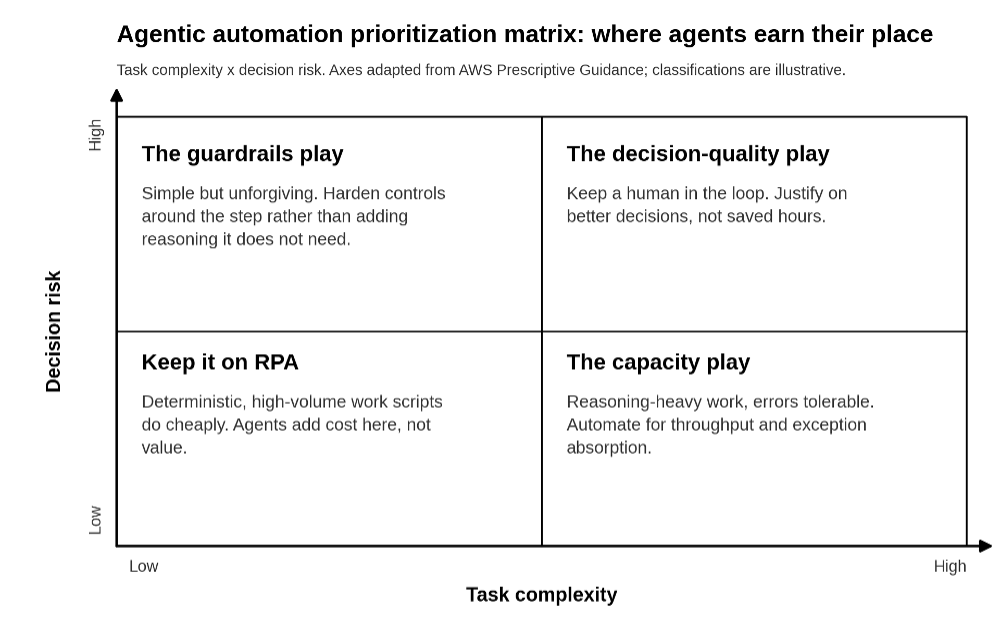
图 1:智能体自动化优先级矩阵,坐标轴改编自 AWS Prescriptive Guidance,分类仅为示意
向管理层论证投入的必要性
将投资呈现为一系列工作流的组合,而不是单一项目。McKinsey 的研究说明了为什么孤立的试点会停滞:近三分之二的企业已经试用过智能体,但只有不到 10% 的企业将其规模化并转化为实际价值 (McKinsey, “Scaling agentic AI with data transformations,” 2026)。价值来自于明确成果、将智能体深度嵌入核心工作流,并围绕它们重新设计运营模式。向管理层提交三到五个已确定优先级的领域,每个领域都附有其四维度论证。
能赢得持怀疑态度的 CFO 认可的关键是一套止损规则:为投资设置阶段性规划,明确盈亏平衡目标和预定义的停止点,对表现不佳的智能体停止注资。将每个领域与管理层已经在追踪的关键绩效指标(KPI)挂钩,无论是服务成本、周期时间、净推荐值还是合规风险。同时把治理视为加速推进的手段:有边界的自主性、在高风险处设置监督以及内建可审计性,使你能够随着证据的积累逐步扩大智能体的自主权限。
开始使用 Amazon Quick
Amazon Quick 将研究、商业智能和自动化整合到一个智能体体验中。借助其自动化服务 Quick Automate,团队可以在企业工作流中编排 UI 操作、API 调用和人工审核。这会产生案例级别的执行数据,卓越中心(CoE)可以将其与运营和财务 KPI 相结合,在价值实现的同时进行衡量。
这种衡量方式能把首个项目转变为一个组合。在寻找四个价值池之后,你往往会发现它们存在于那些由人在系统之间流转、解读上下文并手动处理异常的场景中。将一个工作流投入生产,为其价值池和运营成本建立基线,指定负责人,并证明这个数字。随后,随着每个新工作流报告结果,组合层面的论证便会不断累积。
结论
问题在于智能体自动化能在哪些你现有工具无法企及之处创造价值,以及如何在投入之前证明这一点。本文所描述的规范化方法,评估每个价值池的规模、应用符合实际的实现系数并设定止损规则,正是让这种证明可信的关键。在一个工作流上证明了价值的团队,可以用实测结果而非预测来为下一个项目提供资金。至于底层经济学,一个很好的起点是 AWS Prescriptive Guidance on agentic AI economics。
关于作者
来源:AWS Machine Learning Blog · aws.amazon.com