基于 SageMaker SDK v3 的边缘侧计算机视觉模型全生命周期管理方案
Fleet-wide computer vision lifecycle at the edge with SageMaker SDK v3
AWS 更新了 2023 年边缘视觉质检 MLOps 系列方案,适配 Amazon SageMaker Python SDK v3,并用 SageMaker Neo 替代已弃用的 Edge Manager 做边缘优化。
当质量检测的概念验证成功后,全车队级计算机视觉模型生命周期管理的问题就会立刻显现。一台摄像头和一个模型运行良好。然后工厂要求在 40 条产线上实现同样的效果,每条产线有多台摄像头,而每台摄像头看到的世界都不同。每台摄像头的角度不同、同一不锈钢表面的反光不同,而且环境光也随哪个隔间门打开而变化。在我们参与过的生产部署中,一个用汇集视频训练的单一模型,其表现不足以替代每台摄像头单独的模型,因此每台摄像头最终都有自己的微调模型。现在真正的问题不再是训练好一个模型,而是在没有人工逐个介入的情况下,训练、评估、版本化并发布成千上万个模型。
本文将 2023 年系列文章 Build an end-to-end MLOps pipeline for visual quality inspection at the edge 中介绍的模式更新到当前的 Amazon SageMaker Python SDK v3。它用 Amazon SageMaker Neo 替代已弃用的 Amazon SageMaker Edge Manager 来进行边缘优化。我演示了一个双分支 Amazon SageMaker Pipeline,为每台摄像头训练异常检测器和缺陷分类器,并通过质量门禁阻止表现不佳的模型。流水线内的 SageMaker Neo 编译步骤确保每个注册模型都附带设备优化的产物,AWS Step Functions 编排层则对车队训练进行节奏控制。你使用 AWS Cloud Development Kit (AWS CDK) 部署所有内容,在合成数据上完整运行一次流水线的计算成本约为 0.07 美元。
完整示例可在 aws-samples GitHub 存储库中获取。
解决方案概览
下图展示了该示例的全车队模型生命周期。编排层将重新训练请求排队,并限制并发工作量。每台摄像头的训练流水线负责准备数据、训练和评估异常检测器与分类器,并为边缘设备生成带版本的模型产物。
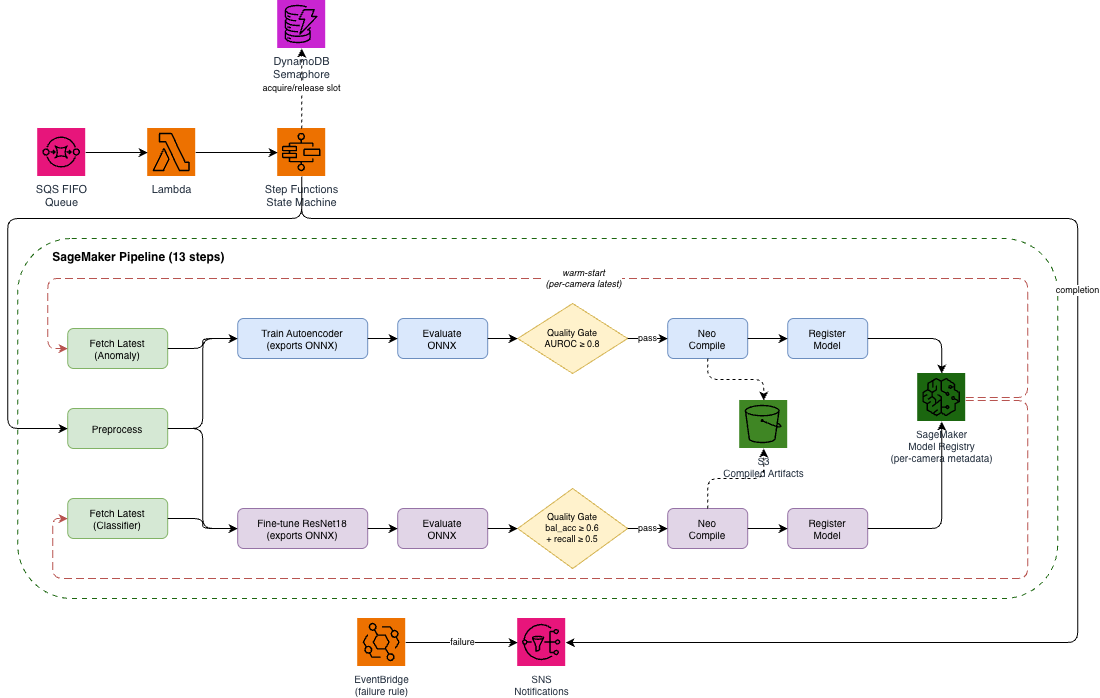
图 1:解决方案架构
训练部分是一个单一的 SageMaker Pipeline,以摄像头为参数,每次执行运行 13 个步骤。三个入口步骤并行运行:Preprocess、Fetch Latest Anomaly 和 Fetch Latest Classifier。流水线对该摄像头的图像进行预处理,并为每个分支获取该摄像头最近获批的模型,然后训练两个模型。第一个是小型卷积自编码器,用于学习正常产品的外观,并通过重建误差标记异常。第二个是经过微调以确认缺陷的 ResNet18 分类器。每个分支将其模型导出为 ONNX,用留出数据评估导出的产物,并通过质量门禁。通过门禁后,模型会用 SageMaker Neo 针对配置的边缘目标进行编译,然后才注册到 SageMaker Model Registry。因此,每个获批的包都带有设备就绪的编译产物。包以摄像头 ID 作为元数据,每个分支的 warm-start 获取会根据它进行筛选,因此重新训练总是从该摄像头自身的历史记录恢复。
编排部分负责控制机群的节奏。重新训练请求进入 Amazon Simple Queue Service (Amazon SQS) FIFO 队列,一个 AWS Lambda 函数为每个请求启动一次 Step Functions 执行。每次执行在启动其管道之前,都会通过 DynamoDB 信号量获取一个槽位,因此突发的请求会以稳定的速率被消化,而不是同时全部启动。完成事件发布到 Amazon Simple Notification Service (Amazon SNS),运维故障则通过一条 Amazon EventBridge 规则到达同一主题,并保留原始错误信息。
系统的输出是经过版本管理、带质量门控的、按摄像头划分的模型工件。Model Registry 保存可移植的 ONNX 模型,S3 保存该模型经 Neo 编译后的构建产物——这是一个由 DLR 运行时加载(而非 ONNX)的针对设备优化的共享库。两者都已就绪,可适配您工厂使用的任何交付机制。
先决条件
要部署该示例,您需要具备以下条件:
- 一个有权创建 AWS Identity and Access Management (IAM) 角色的 AWS 账户。
- 一个 Amazon Simple Storage Service (Amazon S3) 存储桶。
- 一个 Amazon Elastic Container Registry (Amazon ECR) 存储库。
- 堆栈中的 SageMaker AI、AWS Step Functions、AWS Lambda、Amazon Simple Queue Service (Amazon SQS)、Amazon Simple Notification Service (Amazon SNS)、Amazon EventBridge 和 Amazon DynamoDB 资源。
- Python 3.10、3.11 或 3.12,Docker。
- AWS CDK CLI 2.1131.0 或更高版本。
较早的 CLI 版本在与最新版本的 aws-cdk-lib 对接时会因 cloud assembly 架构不匹配而失败。无需提高服务配额。编排层默认一次最多允许五个管道执行,这使并发的 SageMaker 训练作业保持在标准账户配额之内。
如果您要部署到的 AWS 区域不是 CLI 的默认区域,请在部署命令本身上(而不是在 shell 配置文件中)设置 AWS_REGION、AWS_DEFAULT_REGION 和 CDK_DEFAULT_REGION 这三个变量,例如 AWS_REGION=us-east-2 AWS_DEFAULT_REGION=us-east-2 CDK_DEFAULT_REGION=us-east-2 cdk deploy --all。CDK CLI、Boto3 和 AWS Command Line Interface (AWS CLI) 从彼此重叠但不完全相同的变量集合中解析区域,不一致会导致令人困惑的部分部署。在命令前加上前缀只会在该次调用中设置这三个变量,因此您自己的默认区域保持不变。
使用 SDK v3 定义训练管道
本节中的代码摘自存储库中的 CDK 应用程序,而非独立脚本,它在 cdk deploy 期间(即堆栈合成管道定义时)运行。环境设置和部署命令稍后在“部署并运行示例”一节中给出。SDK v3 将 SageMaker Python SDK 重组为模块化包,导入语句展示了这个库的新形态:
from sagemaker.train import ModelTrainer
from sagemaker.train.configs import InputData, Compute, OutputDataConfig
from sagemaker.core.training.configs import MetricDefinition
from sagemaker.serve.model_builder import ModelBuilder
from sagemaker.mlops.workflow.pipeline import Pipeline
from sagemaker.mlops.workflow.steps import ProcessingStep, TrainingStep
from sagemaker.mlops.workflow.model_step import ModelStep
from sagemaker.mlops.workflow.condition_step import ConditionStep
from sagemaker.core.workflow.conditions import ConditionGreaterThanOrEqualTo
from sagemaker.core.workflow.functions import JsonGet
安装 sagemaker>=3.0.0,<4 会将 sagemaker-core、sagemaker-train、sagemaker-serve 和 sagemaker-mlops 作为独立的包一并引入。在 v2 中分散在 Estimator 构造函数参数中的训练配置,现在以类型化的配置对象形式传递给 ModelTrainer。以下是异常检测分支的训练器,逐字取自该示例:
anomalib_trainer = ModelTrainer(
    training_image=custom_training_image_uri,
    compute=Compute(
        instance_type=training_instance_type.to_string(),
        instance_count=1,
    ),
    base_job_name="cv-pipeline-anomalib-train",
    sagemaker_session=pipeline_session,
    role=role_arn,
    hyperparameters={
        "program": "train_anomalib.py",
        "model_name": "autoencoder",
        "image_size": "256",
        "num_epochs": "3",
        "batch_size": "16",
        "learning_rate": "0.001",
    },
    input_data_config=anomalib_input_data,
    output_data_config=OutputDataConfig(
        s3_output_path=run_prefix("anomalib-training")
    ),
).with_metric_definitions(
    [
        MetricDefinition(
            name="image_auroc",
            regex=r"validation:image_auroc=([0-9]*\.?[0-9]+)",
        ),
    ]
)
anomalib_input_data 从上游步骤属性接入四个通道(train、validation、test、pretrained_model),而 run_prefix 将每个 S3 路径限定到管道执行 ID,使并发的机群运行永不冲突。两者都在存储库中。
当流水线位于 CDK 应用程序内部时,有两个 v3 行为会产生影响,而它们都没有在变更日志中被标记为破坏性变更。第一,SDK v3 在构建流水线定义时会针对实时 IAM 校验流水线的执行角色。这种校验发生在合成阶段而非执行阶段。CDK 应用无法在一次部署中同时创建该角色和流水线,因为 SDK 校验时角色尚不存在。这与 cdk bootstrap 是两回事——后者按账户和区域一次性预置 CDK 工具包资源,你的账户可能已经执行过。示例自身的两阶段部署由一个恰好与该名称相同的上下文标志驱动。第一阶段使用 -c bootstrap=true 创建角色、存储桶和 ECR 仓库,第二阶段则针对现已存在的角色合成流水线。嵌入在流水线定义中的角色 Amazon Resource Name(ARN)也必须是具体的字符串,而不能是未解析的 CDK 令牌。
第二,v3 的角色校验器在模拟 ECR 拉取权限时不带资源 ARN,因此即使一个仅限定于单个 ECR 仓库的执行角色在运行时可以正常工作,也无法通过校验。正是出于这个原因,示例中的角色携带了范围更宽的 ECR 授权。
最后,示例采用了 v3 的一个习惯做法:使用 PipelineSession(default_bucket=your_bucket) 构建流水线,将 SDK 托管的上传内容(如步骤代码)路由到流水线自己的存储桶中,这样所有工件都集中在一处,执行角色的权限也只需覆盖单个存储桶。(为角色授予对 SDK 默认存储桶的访问权限也可以,但这种方式更整洁。)
与缺陷数据特性相匹配的质量门控
每个训练完成的模型在注册之前都会经过评估,而评估针对的是导出的 ONNX 工件而非内存中的 PyTorch 模型。这一区别很重要:你进行门控的工件就是你交付的工件,因此导出环节的问题绝不可能让一个有缺陷的模型混过一次看似健康的训练流程。
异常分支以至少 0.8 的 AUROC 作为门控条件。分类分支则同时以两项指标作为门控条件,而指标的选择由缺陷数据的本质特征决定:严重的类别不平衡。在此示例中,大约 90% 的图像是良品,这在生产线上是符合实际的。面对这种分布,普通准确率毫无意义,因为一个把每张图像都预测为“良品”的模型能得到约 0.9 的分数,却抓不到任何缺陷。平衡准确率(即各类别召回率的均值)可以修正这一点,但它也有自身的盲区:一个对良品具有完美召回率、而对缺陷仅有 20% 召回率的模型仍能得到 (1.0 + 0.2) / 2 = 0.6 的分数。因此该门控要求同时满足平衡准确率不低于 0.6 且缺陷召回率不低于 0.5:
step_check_classifier = ConditionStep(
    name="CheckClassifierQuality",
    conditions=[
        ConditionGreaterThanOrEqualTo(
            left=JsonGet(
                step_name=step_eval_classifier.name,
                property_file="evaluation",
                json_path="balanced_accuracy",
            ),
            right=min_accuracy,
        ),
        ConditionGreaterThanOrEqualTo(
            left=JsonGet(
                step_name=step_eval_classifier.name,
                property_file="evaluation",
                json_path="defect_recall",
            ),
            right=min_defect_recall,
        ),
    ],
    if_steps=[step_compile_classifier, step_register_classifier],
    else_steps=[step_fail_classifier],
    depends_on=[step_eval_classifier],
)
一个 ConditionStep 会对其条件做 AND 运算,因此两个条件都必须通过。这些阈值是流水线参数,可以在每次执行时调整而无需重新部署。如果门控失败,一个 FailStep 会将该执行标记为失败,且该分支的模型永远不会进入注册表(两个分支独立进行门控,因此另一分支的模型仍可能注册成功)。该摄像头继续使用之前已获批的模型。
训练代码从另一端解决同样的失衡问题。分类器是一个经过微调的 resnet18,带有 ImageNet 权重和一个二分类头。在单台相机的数据集规模下,正是对预训练权重的微调使模型不会坍缩到多数类上。训练代码使用 WeightedRandomSampler 按类频率的倒数来平衡训练批次,而损失函数本身不加权重。将加权损失与加权采样结合会导致向少数类过度矫正。
使用 SageMaker Neo 在流水线内为边缘设备编译
请注意前面代码中网关的 if_steps:通过网关之后,编译首先运行,注册则依赖于编译。两个训练脚本都以动态批次轴导出 ONNX。质量网关在 ONNX Runtime 下对导出的制品评分,然后由一个 CompileAnomalibNeo 或 CompileClassifierNeo 步骤把通过网关的制品交给 SageMaker Neo。不变式是:先网关,再编译,后注册。一个模型只有同时能为机群的边缘目标完成编译,才会成为 Approved 包,因此注册表绝不会宣传设备无法运行的模型。
编译步骤封装了三个易出错的细节。Neo 要求输入的 tar 包只包含模型文件,但训练作业输出的 model.tar.gz 会在 ONNX 模型之外附带检查点和指标。该步骤首先重新打包一个仅含 ONNX 的 tar 包。Neo 还要求具体的输入形状,而导出声明的却是动态批次轴,因此在编译请求中固定了批次大小为 1。另外,由于流水线步骤可能重试,编译作业名称会从执行 ID 确定性地派生,因此重试时会恢复轮询已启动的作业,而不是产生孤立的作业。
编译目标是一个流水线参数:NeoTargetDevice 选择一个命名的设备,例如 jetson_xavier 或 rasp4b,其默认值针对 NeoTargetOs/NeoTargetArch 平台编译,默认为 LINUX/X86_64。编译后的包包含优化后的 compiled.so 以及用于加载它的 DLR runtime。默认输出可在任何 x86_64 Linux 主机上运行,因此你可以在确定设备专用目标之前先进行验证。编译本身不产生费用。你只需为驱动它的处理实例以及输出的 S3 存储付费。对于稍后无需重新训练、仅为已注册模型编译其他设备类型的需求,该仓库包含一个临时脚本,可针对 Model Registry 运行相同的流程。
Model Registry 中的单相机模型
每个分支注册到各自的模型包组,且每个包都携带相机 ID 及其评估指标。以下为示例(省略了指标相关的接线代码):
classifier_model_builder = ModelBuilder(
    s3_model_data_url=classifier_model_data,
    image_uri=custom_training_image_uri,
    sagemaker_session=pipeline_session,
    role_arn=role_arn,
)
step_register_classifier = ModelStep(
    name="RegisterClassifierModel",
    depends_on=[step_compile_classifier],
    step_args=classifier_model_builder.register(
        model_package_group_name="sm1k-classifier-model-group",
        approval_status="Approved",
        model_metrics=classifier_metrics,
        customer_metadata_properties={"CameraId": camera_id},
    ),
)
customer_metadata_properties 中的相机标识将两个共享的包组转化为一个机群目录。所有相机的包都存放在相同的组中,单相机的历史记录可通过按元数据过滤来恢复。每个分支都有一个获取步骤,按从新到旧的顺序分页遍历已批准的包,直到找到请求相机的最新模型,因为 ListModelPackages 无法在服务端按客户元数据进行过滤。在相机首次运行时,获取步骤找不到任何内容,训练便回退到其冷启动初始化(分类器使用 ImageNet 权重,自编码器使用随机初始化)。之后的每次运行都从该相机自己此前的模型恢复,这正是使整个机群能够进行频繁、低成本、增量式再训练的关键所在。
请注意这些注册表条目是什么、不是什么:它们编目的是经过版本化、质量门禁的制品,但其容器引用的是训练镜像,不提供任何推理端点。它们面向的是一种车队工作流——由下游系统拉取制品并分发到设备,而不是用于 CreateEndpoint。
编排车队训练请求
每个 AWS 账户对并发的 SageMaker 训练任务都有服务配额,而这里的每次流水线执行都会启动多个任务,因此车队再训练需要节奏控制。必须有某种机制防止一波 500 个请求变成 500 个同时启动的流水线。该示例使用信号量——一个记录可用槽位的计数器,就像一个有五个车位停车场。在 Step Functions 状态机启动流水线之前,它会通过原子性地递增 DynamoDB 中的一个计数器来占用一个槽位,并附带一个条件:一旦达到上限就拒绝递增:
acquire_semaphore = tasks.DynamoUpdateItem(
    self, "AcquireSemaphore",
    table=semaphore_table,
    key={"LockName": tasks.DynamoAttributeValue.from_string("pipeline-concurrency")},
    update_expression="SET ActiveCount = if_not_exists(ActiveCount, :zero) + :one",
    condition_expression="attribute_not_exists(ActiveCount) OR ActiveCount < :limit",
)
如果所有槽位都被占用,该执行会等待并重试。当它的流水线完成时,它会递减计数器以释放槽位。有一个细节值得借鉴到你自己的设计中。DynamoDB 条件表达式在单次原子操作中强制执行上限,而不是由状态机先读取计数器再做决定——后者会在读和写之间留下竞态窗口。该仓库实现了其余的运维加固,包括在每条失败路径上释放槽位,以及通过 Amazon EventBridge 将失败的执行转发到 Amazon SNS。其 README 介绍了如何设定等待边界的大小。
上限五是一个堆栈参数,设置得较低,以便示例能在任何标准账户中部署和运行而无需申请提升配额。你可以根据账户的训练任务配额支持的情况进行调整。超出单个账户配额之后,车队训练的扩展是另一个主题。标准手段包括提升服务配额、将训练分散到不同实例类型或区域,以及将车队分布在多个账户中。你也可以将积压任务保存在 SQS 中,仅在有空余容量时才放行工作。这些选择取决于你的车队规模和形态。该示例为你提供了可扩展的可用骨架。
部署并运行示例
仓库 README 中的演练是权威版本。下面的简短流程从干净的代码检出开始,并在首次部署前设置环境:
git clone https://github.com/aws-samples/sample-sagemaker-fleet-cv-pipeline
cd sample-sagemaker-fleet-cv-pipeline && python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cdk bootstrap                                           # once per account/region
cdk deploy SageMakerCVPipelineStack -c bootstrap=true   # roles, bucket, ECR
cdk deploy --all                                        # pipeline + orchestration
./scripts/push_ecr_image.sh                             # build and push training image
默认情况下,流水线会生成合成的生产线图像,因此无需数据集和数据审批即可对整个系统进行端到端验证。一次完整运行会执行全部 13 个步骤(包括两次 Neo 编译),耗时约 15 分钟,计费的 ml.m5.xlarge 时间成本约为 $0.07(美国东部(俄亥俄)区域 (us-east-2),2026 年 7 月,按需价格)。编排资源在示例规模下每月合计成本远低于 $0.10。
为了在真实图像上运行该流水线,仓库中包含一个用于下载 BCCD 数据集的下载器。该数据集包含 364 张带标注的血涂片显微镜图像,最初在 GitHub 上开源,并以 MIT 许可证重新组织为 Pascal VOC 格式。同一数据集也由 Roboflow 以公有领域形式分发。该脚本将血小板的存在映射为缺陷类别,可选择按相机拆分图像以模拟设备群,并将训练压缩包上传到流水线存储桶。配套的笔记本在真实数据上运行完整流水线,并对正常样本和异常样本进行并排的 ONNX 推理。将血小板视为缺陷只是对制造缺陷分布的一个说明性替代,并非临床结论。
清理
模型包是在流水线运行时创建的,因此 AWS CloudFormation 无法删除它们。请先使用 AWS CLI 将其移除,然后使用 cdk destroy --all -c bootstrap=true --force 销毁堆栈。README 中列出了确切的命令。
结论
在这篇文章中,我展示了一个基于 SageMaker SDK v3 的可运行参考架构,用于设备群规模的计算机视觉全生命周期。该架构包含一个双分支训练流水线,其中每个模型都要在其导出的 ONNX 工件上通过质量门控,并使用 SageMaker Neo 编译,然后才会注册。Model Registry 布局利用相机元数据,将共享的包组转换为可按相机热启动的历史记录,而 Step Functions 编排层则在账户配额内控制设备群训练的节奏。对于其需求可以通过 Amazon Lookout for Vision 等托管选项满足的团队而言,那是更简单的路径。这一模式针对的是托管选项无法覆盖的按相机、设备群规模的约束。其设计规则可以推广到计算机视觉之外:以平衡准确率加上少数类召回率而非准确率作为门控标准,评估并编译你实际交付的工件,并让操作失败发出通知而不是静默终止。
该示例可在几分钟内部署完成,一次完整的验证运行大约只需 7 美分的计算成本,因此一个低成本的下一步操作是克隆该仓库并运行它。之后,您可以将 BCCD 下载器指向真实的存储桶,根据自己的硬件设置 NeoTargetDevice,或者根据您的设备群调整编排边界。对于 SDK v3 迁移本身,SageMaker Python SDK 文档以及宣布新 SDK 的两篇系列文章是我全程参阅的资料。
如果您希望获得将此模式应用到您的生产环境的帮助,请联系您的 AWS 客户团队。
关于作者
来源: AWS Machine Learning Blog · aws.amazon.com